
San Jose toppar USA:s städer mest exponerade för AI
ÄVEN: Kinesiska hackare använder DeepSeek, Thomsons AI värd 40 miljoner dollar
Välkommen till Guru99 AI-rapport!
Topp berättelse: Var du bor kan avgöra hur mycket AI omformar ditt arbete. Vi analyserar också en inhemsk juridisk modell värd 40 miljoner dollar, ett anonymt kodningsverktyg som utvecklare inte kan sluta använda, och varför billig öppen AI just blivit en säkerhetsproblematik. Låt oss gräva djupare.
🗺️ Var du bor formar hur mycket AI-förändringar fungerar
Kort nyhetsmeddelande:
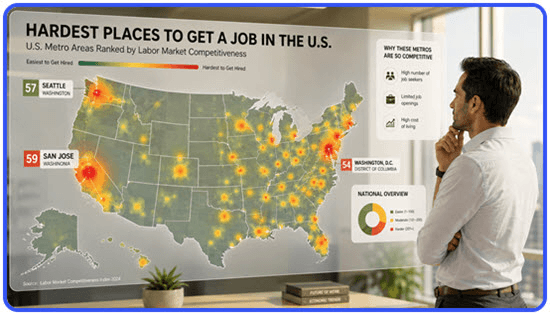
Ocuco-landskapet Anställningslabb at Verkligen scored 386 Amerikanska storstadsområden om deras exponering för AI – hur mycket av den lokala arbetskraften som genererar AI skulle kunna omforma. Tekniktunga storstadsområden hamnar i toppen och praktiskt engagerade ekonomier i botten, men exponering betyder inte förlorade jobb.
- San Jose tar förstaplatsen i den nya exponeringsrankningen på storstadsnivå med 59, Följt av Seattle (57), Washington, DC (54), San Francisco (53), Och Austin (52).
- Genomsnittet över 386 tunnelbanor är 44, på en skala som går ungefär 40 till 60.
- Två försvarsnav bland de 10 bästa — Lexington Park, Maryland och Huntsville, Alabama — båda med stor ingenjörskonst.
- De lägsta poängen går till storstäder som bygger på tillverkning, hälso- och sjukvård och detaljhandel.
- 55% av amerikanska vuxna under 30 är nu mer bekymrad än entusiastisk över AI.
💡 Varför ska du bry dig?
Hög exponering innebär att dina arbetsuppgifter kan komma att förändras, inte att de kommer att försvinna. Indeeds egen kvalifikation spelar roll här: det är upp till lokala arbetsgivare om dessa förändringar leder till uppsägningar eller till bättre verktyg.
🔓 Kinesiska hackare Doubled Attacker med billig öppenvikts-AI

Kort nyhetsmeddelande:
Taiwanesiskt hotinformationsföretag TeamT5 berättade för Bloomberg att kinesiska statskopplade hackergrupper har mer än fördubblat sina attacker sedan de integrerade öppen källkods-AI i sin verksamhet. Deras verktyg är inte en banbrytande modell utan DeepSeek — billig, anpassningsbar och endast lätt skyddad.
- Grimfengxi skrev exploitkod med DeepSeekMedan Teleboyi drog 1 000 IP-adresser och mappade målets domäner.
- En tredje grupp, Huapi, attackerade ett taiwanesiskt företags e-postsystem med hjälp av en modell som forskarna tror är DeepSeek.
- Kostnaden är den främsta drivkraften: DeepSeek V4 springer omkring $0.87 per miljon utgångstokens, medan Moonskottets Kimi K3 kostnader $15.
- TeamT5 såg inga incidenter med Kimi K3 — kapabel och öppen vikt, men för dyr att köra i stor skala. Yahoo
- Västerländska modeller dyker fortfarande upp – en grupp sprang Claude Code genom ett taiwanesiskt nätverk genom att utge sig för att vara auktoriserade testare.
💡 Varför ska du bry dig?
Inbyggda skyddsräcken erbjuder ett riktigt skydd; de som du kan ladda ner och ta bort gör det inte. AISI ser hur frontmodeller blir skarpare, kan det faktiskt vara svårare problemet att hantera den lägre prisklassen.
🥷 Ingen vet vem som byggde denna gratis kodningsmodell

Kort nyhetsmeddelande:
Ox Alpha dök upp på OpenRouter den 20 augusti utan företagsnamn och pris, och dess förmåga att bearbeta en miljon tokens samtidigt fick utvecklare att strömma till. Fem dagar senare har ingen gjort anspråk på det, och bevisen pekar på Z.ai i Kina.
- Tills vidare, 1,048,576 kontextuella tecken, 131,072 tokens för maximal utdata, plus text-, bild- och videoinmatning är alla gratis.
- Det virala 80% DeepSWE siffran kom just från 10 of 113 uppgifter; ytterligare gemenskap driver mark nära 63%.
- Ox Alpha är inte listad på DeepSWE:s officiell styrelseDär Fabel 5 sitta satt 70%.
- ÖppetCode påstår sig ha en kapacitet på 100 biljoner tokens per dag – en siffra som är overifierad och har väckt öppen skepsis.
- Patrick Collison, vars Rand förvärvar ÖppnaRouter, kallade det "väldigt imponerande".
💡 Varför ska du bry dig?
Kodningshjälp blev precis gratis i en vecka. Nackdelen är att en anonym leverantör sparar dina prompts – okej för sidoprojekt, men inte för proprietär kod.
⚖️ Thomson Reuters byggde sin egen AI för 40 miljoner dollar

Kort nyhetsmeddelande:
Thomson Reuters har släppt Thomson, sin första interna AI-modell. Det är byggt på Alibabas Qwen med öppen källkod och utbildad under årtionden av Westlaw och Reuters material. Målet: sluta hyra AI från Antropisk och OpenAI och börja äga den.
- Räkningen kom till $ 40 miljoner över två år för personal och databehandling. Den sista träningsrundan kosta ungefär $450,000.
- Enligt sina egna måttstockar, Thomson tändstickor Claude Opus 4.8 och överträffar GPT-5.5, Claude Sonnet 5och Gemini 3.1 Pro.
- En oberoende granskning hittade luckor: Thomson snubblade på Juridisk bänk, resonemang och kodning, och behövde extra beräkningsförmåga under testet.
- Dess första jobb var dokumentgranskning på Juridisk advokat — en produkt som fortfarande huvudsakligen fungerar på Claude.
- En mindre öppenviktsversion är på väg till Kramande ansikte, men endast för akademiska institutioner och icke-kommersiellt bruk.
💡 Varför ska du bry dig?
Billigare juridisk AI skulle kunna leda till billigare juridiska tjänster – och om en modell på 40 miljoner dollar kan matcha de som kostar en miljard dollar, kan andra datarika företag följa samma väg.
🏭 Oumi låter företag äga sin AI, inte hyra den

Kort nyhetsmeddelande:
Seattle-baserad start Oumi vill att företag ska äga sin AI snarare än att hyra den från stora laboratorier. Den 11 augusti lanserade de en Sammansatt AI-fabrik den där bygger anpassade modeller från en prompt, distribuerar dem med ett enda klick och fortsätter att förbättra dem på dina egna data.
- Ett klick driftsätter Grafikkort som skalar automatiskt med trafik och sjunker till noll vid inaktivitet, vilket minskar kostnader för onödiga datoranvändning.
- Modellerna omskola automatiskt på liveproduktionsdata, och förvandlar verkliga misslyckanden till nya träningssignaler.
- A ett offentligt kommandoradsverktyg byggt för agenter låter kodningsagenter köra utbildning och utvärdering precis som en utvecklare skulle göra.
- Allting — den modellvikter, träningsdata och byggrecept — kan exporteras under Apache 2.0-licensen.
- I Oumis egen fallstudie, en de fem största amerikanska bankerna använde det för att modernisera 100 miljoner rader äldre kod.
💡 Varför ska du bry dig?
För företag är det verkliga problemet kontroll: billigare, mer specialiserade modeller låter känslig data förbli lokal och förbättras över tid. Nackdelen är att du behöver fortfarande ren, välorganiserad data för att något av det ska fungera.
🤖 Metas nya öppna AI körs direkt på din enhet

Kort nyhetsmeddelande:
Meta är tillbaka i loppet för öppna modeller. Dess nya Muse Glimmer är en agentmodell med 30 miljarder parametrar som körs på en enda konsumentklassad GPU – inget moln krävs. Lanseringen kom med ett manifest från Mark Zuckerberg som argumenterade för att AI borde ge alla kraft, inte bara en handfull labb.
- Det har 30 miljarder parametrar ändå körs lokalt på en konsumentklassad GPU under den permissiva Apache 2.0 licens.
- Det är Metas första helt öppna utgåva sedan dess avbröt sin Llama-linje i april och lanserade den egenutvecklade Muse Spark.
- På Metas egna riktmärken slår den konkurrenter i samma storlek när det gäller användning av agentverktyg, men den spårar Qwen i datoranvändning och terminaluppgifter.
- Zuckerbergs essä, "Framtiden är för alla" hävdar att den största faran är att koncentrera superintelligens till ett fåtal institutioner.
- Meta planerar också att släppa öppen källkodsversion av dess Muse Spark 1.2 under de kommande veckorna och fördjupa sin satsning på öppen källkod.
💡 Varför ska du bry dig?
Avancerade AI-agenter kan köras privat på din egen enhet – ingen prenumeration och ingen data skickas till molnet. Väg bara Metas "AI för alla" pitch mot hur mycket AI-kraft den samlar.


Hej! Jag är Krishna Rungta
Grundare av Guru99.com, Chefredaktör och teknikexpert
Vidarebefordrades detta e-postmeddelande till dig? Registrera dig gratis här.
