
Was ist SLT in SAP HANA? Replikation & Konfiguration
 Maurer Garcia
⚡ Intelligente Zusammenfassung
SLT, die SAP Landscape Transformation Replication Server lädt und repliziert Daten in SAP HANA in Echtzeit oder nach einem Zeitplan. Ein triggerbasierter Ansatz erfasst Änderungen von SAP und nicht-SAP Quellen gleichermaßen.
Was ist SLT (SAP Replikation der Landschaftstransformation)?
SLT ist ein ETL-Tool, mit dem Sie Daten in Echtzeit laden und replizieren oder Daten planen können von SAP Quellsystem oder Nicht SAP System in SAP HANA-Datenbank.
SAP Der SLT-Server verwendet einen triggerbasierten Replikationsansatz, um Daten vom Quellsystem zum Zielsystem zu übertragen.
Der SLT-Server kann auf einem separaten System oder auf SAP Das ECC-System.
Der Vorteil des SLT-Systems ist wie folgt:
- Ermöglicht die Datenreplikation in Echtzeit oder nach Zeitplan.
- Während der Datenreplikation in Echtzeit können wir Daten migrieren in SAP HANA-Format.
- SLT-Griffe Cluster und Billardtische.
- Dies unterstützt die automatische Nicht-Unicode- und Unicode-Konvertierung während des Ladens/der Replikation. (Unicode ist ein Zeichenkodierungssystem, das ASCII ähnelt. Nicht-Unicode ist ein Kodierungssystem, das mehr Zeichen als ASCII abdeckt.)
- Dies ist vollständig integriert SAP HANA Studio.
- SLT verfügt über Tabelleneinstellungs- und Transformationsfunktionen.
- SLT verfügt über Überwachungsfunktionen mit SAP HANA-Lösungsmanager.
Das triggerbasierte Design ermöglicht Echtzeitfähigkeit. Ein Datenbanktrigger auf der Quelltabelle schreibt jede Änderung in eine Protokolltabelle, die SLT dann liest und anwendet, anstatt die gesamte Tabelle wiederholt nach Unterschieden zu durchsuchen.
SAP SLT-Verbindung ArchiArchitekturübersicht
Archistruktur Überblick über SAP SLT-Server mit SAP / Nicht-SAP Das System ist wie folgt:
SAP SLT Verbindung zwischen SAP System und SAP HANA
SAP Der SLT Replication Server transformiert alle Metadatentabellendefinitionen vom ABAP-Quellsystem in SAP HANA.
Für SAP Quelle, die SLT-Verbindung verfügt über die folgenden Funktionen –
- Wenn eine Tabelle repliziert wird, SAP Der SLT-Replikationsserver erstellt Protokollierungstabellen im Quellsystem.
- Die Lese-Engine wird erstellt im SAP Quellsystem.
- Die Verbindung zwischen SAP SLT und SAP Die Quelle wird als RFC-Verbindung hergestellt.
- Die Verbindung zwischen SAP SLT und SAP HANA wird als DB-Verbindung hergestellt.
Ein Datenbankbenutzer mit der gleichen Berechtigung wie der Benutzer „SYSTEM“ kann eine Verbindung herstellen zwischen SAP SLT und SAP HANA-Datenbank.

SAP SLT-Server erstellt automatisch eine DB-Verbindung für SAP HANA-Datenbank (wenn wir eine neue Konfiguration über die Transaktion LTR erstellen). Es ist nicht erforderlich, sie manuell zu erstellen.
Einrichtung SAP SLT Server für SAP Quellsystem
Zuerst müssen wir konfigurieren SAP SLT Replikationsserver für die Verbindung zwischen SAP Quelle und SAP HANA-Datenbank. T-Code LTR wird verwendet, um eine Verbindung herzustellen zwischen SAP Quelle und SAP SLT.
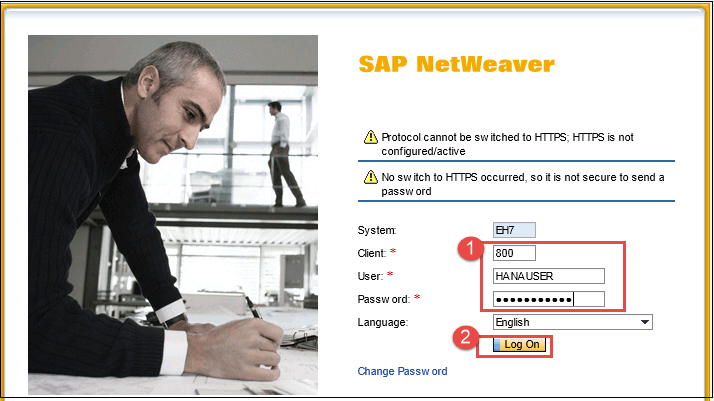
Schritt 1) Einloggen um SAP SLT-Server und Call-Transaktion „LTR“ ab SAP SLT-Replikationsserver.

Ein Web-Dynpro-Popup-Bildschirm wird zur Anmeldung angezeigt. SAP SLT-Server.
- Geben Sie Client/Benutzer-ID/Passwort ein
- Klicken Sie auf die Registerkarte „Anmelden“.
Ein Popup-Bildschirm für die Konfiguration wird wie folgt angezeigt:

Klicken Sie für die neue Konfiguration auf die Schaltfläche „Neu“.
Schritt 2) In diesem Schritt
- Geben Sie den Konfigurationsnamen und die Beschreibung ein.
- Auswählen SAP System als Quellsystem.
- RFC-Verbindung eingeben für SAP -System.
- Geben Sie Benutzername/Passwort/Hostnamen und Instanznummer ein.
- Geben Sie die Details der Joboptionen ein – Anzahl der Datenübertragungsaufträge und Anzahl der Berechnungsaufträge.
- Wählen Sie die Replikationsoption „Echtzeit“ aus.
- Sobald alle Einstellungen beibehalten wurden, klicken Sie auf „OK“, um ein neues Schema in SLT zu erstellen.

Ein Konfigurationsname „SLTECC“ wird hinzugefügt und aktiv.

Nach der Konfiguration SAP SLT-Server erfolgreich, SAP SLT-Server erstellt automatisch eine DB-Verbindung für SAP HANA-Datenbank (wenn wir eine neue Konfiguration über die Transaktion LTR erstellen). Es ist nicht erforderlich, sie manuell zu erstellen.
Im nächsten Schritt importieren wir Daten in SAP HANA von SAP Quelle.
Import SAP Quelldaten für SAP HANA durch SLT
Nach erfolgreicher Konfiguration SAP SLT-Server, ein SCHEMA als Konfigurationsname oben in SAP SLT entsteht in SAP HANA-Datenbank.
Dieses Schema enthält folgende Objekte:
- 1 Schema – SLTECC.
- 1 Benutzer – SLTECC.
- 1 Privilegien
- 8-Tabellen – DD02L (SAP Tabellenname), DD02T (SAP Tabellentexte), RS_LOG_FILES, RS_MESSAGE, RS_ORDER, RS_ORDER_TEXT, RS_SCHEMA_MAP, RS_STATUS.
- 4 Rollen – SLTECC_DATA_PROV, SLTECC_DATA_POWER_USER, SLTECC_DATA_USER_ADMIN, SLTECC_DATA_SELECT.
- 2-Prozeduren – RS_GRANT_ACCESS, RS_REVOKE_ACCESS.
Die Konfiguration ist abgeschlossen, nun laden wir eine Tabelle von SAP ECC (ERP-Zentralkomponente).
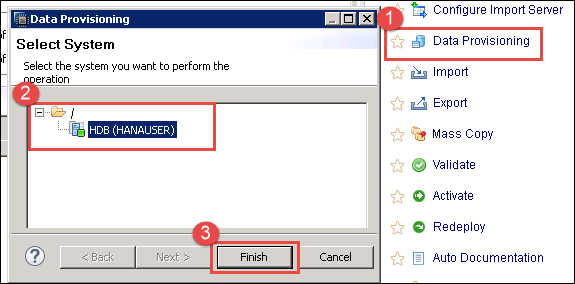
Schritt 1) So laden Sie Tabellen aus SAP ECC zu SAP HANA-Datenbank, befolgen Sie die folgenden Schritte:
- Gehen Sie in der Schnellansicht zu Datenbereitstellung.
- Auswählen SAP HANA-System.
- Klicken Sie auf die Schaltfläche „Fertig stellen“.
Schritt 2) Ein Bildschirm für die Bereitstellung von SLT-basierten Tabellendaten wird angezeigt. Es gibt 5 Optionen für die Datenbereitstellung, wie unten dargestellt:
| Bereitstellungsoption | Detail |
|---|---|
| Laden (Volllast) | Dies ist ein einmaliges Ereignis, das einen ersten Ladevorgang von Daten aus dem Quellsystem startet. |
| Replizieren (Volllast + Delta Belastung) | Beginnen Sie mit dem anfänglichen Laden (sofern dies nicht früher erfolgt) und berücksichtigen Sie dies auch Delta ändern. Für jede Tabelle werden ein Datenbanktrigger und eine zugehörige Protokollierungstabelle erstellt. |
| Stoppen Sie die Replikation | Es stoppt den aktuellen Replikationsprozess für eine Tabelle. Es entfernt den Datenbanktrigger und die Protokollierungstabelle vollständig. |
| Aussetzen | Es unterbricht den laufenden Replikationsprozess einer Tabelle. Der Datenbanktrigger wird nicht aus dem Quellsystem gelöscht, und die Protokollierung von Änderungen wird fortgesetzt. Zugehörige Informationen werden in der entsprechenden Protokolltabelle im Quellsystem gespeichert. |
| Lebenslauf | Resume startet die Replikation für eine angehaltene Tabelle neu. Nach der Wiederaufnahme wird der unterbrochene Replikationsprozess fortgesetzt. |
⚠️ Warnung: Replikation anhalten und stoppen sind nicht austauschbar. Beim Anhalten bleiben Trigger und Protokolltabelle erhalten, sodass Änderungen akkumuliert und beim Fortsetzen angewendet werden. Beim Stoppen werden beide gelöscht, sodass alle während des Stopps vorgenommenen Änderungen verloren gehen und ein vollständiges Neuladen erforderlich ist.
Wir verwenden die erste Option aus der Tabelle „Option laden“ für das erstmalige Laden der Tabellendaten (LFBK) von der Quelle in SAP HANA-Tabelle.
Schritt für Schritt ist wie folgt:
- Quelle und Target Die Systemdetails werden ausgewählt nach SAP SLT-Konfiguration.
- Klicken Sie auf die Schaltfläche Laden und wählen Sie die Tabelle (LFBK) aus, die wir laden/replizieren müssen SAP Hana.
- Die Tabelle (LFBK) wird dem Abschnitt „Data Load Management“ mit der Aktion „Laden“ und dem Status „Geplant“ hinzugefügt.

Nach dem Laden der Daten ändert sich der Status in „Ausgeführt“. Die Tabelle wird im „SLTECC“-Schema mit Daten erstellt.
Schritt 3) Überprüfen Sie die Daten in der Tabelle (LFBK) anhand der Datenvorschau aus dem Schema „SLTECC“ wie folgt –
- Einloggen in SAP HANA-Datenbank durch SAP HANA Studio und wählen Sie SAP HANA-System HDB (HANAUSER).

- Wählen Sie Tabelle (LFBK) unter Tabellenknoten aus.
- Klicken Sie mit der rechten Maustaste auf Tabelle (LFBK) und klicken Sie auf die Option „Datenvorschau öffnen“.
- Durch den SLT-Prozess geladene Daten werden im Datenvorschaubildschirm angezeigt.

Jetzt haben wir erfolgreich Daten in die Tabelle „LFBK“ geladen. Wir werden diese Tabelle künftig in der Modellierung verwenden.
SAP SLT Verbindung zwischen Nicht-SAP System und SAP HANA
SAP Der SLT Replication Server transformiert alle Metadatentabellendefinitionen aus dem Nicht-ABAP-Quellsystem in SAP HANA.
Für Nicht-SAP Quelle, die SLT-Verbindung hat folgende Funktionen –
- Wenn eine Tabelle repliziert wird, SAP Der SLT-Replikationsserver erstellt Protokollierungstabellen im Quellsystem.
- Die Lese-Engine wird erstellt im SAP SLT-Replikationsserver.
- Die Verbindung zwischen SAP SLT und SAP Quelle / SAP HANA wird als DB-Verbindung hergestellt.

SAP SLT kann nur einfachste Transformationen durchführen, daher benötigen wir für komplexe Transformationen ein anderes ETL-Tool wie SAP Datendienste.
Der einzige architektonische Unterschied ist bemerkenswert: für ein SAP Bei einer Quelle befindet sich die Lese-Engine im Quellsystem und die Verbindung ist RFC, wohingegen bei einer Nicht-SAP Die Lese-Engine befindet sich auf dem SLT-Server selbst, und beide Verbindungen sind Datenbankverbindungen. Alle nachfolgenden Komponenten verhalten sich identisch.
SLT im Vergleich zu anderen Replikationsmethoden
SLT ist eine von mehreren Routen nach SAP HANA, und sein charakteristisches Merkmal ist die Latenz und nicht die Transformationsfähigkeit.
| Parameter | SLT | SAP Datendienste | DXC |
|---|---|---|---|
| Latency | Echtzeit oder geplant | Stapel | Stapel |
| Mechanismus | Datenbank-Trigger und Protokollierungstabellen | Geplante ETL-Jobs | Business Suite extractoren |
| Quellsysteme | SAP und nicht-SAP Datenbanken | Fast jede Quelle | SAP Nur Business Suite |
| Transformation | Nur einfache Regeln | Umfangreiche grafische Transformationen | Angewendet vom ExtracDo. |
| Cluster und Billardtische | Wird nativ verarbeitet | Erfordert zusätzlichen Aufwand | Vom Ex-Partner bearbeitettracDo. |
| Zusätzliche Landschaft | Ein SLT-Server | Eine Datendienstlandschaft | Keine Präsentation |
Wo Transformation wichtiger ist als Latenz, SAP Datendienste ist die bessere Wahl, und wo der ExtracDie Tor-Logik existiert bereits. DXC vermeidet einen Server vollständig. Der vollständige Vergleich befindet sich im Datenbereitstellung Tutorial.
SLT-Überwachung und Fehlerbehebung
Da die Replikation kontinuierlich läuft, werden Probleme üblicherweise durch veraltete Daten und nicht durch Fehlermeldungen bemerkt. Diese Prüfungen finden die Ursache schnell.
- Überprüfen Sie zuerst die Konfiguration in LTR. Die Übersicht zeigt jede Konfiguration mit ihrem Status und der Anzahl der Tabellen im jeweiligen Status. Eine fehlerhafte Konfiguration blockiert alle darunterliegenden Tabellen.
- Weitere Details finden Sie in der Transaktion LTRC. Die Registerkarten „Laststatistik“ und „Datenübertragungsmonitor“ zeigen den Durchsatz pro Tabelle an und machen deutlich, welche Tabelle hinterherhinkt.
- Achten Sie auf die Größe der Protokolltabelle. Eine stetig wachsende Protokolltabelle bedeutet, dass Änderungen zwar erfasst, aber nicht angewendet werden. Dies deutet in der Regel auf zu wenige Datenübertragungsaufträge hin.
- Stellen Sie die Anzahl der Jobs ein. Datenübertragungs- und Berechnungsaufträge wurden während der Konfiguration festgelegt. Sind es zu wenige, hinkt die Replikation hinterher; sind es zu viele, leidet das Quellsystem. Passen Sie die Werte in der LTR-Struktur an, anstatt im Quellsystem zu raten.
- Untersuchen Sie eine Tabelle, die im Status „Geplant“ festhängt. Die häufigste Ursache ist, dass auf dem SLT-Server kein freier Hintergrundprozess verfügbar ist, und nicht ein Fehler in der Tabelle.
- In HANA darf niemals eine replizierte Tabelle gelöscht werden. Der Trigger in der Quelle schreibt weiterhin in eine Protokolltabelle, ohne dass ein Empfänger vorhanden ist. Beenden Sie zunächst die Replikation ordnungsgemäß, wodurch der Trigger entfernt wird.
- RevSehen Sie sich RS_STATUS und RS_MESSAGE an. Diese Kontrolltabellen im generierten Schema halten fest, was SLT selbst über jede Tabelle annimmt.
Der teuerste Fehler ist die Replikation von Tabellen, die niemand benötigt. Jede replizierte Tabelle löst im Quellsystem einen Trigger aus, sodass eine ungenutzte Replikation dem Transaktionssystem, aus dem sie liest, dauerhafte Kosten verursacht.
