
PyTorch Tutorial
 Evelyn Clarke
⚡ Intelligente Zusammenfassung
PyTorch ist das Open-Source-Framework für Deep Learning von Meta, das im Jahr 2026 bereits 85 Prozent aller KI-Forschungsarbeiten zugrunde liegt. LessDie Inhalte umfassen die Installation, die Grundlagen des Frameworks, einfache Regressionstests, die Bildklassifizierung und die Bereitstellung mit AWS SageMaker.
Was ist PyTorH?
PyTorch ist ein Open-Source Torch-basierte Machine-Learning-Bibliothek für die Verarbeitung natürlicher Sprache PythonEs ähnelt NumPy, bietet aber leistungsstarke GPU-Unterstützung. Es stellt dynamische Berechnungsdiagramme bereit, die Sie mithilfe von autograd.py flexibel anpassen können.Torch ist zudem schneller als einige andere Frameworks. Es wurde 2016 von der KI-Forschungsgruppe von Facebook entwickelt.
Zu wissen, was PyTorch bietet einen ausgewogenen Blick auf seine Stärken und Schwächen.
PyTorVorteile und Nachteile
Im Folgenden werden die Vor- und Nachteile von Py aufgeführt.Torch:
Vorteile von PyTorch
- Einfache Bibliothek
PyTorDer Code von ch ist einfach. Er ist leicht verständlich und die Bibliothek ist sofort einsatzbereit. Sehen Sie sich beispielsweise den folgenden Codeausschnitt an:
class Net(torch.nn.Module):
   def __init__(self):
       super(Net, self).__init__()
       self.layer = torch.nn.Linear(1, 1)

   def forward(self, x):
       x = self.layer(x)
       return x
Wie oben erwähnt, können Sie das Netzwerkmodell einfach definieren und den Code ohne große Schulung schnell verstehen.
- Dynamisches Computerdiagramm

Bildquelle: Exploring Deep Learning with PyTorch
PyTorch bietet dynamische Berechnungsgraphen (DAGs). Berechnungsgraphen ermöglichen die Darstellung mathematischer Ausdrücke in Graphmodellen oder -theorien, beispielsweise durch Knoten und Kanten. Ein Knoten führt die mathematische Operation aus, und eine Kante ist ein Tensor, der den Knoten als Eingabe dient und deren Ausgabe als Tensor enthält.
DAG ist ein Graph, der beliebige Formen annehmen kann und Operationen zwischen verschiedenen Eingabegraphen durchführen kann. Bei jeder Iteration wird ein neuer Graph erstellt. Es ist also möglich, dieselbe Graphstruktur zu haben oder mit einer anderen Operation einen neuen Graphen zu erstellen. Wir können ihn auch als dynamischen Graphen bezeichnen.
- Bessere Leistung
Communities und Forscher vergleichen und vergleichen Frameworks, um herauszufinden, welches schneller ist. Ein GitHub-Repo Benchmark für Deep Learning Frameworks und GPUs berichtete, dass PyTorch ist im Vergleich zum anderen Framework hinsichtlich der Anzahl der pro Sekunde verarbeiteten Bilder schneller.
Wie Sie unten sehen können, sind die Vergleichsdiagramme mit vgg16 und resnet152


- Ureinwohner Python
PyTorch ist stärker auf Python ausgerichtet. Wenn Sie beispielsweise ein Modell trainieren möchten, können Sie den nativen Kontrollfluss wie loo verwenden.ping und Rekursionen, ohne dass zusätzliche spezielle Variablen oder Sitzungen benötigt werden, um sie ausführen zu können. Dies ist für den Trainingsprozess sehr hilfreich.
PyTorch implementiert auch imperative Programmierung und ist definitiv flexibler. So ist es möglich, den Tensorwert mitten in einem Berechnungsprozess auszugeben.
Nachteil von PyTorch
PyTorch benötigt Anwendungen von Drittanbietern zur Visualisierung. Außerdem wird für den Produktivbetrieb ein API-Server benötigt.
Als nächstes in diesem PyTorIn diesem Tutorial lernen wir den Unterschied zwischen Py kennen.Torch und TensorFlow.
PyTorch vs. TensorFlow
| Parameter | PyTorch | TensorFlow |
|---|---|---|
| Modelldefinition | Das Modell ist in einer Unterklasse definiert und bietet ein benutzerfreundliches Paket | Das Modell ist mit vielen definiert und Sie müssen die Syntax verstehen |
| GPU-Unterstützung | Ja | Ja |
| Diagrammtyp | Dynamisch | Statisch |
| Zubehör | Kein Visualisierungstool | Sie können das Visualisierungstool Tensorboard verwenden |
| Gemeinschaft | Die Community wächst weiter | Große aktive Gemeinschaften |
Vor diesem Hintergrund besteht der nächste Schritt darin, Py zu beschaffen.Torch läuft lokal oder in der Cloud.
Py installierenTorch
Linux
Die Installation unter Linux ist unkompliziert. Sie können wählen, ob Sie eine virtuelle Umgebung verwenden oder diese direkt mit Root-Zugriff installieren möchten. Geben Sie diesen Befehl im Terminal ein
pip3 install --upgrade torch torchvision
AWS Sagemaker
Sagemaker ist eine der Plattformen in Amazon Internetservice Das bietet eine leistungsstarke Machine-Learning-Engine mit vorinstallierten Deep-Learning-Konfigurationen für Datenwissenschaftler oder Entwickler zum Erstellen, Trainieren und Bereitstellen von Modellen in jedem Maßstab.
Öffnen Sie zuerst die Amazon Sagemaker Konsole und klicken Sie auf „Notebook-Instanz erstellen“ und geben Sie alle Details für Ihr Notebook ein.

Klicken Sie im nächsten Schritt auf „Öffnen“, um Ihre Notebook-Instanz zu starten.

Endlich, In JupyterKlicken Sie auf „Neu“ und wählen Sie „conda_pytorch_p36“ aus. Nun können Sie Ihre Notebook-Instanz mit PyTorch verwenden.Torch installiert.
Als nächstes in diesem PyTorIn diesem Tutorial lernen wir etwas über Py.TorGrundlagen des Ch-Frameworks.
Nach der Installation ist die API selbst der nächste Schritt.
PyTorGrundlagen des ch-Frameworks
Lasst uns die grundlegenden Konzepte von Py lernen.Torch, bevor wir tiefer einsteigen. PyTorch verwendet für jede Variable einen Tensor, ähnlich wie ndarray in NumPy, bietet aber GPU-Berechnungsunterstützung. Hier erklären wir das Netzwerkmodell, die Verlustfunktion, Backpropagation und den Optimierer.
Netzwerkmodell
Das Netzwerk kann durch Unterklassen von Torch.nn erstellt werden. Es gibt 2 Hauptteile,
- Der erste Teil besteht darin, die Parameter und Ebenen zu definieren, die Sie verwenden werden
- Der zweite Teil ist die Hauptaufgabe, der sogenannte Vorwärtsprozess, der eine Eingabe entgegennimmt und die Ausgabe vorhersagt.
Import torch
import torch.nn as nn
import torch.nn.functional as F

class Model(nn.Module):
 def __init__(self):
        super(Model, self).__init__()
        self.conv1 = nn.Conv2d(3, 20, 5)
        self.conv2 = nn.Conv2d(20, 40, 5)
self.fc1 = nn.Linear(320, 10)

def forward(self, x):
       x = F.relu(self.conv1(x))
       x = F.relu(self.conv2(x))
       x = x.view(-1, 320)
       x = F.relu(self.fc1(x))
       return F.log_softmax(x)

net = Model()
Wie Sie oben sehen können, erstellen Sie eine Klasse von nn.Module namens Model. Es enthält 2 Conv2d-Ebenen und eine lineare Ebene. Die erste conv2d-Schicht nimmt eine Eingabe von 3 und die Ausgabeform von 20 an. Die zweite Schicht nimmt eine Eingabe von 20 an und erzeugt eine Ausgabeform von 40. Die letzte Schicht ist eine vollständig verbundene Schicht in der Form 320 und erzeugt eine Ausgabe von 10.
Der Weiterleitungsprozess nimmt eine Eingabe von X und leitet sie an die conv1-Ebene weiter und führt die ReLU-Funktion aus.
In ähnlicher Weise wird auch die conv2-Ebene gespeist. Danach wird das x in (-1, 320) umgeformt und in die endgültige FC-Ebene eingespeist. Bevor Sie die Ausgabe senden, verwenden Sie die Softmax-Aktivierungsfunktion.
Der Rückwärtsprozess wird automatisch von Autograd definiert, sodass Sie nur den Vorwärtsprozess definieren müssen.
Verlustfunktion
Die Verlustfunktion dient dazu, zu messen, wie gut das Vorhersagemodell die erwarteten Ergebnisse vorhersagen kann.Torch verfügt bereits über viele Standard-Verlustfunktionen im Modul torch.nn. Beispielsweise können Sie die Cross-Entropy-Verlustfunktion verwenden, um ein mehrklassiges Py-Problem zu lösen.TorEs handelt sich um ein Klassifizierungsproblem. Die Verlustfunktion lässt sich leicht definieren und die Verluste können einfach berechnet werden:
loss_fn = nn.CrossEntropyLoss()

#training process
loss = loss_fn(out, target)
Mit Py ist es einfach, Ihre eigene Verlustfunktionsberechnung zu verwenden.Torch.
Backprop
Um die Backpropagation durchzuführen, rufen Sie einfach los.backward() auf. Der Fehler wird berechnet, aber denken Sie daran, den vorhandenen Farbverlauf mit „zero_grad()“ zu löschen.
net.zero_grad() # to clear the existing gradient
loss.backward() # to perform backpropragation
Optimierer
torch.optim stellt allgemeine Optimierungsalgorithmen bereit. Sie können einen Optimierer mit einem einfachen Schritt definieren:
optimizer = torch.optim.SGD(net.parameters(), lr = 0.01, momentum=0.9)
Sie müssen die Netzwerkmodellparameter und die Lernrate übergeben, damit die Parameter bei jeder Iteration nach dem Backprop-Prozess aktualisiert werden.
Der beste Weg, die API zu erlernen, ist ein kleines, vollständiges Beispiel.
Einfache Regression mit PyTorch
Lasst uns einfache Regression mit Py lernen.TorBeispiele für ch:
Schritt 1) Erstellen unseres Netzwerkmodells
Unser Netzwerkmodell ist eine einfache lineare Schicht mit einer Eingabe- und einer Ausgabeform von 1.
from __future__ import print_function

import torch
import torch.nn as nn
import torch.nn.functional as F
from torch.autograd import Variable

class Net(nn.Module):
   def __init__(self):
       super(Net, self).__init__()
       self.layer = torch.nn.Linear(1, 1)

   def forward(self, x):
       x = self.layer(x)
       return x

net = Net()
print(net)
Und die Netzwerkausgabe sollte so sein
Net(
  (hidden): Linear(in_features=1, out_features=1, bias=True)
)
Schritt 2) Testdaten
Bevor Sie mit dem Trainingsprozess beginnen, müssen Sie unsere Daten kennen. Sie erstellen eine Zufallsfunktion, um unser Modell zu testen. Y = x3 sin(x)+ 3x+0.8 rand(100)
# Visualize our data
import matplotlib.pyplot as plt
import numpy as np

x = np.random.rand(100)
y = np.sin(x) * np.power(x,3) + 3*x + np.random.rand(100)*0.8

plt.scatter(x, y)
plt.show()
Hier ist das Streudiagramm unserer Funktion:

Bevor Sie mit dem Trainingsprozess beginnen, müssen Sie das NumPy-Array in Variablen konvertieren, die von unterstützt werden. Torch und autograd, wie im folgenden Py gezeigt.Torch-Regressionsbeispiel.
# convert numpy array to tensor in shape of input size
x = torch.from_numpy(x.reshape(-1,1)).float()
y = torch.from_numpy(y.reshape(-1,1)).float()
print(x, y)
Schritt 3) Optimierer und Verlust
Als nächstes sollten Sie den Optimierer und die Verlustfunktion für unseren Trainingsprozess definieren.
# Define Optimizer and Loss Function
optimizer = torch.optim.SGD(net.parameters(), lr=0.2)
loss_func = torch.nn.MSELoss()
Schritt 4) Schulung
Beginnen wir nun mit unserem Trainingsprozess. Mit einer Epoche von 250 iterieren Sie unsere Daten, um den besten Wert für unsere Hyperparameter zu finden.
inputs = Variable(x)
outputs = Variable(y)
for i in range(250):
   prediction = net(inputs)
   loss = loss_func(prediction, outputs)
   optimizer.zero_grad()
   loss.backward()
   optimizer.step()

   if i % 10 == 0:
       # plot and show learning process
       plt.cla()
       plt.scatter(x.data.numpy(), y.data.numpy())
       plt.plot(x.data.numpy(), prediction.data.numpy(), 'r-', lw=2)
       plt.text(0.5, 0, 'Loss=%.4f' % loss.data.numpy(), fontdict={'size': 10, 'color':  'red'})
       plt.pause(0.1)

plt.show()
Schritt 5) Ergebnis
Wie Sie unten sehen können, haben Sie Py erfolgreich ausgeführt.Torch-Regression mit einem neuronalen Netzwerk. Tatsächlich wird die rote Linie im Diagramm bei jeder Iteration aktualisiert und ihre Position an die Daten angepasst. In dieser Abbildung wird jedoch nur das Endergebnis dargestellt (siehe unten).TorBeispiel:

Regression ist ein Aufwärmen; Bildklassifizierung trainiert die Deep-Learning-Fähigkeiten von Py.Torch.
Beispiel zur Bildklassifizierung mit PyTorch
Eine der beliebtesten Methoden, um die Grundlagen zu erlernen tiefe Lernen ist mit dem MNIST-Datensatz. Es ist das „Hallo Welt“ im Deep Learning. Der Datensatz enthält handgeschriebene Zahlen von 0 – 9 mit insgesamt 60,000 Trainingsproben und 10,000 Testproben, die bereits mit der Größe von 28×28 Pixeln beschriftet sind.

Schritt 1) Verarbeiten Sie die Daten vor
Im ersten Schritt dieses PyTorIm Beispiel der Klassifizierung laden Sie den Datensatz mithilfe des torchvision-Moduls.
Bevor Sie mit dem Trainingsprozess beginnen, müssen Sie die Daten verstehen. Torchvision lädt den Datensatz und transformiert die Bilder entsprechend den Anforderungen des Netzwerks, z. B. durch Anpassung der Bildform und Normalisierung.
import torch
import torchvision
import numpy as np
from torchvision import datasets, models, transforms

# This is used to transform the images to Tensor and normalize it
transform = transforms.Compose(
   [transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))])

training = torchvision.datasets.MNIST(root='./data', train=True,
                                       download=True, transform=transform)
train_loader = torch.utils.data.DataLoader(training, batch_size=4,
                                         shuffle=True, num_workers=2)

testing = torchvision.datasets.MNIST(root='./data', train=False,
                                      download=True, transform=transform)
test_loader = torch.utils.data.DataLoader(testing, batch_size=4,
                                        shuffle=False, num_workers=2)

classes = ('0', '1', '2', '3',
          '4', '5', '6', '7', '8', '9')

import matplotlib.pyplot as plt
import numpy as np

#create an iterator for train_loader
# get random training images
data_iterator = iter(train_loader)
images, labels = data_iterator.next()

#plot 4 images to visualize the data
rows = 2
columns = 2
fig=plt.figure()
for i in range(4):
   fig.add_subplot(rows, columns, i+1)
   plt.title(classes[labels[i]])
   img = images[i] / 2 + 0.5     # this is for unnormalize the image
   img = torchvision.transforms.ToPILImage()(img)
   plt.imshow(img)
plt.show()
Die Transformationsfunktion wandelt die Bilder in Tensor um und normalisiert den Wert. Die Funktion Torchvision.transforms.MNIST lädt den Datensatz (sofern er nicht verfügbar ist) in das Verzeichnis herunter, legt den Datensatz bei Bedarf für das Training fest und führt den Transformationsprozess durch.
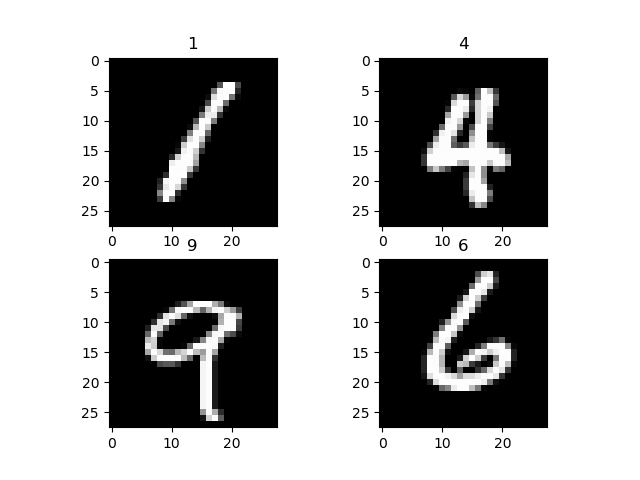
Um den Datensatz zu visualisieren, verwenden Sie den data_iterator, um den nächsten Stapel von Bildern und Beschriftungen abzurufen. Sie verwenden Matplot, um diese Bilder und ihre entsprechende Beschriftung zu plotten. Wie Sie unten sehen können, sind unsere Bilder und ihre Beschriftungen.
Schritt 2) Netzwerkmodellkonfiguration
Nun in diesem PyTorBeispielsweise erstellen Sie ein einfaches neuronales Netzwerk für PyTorch Bildklassifizierung.
Hier stellen wir Ihnen eine weitere Möglichkeit vor, das Netzwerkmodell in Py zu erstellen.TorWir werden nn.Sequential verwenden, um ein Sequenzmodell zu erstellen, anstatt eine Unterklasse von nn.Module zu erstellen.
import torch.nn as nn

# flatten the tensor into
class Flatten(nn.Module):
   def forward(self, input):
       return input.view(input.size(0), -1)

#sequential based model
seq_model = nn.Sequential(
           nn.Conv2d(1, 10, kernel_size=5),
           nn.MaxPool2d(2),
           nn.ReLU(),
           nn.Dropout2d(),
           nn.Conv2d(10, 20, kernel_size=5),
           nn.MaxPool2d(2),
           nn.ReLU(),
           Flatten(),
           nn.Linear(320, 50),
           nn.ReLU(),
           nn.Linear(50, 10),
           nn.Softmax(),
         )

net = seq_model
print(net)
Hier ist die Ausgabe unseres Netzwerkmodells
Sequential(
  (0): Conv2d(1, 10, kernel_size=(5, 5), stride=(1, 1))
  (1): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (2): ReLU()
  (3): Dropout2d(p=0.5)
  (4): Conv2d(10, 20, kernel_size=(5, 5), stride=(1, 1))
  (5): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (6): ReLU()
  (7): Flatten()
  (8): Linear(in_features=320, out_features=50, bias=True)
  (9): ReLU()
  (10): Linear(in_features=50, out_features=10, bias=True)
  (11): Softmax()
)
Netzwerkerklärung
- Die Reihenfolge ist, dass die erste Ebene eine Conv2D-Ebene mit einer Eingabeform von 1 und einer Ausgabeform von 10 mit einer Kernelgröße von 5 ist
- Als nächstes haben Sie eine MaxPool2D-Ebene
- Eine ReLU-Aktivierungsfunktion
- eine Dropout-Ebene, um Werte mit geringer Wahrscheinlichkeit zu löschen.
- Dann ein zweites Conv2d mit der Eingabeform 10 aus der letzten Ebene und der Ausgabeform 20 mit einer Kernelgröße von 5
- Als nächstes eine MaxPool2d-Ebene
- ReLU-Aktivierungsfunktion.
- Danach glätten Sie den Tensor, bevor Sie ihn in die lineare Ebene einspeisen
- Die lineare Ebene ordnet unsere Ausgabe der zweiten linearen Ebene mit der Softmax-Aktivierungsfunktion zu
Schritt 3)Trainieren Sie das Modell
Bevor Sie mit dem Trainingsprozess beginnen, müssen Sie das Kriterium und die Optimierungsfunktion einrichten.
Als Kriterium verwenden Sie die CrossEntropyLoss-Funktion. Als Optimierer verwenden Sie SGD mit einer Lernrate von 0.001 und einem Momentum von 0.9, wie im folgenden Py-Code dargestellt.TorBeispiel ch.
import torch.optim as optim

criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(net.parameters(), lr=0.001, momentum=0.9)
Der Weiterleitungsprozess nimmt die Eingabeform an und übergibt sie an die erste conv2d-Ebene. Von dort aus wird es dann in maxpool2d eingespeist und schließlich in die ReLU-Aktivierungsfunktion eingefügt. Der gleiche Vorgang findet in der zweiten conv2d-Ebene statt. Danach wird die Eingabe in (-1,320) umgeformt und in die fc-Schicht eingespeist, um die Ausgabe vorherzusagen.
Jetzt beginnen Sie mit dem Trainingsprozess. Sie durchlaufen unseren Datensatz zweimal oder mit einer Epoche von 2 und drucken den aktuellen Verlust alle 2 Chargen aus.
for epoch in range(2):

#set the running loss at each epoch to zero
   running_loss = 0.0
# we will enumerate the train loader with starting index of 0
# for each iteration (i) and the data (tuple of input and labels)
   for i, data in enumerate(train_loader, 0):
       inputs, labels = data

# clear the gradient
       optimizer.zero_grad()

#feed the input and acquire the output from network
       outputs = net(inputs)

#calculating the predicted and the expected loss
       loss = criterion(outputs, labels)

#compute the gradient
       loss.backward()

#update the parameters
       optimizer.step()

       # print statistics
       running_loss += loss.item()
       if i % 1000 == 0:
           print('[%d, %5d] loss: %.3f' %
                 (epoch + 1, i + 1, running_loss / 1000))
           running_loss = 0.0
In jeder Epoche erhält der Enumerator das nächste Eingabetupel und die entsprechenden Beschriftungen. Bevor wir die Eingabe in unser Netzwerkmodell einspeisen, müssen wir den vorherigen Gradienten löschen. Dies ist erforderlich, da der Gradient nach dem Rückwärtsprozess (Backpropagation-Prozess) akkumuliert und nicht ersetzt wird. Dann berechnen wir die Verluste aus der vorhergesagten Ausgabe aus der erwarteten Ausgabe. Danach führen wir eine Backpropagation durch, um den Gradienten zu berechnen, und schließlich aktualisieren wir die Parameter.
Hier ist die Ausgabe des Trainingsprozesses
[1, 	1] loss: 0.002
[1,  1001] loss: 2.302
[1,  2001] loss: 2.295
[1,  3001] loss: 2.204
[1,  4001] loss: 1.930
[1,  5001] loss: 1.791
[1,  6001] loss: 1.756
[1,  7001] loss: 1.744
[1,  8001] loss: 1.696
[1,  9001] loss: 1.650
[1, 10001] loss: 1.640
[1, 11001] loss: 1.631
[1, 12001] loss: 1.631
[1, 13001] loss: 1.624
[1, 14001] loss: 1.616
[2, 	1] loss: 0.001
[2,  1001] loss: 1.604
[2,  2001] loss: 1.607
[2,  3001] loss: 1.602
[2,  4001] loss: 1.596
[2,  5001] loss: 1.608
[2,  6001] loss: 1.589
[2,  7001] loss: 1.610
[2,  8001] loss: 1.596
[2,  9001] loss: 1.598
[2, 10001] loss: 1.603
[2, 11001] loss: 1.596
[2, 12001] loss: 1.587
[2, 13001] loss: 1.596
[2, 14001] loss: 1.603
Schritt 4) Testen Sie das Modell
Nachdem Sie unser Modell trainiert haben, müssen Sie es mit anderen Bildsätzen testen oder bewerten.
Wir verwenden einen Iterator für den Testlader. Dieser generiert einen Stapel von Bildern und Beschriftungen, die an das trainierte Modell übergeben werden. Die vorhergesagte Ausgabe wird angezeigt und mit der erwarteten Ausgabe verglichen.
#make an iterator from test_loader
#Get a batch of training images
test_iterator = iter(test_loader)
images, labels = test_iterator.next()

results = net(images)
_, predicted = torch.max(results, 1)

print('Predicted: ', ' '.join('%5s' % classes[predicted[j]] for j in range(4)))

fig2 = plt.figure()
for i in range(4):
   fig2.add_subplot(rows, columns, i+1)
   plt.title('truth ' + classes[labels[i]] + ': predict ' + classes[predicted[i]])
   img = images[i] / 2 + 0.5     # this is to unnormalize the image
   img = torchvision.transforms.ToPILImage()(img)
   plt.imshow(img)
plt.show()

