
ELK Stack Tutorial: Kibana, Logstash & Elasticsearch
 David Carter
⚡ Intelligente Zusammenfassung
ELK Stack kombiniert drei Open-Source-Tools – Elasticsearch, Logstashund Kibana – zum Sammeln, Speichern, Suchen und Visualisieren von Maschinendaten, wodurch Entwicklungsteams eine zentrale Protokollierung und Echtzeitanalysen für eine schnellere Fehlerbehebung auf Servern und Anwendungen erhalten.
Der ELK Stack ist eine der am weitesten verbreiteten Open-Source-Lösungen für die zentrale Protokollierung und Protokollanalyse. Dieses ELK Stack-Tutorial erklärt, was Elasticsearch, Logstashund Kibana, wie die drei Tools zusammenpassen und wo die Plattform in der realen Überwachungs- und Observability-Arbeit eingesetzt wird.
Was ist der ELK-Stack?
Das ELK-Stapel ist eine Sammlung von drei Open-Source-Produkten – Elasticsearch, Logstashund Kibana. Es bietet eine zentrale Protokollierung, die Ihnen hilft, Probleme mit Servern oder Anwendungen zu identifizieren, indem Sie alle Ihre Protokolle an einem zentralen Ort durchsuchen können. Außerdem unterstützt es Sie bei der Korrelation von Protokollen mehrerer Server innerhalb eines bestimmten Zeitraums.
- E steht für Elasticsearch: wird zum Speichern von Protokollen verwendet.
- L steht für Logstash: wird für Schiffe verwendetping, Verarbeitung und Speicherung von Protokollen.
- K steht für Kibana: ein Visualisierungstool (eine Weboberfläche), die über Nginx oder Apache gehostet wird.
Elasticsearch, Logstash, und Kibana werden alle von einem Unternehmen namens entwickelt, verwaltet und gewartet. Elastisch.
Zusammen ist der ELK Stack so konzipiert, dass Benutzer Daten aus beliebigen Quellen und in beliebigen Formaten erfassen und diese Daten anschließend in Echtzeit durchsuchen, analysieren und visualisieren können.
ELK-Stapel Architektur
Nachdem Sie nun den Stack kennen, erklärt dieser Abschnitt die ELK-Architektur und wie die Daten zwischen den Komponenten fließen.
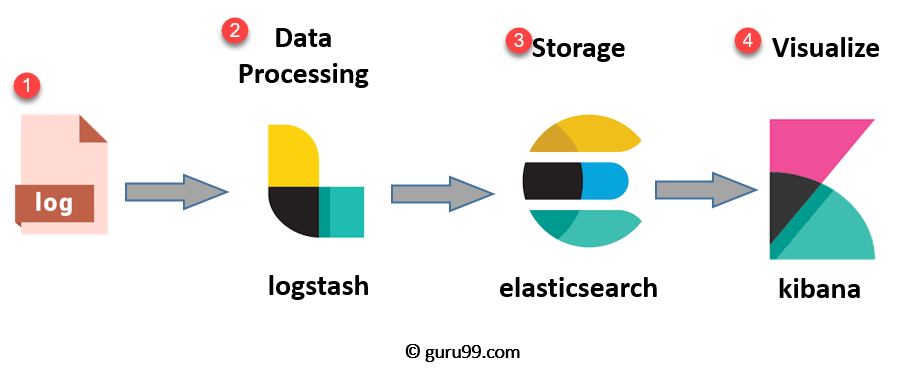
Die ELK-Pipeline folgt einer klaren Abfolge, in der jedes Tool eine feste Aufgabe hat:
- Protokolle: Die zu analysierenden Serverprotokolle wurden identifiziert.
- Logstash: Sammelt die Protokolle und Ereignisdaten, analysiert und transformiert sie anschließend.
- Elastische Suche: Die Daten wurden transformiert durch Logstash wird gespeichert, durchsucht und indiziert.
- Kibana: Nutzt die Elasticsearch-Datenbank, um Erkenntnisse zu erforschen, zu visualisieren und zu teilen.
Allerdings wird häufig eine vierte Komponente namens Beats zur Datenerfassung hinzugefügt. Beats sind schlanke Datensammler, die auf Servern installiert werden. Ihre Hinzufügung veranlasste Elastic, ELK in Elastic Stack umzubenennen.
Bei der Verarbeitung sehr großer Datenmengen kann es sinnvoll sein, Kafka oder RabbitMQ vor die Pipeline zu schalten, um Pufferung und Ausfallsicherheit zu gewährleisten.
Zur Erhöhung der Sicherheit kann ein Reverse-Proxy wie Nginx vor den Stack geschaltet werden.

Unter Berücksichtigung der Architektur werden in den folgenden Abschnitten die einzelnen Open-Source-Produkte des Stacks genauer betrachtet.
Was ist Elasticsearch?
Elasticsearch ist ein NoSQL-Datenbank Basierend auf der Lucene-Suchmaschine und entwickelt mit RESTful APIs. Es bietet einfache Bereitstellung, hohe Zuverlässigkeit und unkomplizierte Verwaltung und speichert alle Ihre Daten zentral, sodass Sie sowohl komplexe Abfragen als auch schnelle Dokumentensuchen durchführen können.
Elasticsearch ermöglicht außerdem das Speichern, Durchsuchen und Analysieren großer Datenmengen. Es wird am häufigsten als zugrundeliegende Engine für Anwendungen mit anspruchsvollen Suchanforderungen eingesetzt.
Da Elasticsearch neben der schnellen Suche auch Analysen und viele weitere fortschrittliche Funktionen bietet, ist es in Suchplattformen für moderne Web- und Mobilanwendungen weit verbreitet.
Funktionen von Elasticsearch
Elasticsearch bietet eine Vielzahl von Funktionen zum Indizieren und Durchsuchen von Daten:
- Ein Open-Source-Suchserver, geschrieben in Java.
- Kann beliebige heterogene Daten indizieren.
- Bietet eine REST-API-Webschnittstelle mit JSON-Ausgabe.
- Volltextsuche.
- Suche in nahezu Echtzeit (NRT).
- Ein fragmentierter, replizierter, durchsuchbarer JSON-Dokumentenspeicher.
- Schemafreier, REST- und JSON-basierter verteilter Dokumentenspeicher.
- Mehrsprachigkeit und Geolokalisierungsunterstützung.
Vorteile von Elasticsearch
- Speichert schemalose Daten und kann auch ein Schema für Ihre Daten erstellen.
- Ermöglicht die Bearbeitung von Datensätzen einzeln mithilfe von Multi-Dokument-APIs.
- Unterstützt das Filtern und Abfragen Ihrer Daten, um Erkenntnisse zu gewinnen.
- Basiert auf Apache Lucene und bietet eine RESTful-API.
- Bietet horizontale Skalierbarkeit, Zuverlässigkeit und Mandantenfähigkeit für Echtzeit-Indexierung und schnellere Suche.
- Hilft Ihnen dabei, sowohl vertikal als auch horizontal zu skalieren.
Die folgende Tabelle erläutert die wichtigsten Begriffe, die Ihnen bei der Arbeit mit Elasticsearch begegnen werden:
| Bedingungen | Anwendungsbereich |
|---|---|
| Cluster | Ein Cluster ist eine Sammlung von Knoten, die gemeinsam Ihre Daten speichern und kombinierte Indexierungs- und Suchfunktionen bereitstellen. |
| Knoten | Ein Knoten ist eine einzelne Elasticsearch-Instanz. Er wird beim Start einer Elasticsearch-Instanz erstellt. |
| Index | Ein Index ist eine Sammlung von Dokumenten mit ähnlichen Merkmalen, wie z. B. Kundendaten oder ein Produktkatalog. Er ist nützlich für Indizierungs-, Such-, Aktualisierungs- und Löschvorgänge, und Sie können mehrere Indizes in einem Cluster definieren. |
| DokumentAAA | Ein Dokument ist die grundlegende Informationseinheit, die indexiert werden kann. Es wird als JSON-Schlüssel-Wert-Paar dargestellt, und jedes Dokument ist mit einem Typ und einer eindeutigen ID verknüpft. |
| Scherbe | Jeder Index kann zur Datenverteilung in mehrere Shards aufgeteilt werden. Ein Shard ist der atomare Teil eines Index und kann beim Hinzufügen weiterer Knoten im Cluster verteilt werden. |
Was ist Logstash?
Logstash ist das Datenerfassungstool des Stacks. Es sammelt Dateneingaben und speist sie in Elasticsearch ein, erfasst alle Arten von Daten aus verschiedenen Quellen und stellt sie für die weitere Verwendung zur Verfügung.
Logstash Sie können Daten aus unterschiedlichen Quellen zusammenführen und in die von Ihnen gewählten Zielformate normalisieren. Dadurch können Sie Ihre Daten bereinigen und für eine Vielzahl von Analyse- und Visualisierungsanwendungen zugänglich machen.
Es besteht aus drei Komponenten:
- Eingang: Übergibt Protokolle und wandelt sie in ein maschinenlesbares Format um.
- Filters: Eine Reihe von Bedingungen, die eine bestimmte Aktion bei einem Ereignis auslösen.
- Ausgang: Der Entscheidungsträger, der jedes verarbeitete Ereignis oder Protokoll weiterleitet.
Funktionen Logstash
Logstash beinhaltet mehrere Funktionen, die die Protokollverarbeitung flexibel gestalten:
- Die Ereignisse durchlaufen jede Phase mithilfe interner Warteschlangen.
- Ermöglicht unterschiedliche Eingaben für Ihre Protokolle.
- Unterstützt das Filtern und Parsen Ihrer Protokolle.
Vorteile von Logstash
- Zentralisiert Ihre Datenverarbeitung.
- Analysiert eine Vielzahl strukturierter und unstrukturierter Daten und Ereignisse.
- Bietet Plugins zur Anbindung an viele Arten von Eingabequellen und Plattformen.
Was ist Kibana?
Kibana ist das Datenvisualisierungstool, das den ELK-Stack vervollständigt. Es dient zur Visualisierung von Elasticsearch-Dokumenten und hilft Entwicklern, durch interaktive Diagramme, Geodaten und Grafiken, die komplexe Abfragen leicht verständlich machen, schnell einen Überblick über ihre Daten zu gewinnen.
Mit Kibana können Sie Daten, die in Elasticsearch-Indizes gespeichert sind, suchen, anzeigen und mit ihnen interagieren. Es unterstützt Sie außerdem bei der Durchführung fortgeschrittener Analysen. Datenanalyse und präsentieren Sie Ihre Daten in verschiedenen Tabellen, Diagrammen und Karten.
Kibana unterstützt verschiedene Methoden zur Datensuche. Die gängigsten Suchtypen sind unten aufgeführt:
| Suche Art | Anwendungsbereich |
|---|---|
| Freitextsuche | Wird zur Suche nach einer bestimmten Zeichenkette verwendet. |
| Suchen auf Feldebene | Wird verwendet, um innerhalb eines bestimmten Feldes nach einer Zeichenkette zu suchen. |
| Logische Aussagen | Wird verwendet, um Suchvorgänge zu einer logischen Aussage zu kombinieren. |
| Suche in der Nähe | Wird zur Suche nach Begriffen innerhalb einer bestimmten Zeichenreihenfolge verwendet. |
Kibana bietet außerdem eine Reihe leistungsstarker Funktionen zur Erkundung indizierter Daten:
- Ein leistungsstarkes Front-End-Dashboard, das indizierte Informationen aus dem Elasticsearch-Cluster visualisiert.
- Ermöglicht die Echtzeitsuche indizierter Informationen.
- Ermöglicht das Suchen, Anzeigen und Interagieren mit in Elasticsearch gespeicherten Daten.
- Führt Abfragen auf Daten aus und visualisiert die Ergebnisse in Diagrammen, Tabellen und Karten.
- Ein konfigurierbares Dashboard zum Analysieren und Auswerten Logstash Protokolle in Elasticsearch.
- Bietet historische Daten in Form von Grafiken, Diagrammen und mehr.
- Bietet einfach konfigurierbare Echtzeit-Dashboards.
Vorteile und Nachteile von Kibana
Wie jedes Werkzeug hat auch Kibana klare Stärken, die seine Popularität erklären:
- Einfache Visualisierung von Daten.
- Vollständig in Elasticsearch integriert.
- Fungiert als spezielles Visualisierungswerkzeug.
- Bietet Echtzeitanalyse, Diagrammerstellung, Zusammenfassung und Fehlersuche.
- Bietet eine intuitive, benutzerfreundliche Oberfläche.
- Ermöglicht das Teilen von Momentaufnahmen der durchsuchten Protokolle.
- Ermöglicht das Speichern und Verwalten mehrerer Dashboards.
Es gibt jedoch auch einige Einschränkungen, die man beachten sollte:
- Es funktioniert nur mit Elasticsearch als Datenquelle.
- Der Aufbau und die Optimierung komplexer Dashboards können eine steile Lernkurve mit sich bringen.
Warum Log-Analyse?
In Cloud-basierten Infrastrukturen sind Leistung und Isolation von großer Bedeutung.
Die Leistung virtueller Maschinen in der Cloud kann je nach spezifischer Last, Umgebung und Anzahl der aktiven Benutzer variieren, sodass Zuverlässigkeit und Knotenausfälle zu erheblichen Problemen werden können.
A Protokollverwaltungsplattform Es kann all diese Probleme überwachen. Außerdem kann es Betriebssystemprotokolle, Nginx- und IIS-Webserverprotokolle zur Verkehrsanalyse, Anwendungsprotokolle und auf AWS generierte Protokolle verarbeiten (Amazon Web Services).
Letztendlich hilft die Protokollverwaltung. DevOps Ingenieure und Systemadministratoren treffen bessere, datengestützte Entscheidungen. Deshalb ist die Log-Analyse mithilfe des Elastic Stack oder ähnlicher Tools unerlässlich geworden.
ELK vs. Splunk
Eine häufig gestellte Frage ist, wie sich der ELK-Stack im Vergleich zu anderen Systemen verhält. Splunk, eine beliebte kommerzielle Alternative. Die folgende Tabelle fasst die wichtigsten Unterschiede zusammen:
| ELCH | Splunk |
|---|---|
| ELK ist ein Open-Source-Tool. | Splunk ist ein kommerzielles Tool. |
| ELK bietet nicht an Solaris Portabilität dank Kibana. | Splunk-Angebote Solaris Portabilität. |
| Die Verarbeitungsgeschwindigkeit ist streng begrenzt. | Bietet eine präzise und schnelle Bearbeitung. |
| ELK ist ein Technologie-Stack, der aus der Kombination von Elasticsearch, Logstashund Kibana. | Splunk ist ein proprietäres Tool, das sowohl On-Premise- als auch Cloud-Lösungen bietet. |
| In ELK sind Suche, Analyse und Visualisierung erst möglich, nachdem der Stack eingerichtet ist. | Splunk ist ein komplettes, sofort einsatzbereites Datenmanagement-Paket. |
| ELK bietet nur eine eingeschränkte integrierte Anbindung an andere Tools. | Splunk ist nützlich für die Einrichtung von Integrationen mit anderen Tools. |
Case Studies
Viele namhafte Unternehmen setzen auf den ELK Stack, um Protokollierung und Analysen in großem Umfang durchzuführen. Die folgenden Beispiele zeigen, wie er in der Produktion eingesetzt wird.
Netflix
Netflix setzt stark auf den ELK Stack, um die Sicherheitsprotokolle seiner Kundendienstprozesse zu überwachen und zu analysieren. Die Plattform ermöglicht es Netflix Dokumente in mehr als fünfzehn Clustern mit insgesamt rund 800 Knoten indizieren, speichern und durchsuchen.
Das berufliche Netzwerk LinkedIn nutzt den ELK Stack zur Überwachung von Leistung und Sicherheit. Das Team integrierte ELK mit Kafka, um die Last in Echtzeit zu bewältigen, und der Betrieb erstreckt sich über mehr als 100 Cluster in sechs Rechenzentren.
Tripwire
Tripwire, ein weltweit tätiger Anbieter von Security Information and Event Management (SIEM)-Lösungen, nutzt den ELK Stack zur Unterstützung der Analyse von Informationspaketprotokollen.
Medium
Medium, die beliebte Blog-Plattform, nutzt den ELK Stack, um Produktionsprobleme zu beheben und Fehler zu erkennen. DynamoDB Hotspots. Die Plattform hilft dem Unternehmen, 25 Millionen einzelne Leser und Tausende neuer Beiträge pro Woche zu bedienen.
Vor- und Nachteile des ELK-Stacks
Vorteile
Der ELK Stack bietet mehrere Vorteile, die seine weite Verbreitung erklären:
- Das funktioniert am besten, wenn die Protokolle der verschiedenen Anwendungen eines Unternehmens in einer einzigen ELK-Instanz zusammengeführt werden.
- Es liefert umfassende Erkenntnisse aus dieser einen Instanz und macht das Einloggen in Hunderte von separaten Datenquellen überflüssig.
- Schnelle Installation vor Ort.
- Einfach zu implementieren und sowohl vertikal als auch horizontal skalierbar.
- Elastic bietet viele Sprachclients an, darunter Ruby. PythonPHP, Perl, .NET, Java und JavaSkript.
- Für viele Programmier- und Skriptsprachen stehen Bibliotheken zur Verfügung.
Nachteile
Trotz seiner Stärken weist der ELK Stack einige Nachteile auf, die berücksichtigt werden sollten:
- Bei einem komplexeren System kann die Verwaltung der verschiedenen Komponenten schwierig werden.
- Es gibt eine steile Lernkurve, rechnen Sie also mit einigen Versuchen und Fehlern, während Sie Erfahrung sammeln.
