
Gaußscher Kernel im maschinellen Lernen: Python Kernel-Methoden
 Evelyn Clarke
⚡ Intelligente Zusammenfassung
Gaußsche Kernelmethoden machen nicht-separierbare Daten linear separierbar, ohne jemals die hochdimensionale Merkmalskarte zu erstellen. Diese Anleitung zeigt die Polynomkarte.ping manuell, dann wird ein Random-Fourier-Kernel-Klassifikator in TensorFlow trainiert.
Der Zweck dieses Tutorials besteht darin, einen Datensatz linear trennbar zu machen. Das Tutorial ist in zwei Teile gegliedert:
- Feature-Transformation
- Trainieren Sie einen Kernel-Klassifikator mit TensorFlow
Im ersten Teil werden Sie die Idee hinter der Kernel-Methode im maschinellen Lernen verstehen, während Sie im zweiten Teil sehen werden, wie man einen Kernel-Klassifikator trainiert. TensorFlowSie verwenden den Datensatz für Erwachsene. Ziel dieses Datensatzes ist es, Haushalte mit einem Einkommen unter und über 50 € zu klassifizieren und dabei das Verhalten der einzelnen Haushalte zu analysieren.
Warum brauchen Sie Kernel-Methoden?
Ziel jedes Klassifikators ist die korrekte Klassenzuordnung. Dafür muss der Datensatz trennbar sein. Die untenstehende Grafik zeigt deutlich, dass alle Punkte oberhalb der schwarzen Linie zur ersten Klasse und alle anderen zur zweiten Klasse gehören. Solch einfache Datensätze sind jedoch äußerst selten. Meistens sind die Daten nicht trennbar, was einfachen Klassifikatoren wie der logistischen Regression große Schwierigkeiten bereitet.
import numpy as np
  import matplotlib.pyplot as plt
  from mpl_toolkits.mplot3d import Axes3D
  x_lin = np.array([1,2,3,4,5,6,7,8,9,10])
  y_lin = np.array([2,2,3,2,2,9,6,8,8,9])
  label_lin = np.array([0,0,0,0,0,1,1,1,1,1])

  fig = plt.figure()
  ax=fig.add_subplot(111)
  plt.scatter(x_lin, y_lin, c=label_lin, s=60)
  plt.plot([-2.5, 10], [12.5, -2.5], 'k-', lw=2)
  ax.set_xlim([-5,15])
  ax.set_ylim([-5,15])plt.show()

In der folgenden Abbildung stellen wir einen Datensatz dar, der nicht linear trennbar ist. Wenn wir eine Gerade einzeichnen, werden die meisten Punkte nicht der richtigen Klasse zugeordnet.
Eine Möglichkeit, dieses Problem anzugehen, besteht darin, den Datensatz zu nehmen und die Daten in eine andere Feature-Map zu transformieren. Das bedeutet, dass man eine Funktion verwendet, um die Daten in eine andere Ebene zu verschieben, die linear trennbar sein sollte.
x = np.array([1,1,2,3,3,6,6,6,9,9,10,11,12,13,16,18])
y = np.array([18,13,9,6,15,11,6,3,5,2,10,5,6,1,3,1])
label = np.array([1,1,1,1,0,0,0,1,0,1,0,0,0,1,0,1])
fig = plt.figure()
plt.scatter(x, y, c=label, s=60)
plt.show()
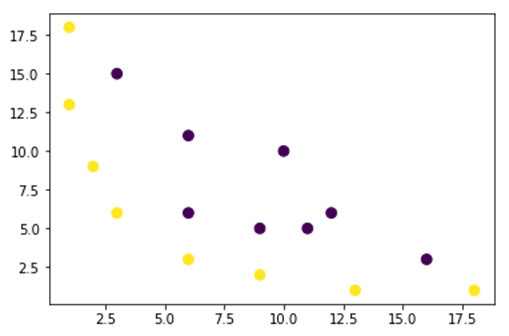
Die Daten aus der obigen Abbildung liegen in einer 2D-Ebene und sind nicht trennbar. Sie können versuchen, diese Daten in drei Dimensionen zu transformieren, indem Sie eine Figur mit drei Achsen erstellen.
In unserem Beispiel mit dem Gaußschen Kernel werden wir eine Polynomabbildung anwenden.ping Um unsere Daten in eine dritte Dimension zu bringen, verwenden wir folgende Formel zur Datentransformation.

Sie definieren eine Funktion im Gaussian Kernel Python um die neuen Feature-Maps zu erstellen.
Sie können verwenden NumPy Um die obige Formel zu kodieren. Jede Zeile unten ordnet jeweils einen Term der Abbildung zu.ping mit dem Array-Ausdruck, der ihn erzeugt, und das kleine Bild markiert den Faktor Quadratwurzel aus zwei.
| Formel | Äquivalenter NumPy-Code |
|---|---|
| x | x[:,0] |
| y | x[:,1] |
| x² | x[:,0]**2 |
 |
np.sqrt(2)* |
| xy | x[:,0]*x[:,1] |
| y² | x[:,1]**2 |
### illustration purpose
def mapping(x, y):
	x = np.c_[(x, y)]
    if len(x) >	2:
    	x_1 = x[:,0]**2
        x_2 = np.sqrt(2)*x[:,0]*x[:,1]
        x_3 = x[:,1]**2
    else:
    	x_1 = x[0]**2
        x_2 = np.sqrt(2)*x[0]*x[1]
        x_3 = x[1]**2
   trans_x = np.array([x_1, x_2, x_3])
   return trans_x
Die neue Karteping hat 3 Dimensionen und 16 Punkte.
x_1  = mapping(x, y)
x_1.shape
(3, 16)
Erstellen Sie nun ein neues Diagramm mit 3 Achsen, x, y und z.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[2], c=label, s=60)
ax.view_init(30, 185)ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')
plt.show()

Wir sehen eine Verbesserung, aber wenn wir die Ausrichtung des Diagramms ändern, wird deutlich, dass die Daten nun trennbar sind.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[1], c=label, s=60)
ax.view_init(0, -180)ax.set_ylim([150,-50])
ax.set_zlim([-10000,10000])
ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')plt.show()

Wenn Sie einen großen Datensatz bearbeiten und mehr als zwei Dimensionen erstellen müssen, stößt die oben beschriebene Methode an ihre Grenzen. Tatsächlich müssten Sie alle Datenpunkte transformieren, was offensichtlich nicht praktikabel ist. Es würde ewig dauern, und der Arbeitsspeicher Ihres Computers könnte erschöpft sein.
Die gebräuchlichste Methode, dieses Problem zu beheben, ist die Verwendung eines Kernels.
Was ist ein Kernel beim maschinellen Lernen?
Die Idee besteht darin, einen höherdimensionalen Merkmalsraum zu verwenden, um die Daten nahezu linear trennbar zu machen, wie in der obigen Abbildung gezeigt.
Es gibt zahlreiche höherdimensionale Räume, in denen die Datenpunkte trennbar sind. Beispielsweise haben wir gezeigt, dass die Polynomabbildungping ist ein guter Anfang.
Wir haben außerdem gezeigt, dass diese Transformationen bei großen Datenmengen nicht effizient sind. Stattdessen kann man in Machine Learning eine Kernel-Funktion verwenden, um die Daten zu modifizieren, ohne zu einer neuen Merkmalsebene zu wechseln.
Der Clou des Kernels besteht darin, eine Funktion zu finden, die alle Probleme der hochdimensionalen Berechnung vermeidet. Das Ergebnis eines Kernels ist ein Skalar, oder anders ausgedrückt: Wir befinden uns wieder im eindimensionalen Raum.
Sobald Sie diese Funktion gefunden haben, können Sie sie in den Standard-Linearklassifikator einfügen.
Hier ist ein Beispiel, das das Konzept des Kernel Machine Learning verdeutlicht. Sie haben zwei Vektoren, x1 und x2. Ziel ist es, mithilfe einer Polynomabbildung eine höhere Dimension zu erzeugen.pingDas Ergebnis entspricht dem Skalarprodukt der neuen Feature-Map. Für die oben beschriebene Methode müssen Sie Folgendes tun:
- Verwandeln Sie x1 und x2 in eine neue Dimension
- Berechnen Sie das Skalarprodukt: allen Kerneln gemeinsam
Verwandeln Sie x1 und x2 in eine neue Dimension
Sie können die oben erstellte Funktion verwenden, um die höhere Dimension zu berechnen.
## Kernel
x1 = np.array([3,6])
x2 = np.array([10,10])

x_1 = mapping(x1, x2)
print(x_1)
Ausgang
[[  9.         100.        ]
      [ 25.45584412 141.42135624]
      [ 36.         100.        ]]
Berechnen Sie das Skalarprodukt
Sie können den Objektpunkt von verwenden. NumPy um das Skalarprodukt zwischen dem ersten und zweiten Vektor, der in x_1 gespeichert ist, zu berechnen.
print(np.dot(x_1[:,0], x_1[:,1]))
8100.0
Das Ergebnis ist 8100. Das Problem liegt darin, dass für die Berechnung des Skalarprodukts eine neue Feature-Map im Speicher abgelegt werden muss. Bei Datensätzen mit Millionen von Einträgen ist dies rechentechnisch ineffizient.
Stattdessen kann man den Polynomkernel verwenden, um das Skalarprodukt zu berechnen, ohne den Vektor zu transformieren. Diese Funktion berechnet das Skalarprodukt von x1 und x2, als wären diese beiden Vektoren in eine höhere Dimension transformiert worden. Anders ausgedrückt: Eine Kernelfunktion berechnet das Ergebnis des Skalarprodukts aus einem anderen Merkmalsraum.
Sie können die polynomische Kernelfunktion in Python wie folgt.
def polynomial_kernel(x, y, p=2):
	return (np.dot(x, y)) ** p
Es ist die Potenz des Skalarprodukts zweier Vektoren. Nachfolgend geben Sie den zweiten Grad des Polynomkerns zurück. Die Ausgabe entspricht der der anderen Methode. Das ist die Magie des Kernels.
polynomial_kernel(x1, x2, p=2)
8100
Arten von Kernel-Methoden
Es gibt viele verschiedene Kernel-Techniken. Die einfachste ist der lineare Kernel. Diese Funktion eignet sich gut für die Textklassifizierung. Weitere Kernel sind:
- Polynomialer Kern
- Gaußscher Kernel
Die Tabelle unten fasst zusammen, was die einzelnen Instrumente bewirken und wann sie in der Praxis zum Einsatz kommen.
| Kernel | Was es berechnet | Typische Verwendung |
|---|---|---|
| Linear | Das einfache Skalarprodukt im ursprünglichen Merkmalsraum | Bereits trennbare Daten- und hochdimensionale Textmerkmale |
| Polynom | Das Skalarprodukt hoch p, das die Interaktionen der Merkmale erfasst | Gekrümmte Grenzen, wenn bekannt ist, dass die Wechselwirkungen von Bedeutung sind |
| Gaußsche Funktion (RBF) | Eine distanzbasierte Ähnlichkeit, die gegen Null tendiert, wenn sich die Punkte voneinander entfernen. | Die übliche erste Wahl, wenn die Form der Grenze unbekannt ist. |
Im Beispiel mit TensorFlow verwenden wir zufällige Fourier-Merkmale. TensorFlow verfügt über einen integrierten Schätzer zur Berechnung des neuen Merkmalsraums. Der Random-Fourier-Feature-Mapper ist eine Approximation der unten dargestellten Gaußschen Kernelfunktion.

Die Gaußsche Filterfunktion berechnet die Ähnlichkeit zwischen den Datenpunkten in einem viel höherdimensionalen Raum.
Nachdem die Theorie geklärt ist, wird im weiteren Verlauf dieser Anleitung ein Gaußscher Kernel auf einen realen Datensatz angewendet.
Trainieren Sie den Gaußschen Kernel-Klassifikator mit TensorFlow
Das Ziel des Algorithmus besteht darin, den Haushalt zu klassifizieren, der mehr oder weniger als 50 verdient.
Zunächst evaluieren Sie eine logistische Regression, um ein Referenzmodell zu erhalten. Anschließend trainieren Sie einen Kernel-Klassifikator, um zu sehen, ob Sie bessere Ergebnisse erzielen können.
Sie verwenden die folgenden Variablen aus dem Datensatz für Erwachsene:
- Alter
- Arbeiterklasse
- fnlwgt
- Ausbildung
- education_num
- ehelich
- Beruf
- Beziehung
- Rennen
- Sex
- Wertzuwachs
- Kapitalverlust
- Stunden_Woche
- Heimatland
- Etikette
Bevor Sie das Modell trainieren und evaluieren, gehen Sie wie folgt vor:
- Importieren Sie die Bibliotheken
- Importieren Sie die Daten
- Bereiten Sie die Daten vor
- Erstellen Sie das logistische Modell: Basismodell
- Bewerten Sie das Modell
- Konstruieren und evaluieren Sie den Kernel-Klassifikator.
Versionshinweis: Alle folgenden Codebeispiele beziehen sich auf TensorFlow 1.x. Der Namespace `tf.contrib`, der `real_valued_column`, `RandomFourierFeatureMapper` und `KernelLinearClassifier` bereitstellt, wurde in TensorFlow 2.0 entfernt, und `tf.estimator` selbst wurde in TensorFlow 2.16 entfernt. Verwenden Sie für eine aktuelle Version die gleiche Pipeline mit der Schicht `tf.keras.layers.experimental.RandomFourierFeatures`, gefolgt von einer Dense-Ausgabeschicht, oder mit dem Paar `RBFSampler` und `SGDClassifier` aus scikit-learn.
Schritt 1) Importieren Sie die Bibliotheken
Zum Importieren und Trainieren von Kernel-Modellen Künstliche IntelligenzSie müssen TensorFlow importieren. Pandas und NumPy.
#import numpy as np
from sklearn.model_selection
import train_test_split
import tensorflow as tf
import pandas as pd
import numpy as np
Schritt 2) Importieren Sie die Daten
Sie laden die Daten von der UCI-Datensatzseite für Erwachsene und importieren Sie es als Pandas DataFrame.
## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country', 'label']
PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"
PATH_test ="https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.test
"## Import
df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_test = pd.read_csv(PATH_test,skiprows = 1, skipinitialspace=True, names = COLUMNS, index_col=False)
Nachdem die Trainings- und Testdaten definiert wurden, können Sie die Spaltenbezeichnung von String in Integer ändern. TensorFlow akzeptiert keine String-Werte für die Bezeichnung.
label = {'<=50K': 0,'>50K': 1}
df_train.label = [label[item] for item in df_train.label]
label_t = {'<=50K.': 0,'>50K.': 1}
df_test.label = [label_t[item] for item in df_test.label]
df_train.shape
(32561, 15)
Schritt 3) Bereiten Sie die Daten vor
Der Datensatz enthält sowohl stetige als auch kategoriale Merkmale. Es empfiehlt sich, die Werte der stetigen Variablen zu standardisieren. Sie können hierfür die Funktion StandardScaler verwenden. scikit-lernenSie erstellen außerdem eine benutzerdefinierte Funktion, um die Konvertierung des Trainings- und Testdatensatzes zu vereinfachen. Beachten Sie, dass Sie die kontinuierlichen und kategorialen Variablen zu einem gemeinsamen Datensatz zusammenführen und das Array vom Typ float32 sein sollte.
COLUMNS_INT = ['age','fnlwgt','education_num','capital_gain', 'capital_loss', 'hours_week']
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']
from sklearn.preprocessing import StandardScaler
from sklearn import preprocessing

def prep_data_str(df):
	scaler = StandardScaler()
    le = preprocessing.LabelEncoder()
    df_toscale = df[COLUMNS_INT]
    df_scaled = scaler.fit_transform(df_toscale.astype(np.float64))
    X_1 = df[CATE_FEATURES].apply(le.fit_transform)
    y = df['label'].astype(np.int32)
    X_conc = np.c_[df_scaled, X_1].astype(np.float32)
    return X_conc, y
Die Transformer-Funktion ist fertig, sodass Sie den Datensatz konvertieren und die input_fn-Funktion erstellen können.
X_train, y_train = prep_data_str(df_train)
X_test, y_test = prep_data_str(df_test)
print(X_train.shape)
(32561, 14)
Im nächsten Schritt trainieren Sie eine logistische Regression. Dadurch erhalten Sie eine Grundgenauigkeit. Das Ziel besteht darin, die Grundlinie mit einem anderen Algorithmus, nämlich einem Kernel-Klassifikator, zu übertreffen.
Schritt 4) Konstruieren Sie das Logistikmodell: Basismodell
Sie konstruieren die Feature-Spalte mit dem Objekt real_valued_column. Dadurch wird sichergestellt, dass es sich bei allen Variablen um dichte numerische Daten handelt.
feat_column = tf.contrib.layers.real_valued_column('features', dimension=14)
Der Schätzer wird mithilfe der TensorFlow Estimator API definiert; Sie geben die Merkmalsspalten und den Speicherort für den Graphen an.
estimator = tf.estimator.LinearClassifier(feature_columns=[feat_column],
                                          n_classes=2,
                                          model_dir = "kernel_log"
                                         )
INFO:tensorflow:Using default config.INFO:tensorflow:Using config: {'_model_dir': 'kernel_log', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a2003f780>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Sie werden die logistische Regression mit Mini-Batches der Größe 200 trainieren.
# Train the model
train_input_fn = tf.estimator.inputs.numpy_input_fn(
	x={"features": X_train},
    y=y_train,
    batch_size=200,
    num_epochs=None,
    shuffle=True)
Das Modell kann mit 1,000 Iterationen trainiert werden.
estimator.train(input_fn=train_input_fn, steps=1000)
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into kernel_log/model.ckpt.
INFO:tensorflow:loss = 138.62949, step = 1
INFO:tensorflow:global_step/sec: 324.16
INFO:tensorflow:loss = 87.16762, step = 101 (0.310 sec)
INFO:tensorflow:global_step/sec: 267.092
INFO:tensorflow:loss = 71.53657, step = 201 (0.376 sec)
INFO:tensorflow:global_step/sec: 292.679
INFO:tensorflow:loss = 69.56703, step = 301 (0.340 sec)
INFO:tensorflow:global_step/sec: 225.582
INFO:tensorflow:loss = 74.615875, step = 401 (0.445 sec)
INFO:tensorflow:global_step/sec: 209.975
INFO:tensorflow:loss = 76.49044, step = 501 (0.475 sec)
INFO:tensorflow:global_step/sec: 241.648
INFO:tensorflow:loss = 66.38373, step = 601 (0.419 sec)
INFO:tensorflow:global_step/sec: 305.193
INFO:tensorflow:loss = 87.93341, step = 701 (0.327 sec)
INFO:tensorflow:global_step/sec: 396.295
INFO:tensorflow:loss = 76.61518, step = 801 (0.249 sec)
INFO:tensorflow:global_step/sec: 359.857
INFO:tensorflow:loss = 78.54885, step = 901 (0.277 sec)
INFO:tensorflow:Saving checkpoints for 1000 into kernel_log/model.ckpt.
INFO:tensorflow:Loss for final step: 67.79706.


<tensorflow.python.estimator.canned.linear.LinearClassifier at 0x1a1fa3cbe0>
Schritt 5) Bewerten Sie das Modell
Sie definieren die NumPy-Eingabefunktion zur Auswertung des Modells. Zur Auswertung verwenden Sie den gesamten Testdatensatz.
# Evaluation
test_input_fn = tf.estimator.inputs.numpy_input_fn(
    x={"features": X_test},
    y=y_test,
    batch_size=16281,
    num_epochs=1,
    shuffle=False)
estimator.evaluate(input_fn=test_input_fn, steps=1)
INFO:tensorflow:Calling model_fn.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:22
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from kernel_log/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Evaluation [1/1]
INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:23
INFO:tensorflow:Saving dict for global step 1000: accuracy = 0.82353663, accuracy_baseline = 0.76377374, auc = 0.84898686, auc_precision_recall = 0.67214864, average_loss = 0.3877216, global_step = 1000, label/mean = 0.23622628, loss = 6312.495, precision = 0.7362797, prediction/mean = 0.21208474, recall = 0.39417577
{'accuracy': 0.82353663,
 'accuracy_baseline': 0.76377374,
 'auc': 0.84898686,
 'auc_precision_recall': 0.67214864,
 'average_loss': 0.3877216,
 'global_step': 1000,
 'label/mean': 0.23622628,
 'loss': 6312.495,
 'precision': 0.7362797,
 'prediction/mean': 0.21208474,
 'recall': 0.39417577}
Ihre Genauigkeit liegt bei 82 Prozent. Im nächsten Abschnitt werden Sie versuchen, den logistischen Klassifikator mit einem Kernel-Klassifikator zu übertreffen.
Schritt 6) Konstruieren Sie den Kernel-Klassifikator
Der Kernel-Schätzer unterscheidet sich, zumindest konstruktionstechnisch, nicht wesentlich vom traditionellen linearen Klassifikator. Die zugrundeliegende Idee besteht darin, die Leistungsfähigkeit einer expliziten Kernel-Abbildung zu nutzen.ping mit dem linearen Klassifikator.
Sie benötigen zwei vordefinierte Schätzer, die in TensorFlow verfügbar sind, um den Kernel-Klassifikator zu trainieren:
- RandomFourierFeatureMapper
- KernelLinearClassifier
Im ersten Abschnitt haben Sie gelernt, dass Sie die niedrige Dimension mithilfe einer Kernelfunktion in eine hohe Dimension transformieren müssen. Genauer gesagt verwenden Sie zufällige Fourier-Merkmale, die die Gauß-Funktion approximieren. TensorFlow 1.x stellt diese Abbildung bereit.ping als RandomFourierFeatureMapper, und das Modell kann mit Hilfe des Schätzers KernelLinearClassifier trainiert werden.
Um das Modell zu erstellen, führen Sie die folgenden Schritte aus:
- Legen Sie die Kernelfunktion mit hoher Dimension fest
- Legen Sie den L2-Hyperparameter fest
- Erstellen Sie das Modell
- Trainiere das Modell
- Bewerten Sie das Modell
Schritt A) Festlegen der hochdimensionalen Kernelfunktion
Der aktuelle Datensatz enthält 14 Merkmale, die Sie in einen neuen 5,000-dimensionalen Vektor transformieren. Für diese Transformation verwenden Sie zufällige Fourier-Merkmale. Wie Sie vielleicht aus der Formel des Gaußschen Kernels wissen, muss ein Standardabweichungsparameter definiert werden. Dieser Parameter steuert das Ähnlichkeitsmaß, das bei der Klassifizierung verwendet wird: Eine kleine Standardabweichung führt dazu, dass der Kernel nur sehr nahe beieinander liegende Punkte als ähnlich behandelt, während eine große Standardabweichung die Entscheidungsgrenze glättet.
Sie können alle Parameter in RandomFourierFeatureMapper optimieren mit:
- input_dim = 14
- output_dim = 5000
- Standardabweichung = 4
### Prep Kernel
kernel_mapper = tf.contrib.kernel_methods.RandomFourierFeatureMapper(input_dim=14, output_dim=5000, stddev=4, name='rffm')
Sie müssen den Kernel-Mapper erstellen, indem Sie die zuvor erstellten Feature-Spalten verwenden: feat_column
### Map Kernel
kernel_mappers = {feat_column: [kernel_mapper]}
Schritt B) Den L2-Hyperparameter festlegen
Um Überanpassung zu vermeiden, wird die Verlustfunktion mit dem L2-Regularisierer bestraft. Der L2-Hyperparameter wird auf 0.1 und die Lernrate auf 5 gesetzt.
optimizer = tf.train.FtrlOptimizer(learning_rate=5, l2_regularization_strength=0.1)
Schritt C) Erstellen Sie das Modell
Der nächste Schritt ähnelt der linearen Klassifizierung. Sie verwenden den integrierten Schätzer KernelLinearClassifier. Beachten Sie, dass Sie den zuvor definierten Kernel-Mapper hinzufügen und das Modellverzeichnis ändern.
### Prep estimator
estimator_kernel = tf.contrib.kernel_methods.KernelLinearClassifier(
    n_classes=2,
    optimizer=optimizer,
    kernel_mappers=kernel_mappers,
    model_dir="kernel_train")
Die folgenden Warnungen bezüglich veralteter Funktionen sind bei TensorFlow 1.x zu erwarten, da das Modul kernel_methods auf den älteren tf.contrib.learn-Schätzern basiert.
WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/kernel_methods/python/kernel_estimators.py:305: multi_class_head (from tensorflow.contrib.learn.python.learn.estimators.head) is deprecated and will be removed in a future version. Instructions for updating: Please switch to tf.contrib.estimator.*_head. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:1179: BaseEstimator.__init__ (from tensorflow.contrib.learn.python.learn.estimators.estimator) is deprecated and will be removed in a future version. Instructions for updating: Please replace uses of any Estimator from tf.contrib.learn with an Estimator from tf.estimator.* WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:427: RunConfig.__init__ (from tensorflow.contrib.learn.python.learn.estimators.run_config) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.RunConfig instead. INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_task_type': None, '_task_id': 0, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a200ae550>, '_master': '', '_num_ps_replicas': 0, '_num_worker_replicas': 0, '_environment': 'local', '_is_chief': True, '_evaluation_master': '', '_train_distribute': None, '_tf_config': gpu_options { per_process_gpu_memory_fraction: 1.0 } , '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_secs': 600, '_log_step_count_steps': 100, '_session_config': None, '_save_checkpoints_steps': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_model_dir': 'kernel_train'}
Schritt D) Trainieren Sie das Modell
Nachdem der Kernel-Klassifikator erstellt wurde, können Sie ihn trainieren. Sie entscheiden sich dafür, das Modell 2,000 Mal zu iterieren.
### estimate
estimator_kernel.fit(input_fn=train_input_fn, steps=2000)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/head.py:678: ModelFnOps.__new__ (from tensorflow.contrib.learn.python.learn.estimators.model_fn) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.EstimatorSpec. You can use the `estimator_spec` method to create an equivalent one. INFO:tensorflow:Create CheckpointSaverHook. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Saving checkpoints for 1 into kernel_train/model.ckpt. INFO:tensorflow:loss = 0.6931474, step = 1 INFO:tensorflow:global_step/sec: 86.6365 INFO:tensorflow:loss = 0.39374447, step = 101 (1.155 sec) INFO:tensorflow:global_step/sec: 80.1986 INFO:tensorflow:loss = 0.3797774, step = 201 (1.247 sec) INFO:tensorflow:global_step/sec: 79.6376 INFO:tensorflow:loss = 0.3908726, step = 301 (1.256 sec) INFO:tensorflow:global_step/sec: 95.8442 INFO:tensorflow:loss = 0.41890752, step = 401 (1.043 sec) INFO:tensorflow:global_step/sec: 93.7799 INFO:tensorflow:loss = 0.35700393, step = 501 (1.066 sec) INFO:tensorflow:global_step/sec: 94.7071 INFO:tensorflow:loss = 0.35535482, step = 601 (1.056 sec) INFO:tensorflow:global_step/sec: 90.7402 INFO:tensorflow:loss = 0.3692882, step = 701 (1.102 sec) INFO:tensorflow:global_step/sec: 94.4924 INFO:tensorflow:loss = 0.34746957, step = 801 (1.058 sec) INFO:tensorflow:global_step/sec: 95.3472 INFO:tensorflow:loss = 0.33655524, step = 901 (1.049 sec) INFO:tensorflow:global_step/sec: 97.2928 INFO:tensorflow:loss = 0.35966292, step = 1001 (1.028 sec) INFO:tensorflow:global_step/sec: 85.6761 INFO:tensorflow:loss = 0.31254214, step = 1101 (1.167 sec) INFO:tensorflow:global_step/sec: 91.4194 INFO:tensorflow:loss = 0.33247527, step = 1201 (1.094 sec) INFO:tensorflow:global_step/sec: 82.5954 INFO:tensorflow:loss = 0.29305756, step = 1301 (1.211 sec) INFO:tensorflow:global_step/sec: 89.8748 INFO:tensorflow:loss = 0.37943482, step = 1401 (1.113 sec) INFO:tensorflow:global_step/sec: 76.9761 INFO:tensorflow:loss = 0.34204718, step = 1501 (1.300 sec) INFO:tensorflow:global_step/sec: 73.7192 INFO:tensorflow:loss = 0.34614792, step = 1601 (1.356 sec) INFO:tensorflow:global_step/sec: 83.0573 INFO:tensorflow:loss = 0.38911164, step = 1701 (1.204 sec) INFO:tensorflow:global_step/sec: 71.7029 INFO:tensorflow:loss = 0.35255936, step = 1801 (1.394 sec) INFO:tensorflow:global_step/sec: 73.2663 INFO:tensorflow:loss = 0.31130585, step = 1901 (1.365 sec) INFO:tensorflow:Saving checkpoints for 2000 into kernel_train/model.ckpt. INFO:tensorflow:Loss for final step: 0.37795097. KernelLinearClassifier(params={'head': <tensorflow.contrib.learn.python.learn.estimators.head._BinaryLogisticHead object at 0x1a2054cd30>, 'feature_columns': {_RealValuedColumn(column_name='features_MAPPED', dimension=5000, default_value=None, dtype=tf.float32, normalizer=None)}, 'optimizer': <tensorflow.python.training.ftrl.FtrlOptimizer object at 0x1a200aec18>, 'kernel_mappers': {_RealValuedColumn(column_name='features', dimension=14, default_value=None, dtype=tf.float32, normalizer=None): [<tensorflow.contrib.kernel_methods.python.mappers.random_fourier_features.RandomFourierFeatureMapper object at 0x1a200ae400>]}})
Schritt E) Modell auswerten
Zu guter Letzt bewerten Sie die Leistung Ihres Modells. Sie sollten in der Lage sein, die logistische Regression zu überwinden.
# Evaluate and report metrics.
eval_metrics = estimator_kernel.evaluate(input_fn=test_input_fn, steps=1)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:50 INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from kernel_train/model.ckpt-2000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Evaluation [1/1] INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:51 INFO:tensorflow:Saving dict for global step 2000: accuracy = 0.83975184, accuracy/baseline_label_mean = 0.23622628, accuracy/threshold_0.500000_mean = 0.83975184, auc = 0.8904007, auc_precision_recall = 0.72722375, global_step = 2000, labels/actual_label_mean = 0.23622628, labels/prediction_mean = 0.23786618, loss = 0.34277728, precision/positive_threshold_0.500000_mean = 0.73001117, recall/positive_threshold_0.500000_mean = 0.5104004
Die endgültige Genauigkeit beträgt 84 %, was etwa 1.6 Prozentpunkte über dem Wert der logistischen Regression liegt (0.83975184 gegenüber 0.82353663). Es besteht ein Zielkonflikt zwischen Genauigkeitsverbesserung und Rechenaufwand. Sie sollten abwägen, ob die Verbesserung den Zeitaufwand des rechenintensiveren Klassifikators rechtfertigt und ob sie einen wesentlichen Einfluss auf Ihr Unternehmen hat.
