
Tutorial zu künstlichen neuronalen Netzen (KNN) mit TensorFlow
 Evelyn Clarke
⚡ Intelligente Zusammenfassung
Künstliche neuronale Netze lernen, indem sie Eingaben durch verbundene Schichten leiten, das Ergebnis mithilfe einer Verlustfunktion bewerten und die Gewichte mit einem Optimierer anpassen. Diese Anleitung erstellt ein solches Netz in TensorFlow und klassifiziert Ziffern aus dem MNIST-Datensatz.
Was ist ein künstliches neuronales Netzwerk?
An Künstliches Neuronales Netz (KNN) Ein künstliches neuronales Netzwerk ist ein von biologischen neuronalen Netzen inspiriertes Computersystem zur Erzeugung künstlicher Gehirne. Es basiert auf einer Vielzahl verbundener Einheiten, sogenannten künstlichen Neuronen. Es ist darauf ausgelegt, Informationen ähnlich wie der Mensch zu analysieren und zu verarbeiten. Künstliche neuronale Netze besitzen Selbstlernfähigkeiten und erzielen mit zunehmender Datenmenge bessere Ergebnisse.
Das untenstehende Diagramm traces ist ein vollständiger Durchlauf durch ein solches Netzwerk, von der Roheingabe bis zum Optimierer, der die Gewichte korrigiert.

Ein künstliches neuronales Netzwerk (KNN) besteht aus vier Hauptobjekten:
- Layers: Der gesamte Lernprozess findet in den Schichten statt. Es gibt drei Schichten: 1) Eingabeschicht, 2) Versteckte Schicht und 3) Ausgabeschicht.
- Merkmal und Bezeichnung: Eingabedaten für das Netzwerk (Merkmale) und Ausgabedaten des Netzwerks (Labels)
- Verlustfunktion: Metrik zur Abschätzung der Leistung der Lernphase
- Optimierer: Verbessern Sie das Lernen, indem Sie das Wissen im Netzwerk aktualisieren.
Ein neuronales Netzwerk verarbeitet die Eingangsdaten in mehreren Schichten. Anschließend bewertet es seine Leistung anhand einer Verlustfunktion. Diese Verlustfunktion gibt dem Netzwerk Aufschluss darüber, welchen Weg es zurücklegen muss, um das Wissen zu beherrschen. Mithilfe eines Optimierers verbessert das Netzwerk dieses Wissen.
Wenn Sie sich die Abbildung oben ansehen, werden Sie den zugrunde liegenden Mechanismus verstehen.
Das Programm nimmt Eingabewerte entgegen und leitet sie an zwei vollständig verbundene Schichten weiter. Stellen Sie sich vor, Sie haben eine Mathematikaufgabe. Zuerst lesen Sie das entsprechende Kapitel, um sie zu lösen. Dann wenden Sie Ihr neues Wissen auf die Aufgabe an. Die Wahrscheinlichkeit ist hoch, dass Sie dabei kein besonders gutes Ergebnis erzielen. Genauso verhält es sich mit einem neuronalen Netzwerk: Wenn es die Daten zum ersten Mal sieht und eine Vorhersage trifft, wird das Ergebnis nicht perfekt mit den tatsächlichen Daten übereinstimmen.
Um sein Wissen zu erweitern, nutzt das Netzwerk einen Optimierer. In dieser Analogie kann man sich den Optimierer wie das erneute Lesen eines Kapitels vorstellen. Durch das erneute Lesen gewinnt man neue Erkenntnisse. Ähnlich verwendet das Netzwerk den Optimierer, aktualisiert sein Wissen und testet dieses neue Wissen, um festzustellen, wie viel es noch lernen muss. Das Programm wiederholt diesen Schritt, bis es den geringstmöglichen Fehler erzielt.
In der Analogie mit den Mathematikaufgaben bedeutet das, dass man ein Kapitel im Lehrbuch so oft liest, bis man den Stoff vollständig verstanden hat. Macht man selbst nach mehrmaligem Lesen immer noch einen Fehler, bedeutet das, dass man die Grenzen des aktuell Gelernten erreicht hat. Man muss ein anderes Lehrbuch verwenden oder eine andere Methode ausprobieren, um seine Leistung zu verbessern. Für ein neuronales Netzwerk ist es derselbe Prozess. Sinkt die Fehlerrate nicht mehr und flacht die Verlustkurve ab, kann die aktuelle Architektur nichts mehr lernen. Das Netzwerk muss besser optimiert werden, um sein Wissen zu erweitern.
Diese vier Objekte entsprechen direkt den Komponenten, die Sie beim Entwurf eines Netzwerks konfigurieren.
Neurales Netzwerk Architektur
Die Architektur des künstlichen neuronalen Netzes besteht aus folgenden Komponenten:
- Schichten
- Aktivierungsfunktion
- Verlustfunktion
- Optimierer
Schichten
In einer Schicht findet der gesamte Lernprozess statt. Innerhalb einer Schicht befindet sich eine beliebige Anzahl von Neuronen, von denen jedes seine eigenen Gewichte besitzt. Ein typisches neuronales Netzwerk wird häufig durch dicht vernetzte Schichten (auch vollständig vernetzte Schichten genannt) verarbeitet. Das bedeutet, dass alle Eingaben mit der Ausgabe verbunden sind.
Ein typisches neuronales Netzwerk benötigt einen Eingabevektor und einen Skalar, der die Labels enthält. Die einfachste Variante ist eine binäre Klassifizierung mit nur zwei Klassen: 0 und 1.
Das Netzwerk empfängt ein Eingangssignal, sendet es an alle verbundenen Knoten und berechnet das Signal mithilfe einer Aktivierungsfunktion. Das untenstehende nummerierte Diagramm zeigt einen einzelnen Knoten im Detail, sodass die gewichtete Summe und der Aktivierungsschritt separat dargestellt werden können.

Die obige Abbildung veranschaulicht dieses Prinzip. Die erste Schicht speichert die Eingabewerte. Die zweite Schicht, die sogenannte verborgene Schicht, empfängt die gewichteten Eingabewerte der vorherigen Schicht.
- Der erste Knotenpunkt sind die Eingabewerte.
- Das Neuron wird in einen Eingabeteil und eine Aktivierungsfunktion unterteilt. Der linke Teil empfängt alle Eingaben der vorherigen Schicht. Der rechte Teil ist die Summe der Eingaben, die an eine Aktivierungsfunktion übergeben werden.
- Der Ausgabewert wird aus den verborgenen Schichten berechnet und zur Vorhersage verwendet. Bei der Klassifizierung entspricht er der Anzahl der Klassen. Bei der Regression wird nur ein Wert vorhergesagt.
Aktivierungsfunktion
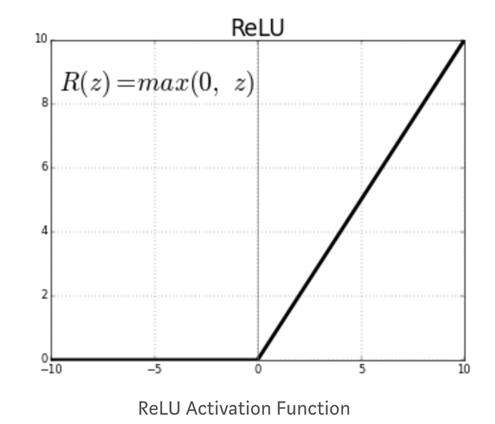
Die Aktivierungsfunktion eines Knotens definiert die Ausgabe bei gegebenen Eingaben. Sie ist notwendig, damit das Netzwerk nichtlineare Muster lernen kann. Eine gängige Aktivierungsfunktion ist ReLU (Rectified Linear Unit). Diese Funktion liefert für alle negativen Werte den Wert Null.
Die anderen Aktivierungsfunktionen sind:
- Stückweise linear
- Sigma
- Tanh
- Undichtes ReLU
Die folgende Grafik zeigt, warum ReLU so beschrieben wird: Die Kurve ist bei Null für jede negative Eingabe flach und steigt danach linear an.
Die entscheidende Entscheidung beim Aufbau eines neuronalen Netzwerks ist:
- Wie viele Schichten im neuronalen Netzwerk
- Wie viele versteckte Einheiten für jede Ebene
Neuronale Netze mit vielen Schichten und verborgenen Einheiten können eine komplexe Repräsentation der Daten erlernen, aber sie machen die Berechnung des Netzes sehr aufwendig.
Verlustfunktion
Nachdem Sie die verborgenen Schichten und die Aktivierungsfunktion definiert haben, müssen Sie die Verlustfunktion und den Optimierer angeben.
Bei der binären Klassifizierung ist es üblich, eine binäre Kreuzentropie-Verlustfunktion zu verwenden. lineare RegressionSie verwenden den mittleren quadratischen Fehler.
Die Verlustfunktion ist eine wichtige Metrik zur Schätzung der Leistung des Optimierers. Während des Trainings wird diese Metrik minimiert. Sie müssen diese Menge je nach Art des Problems, mit dem Sie es zu tun haben, sorgfältig auswählen.
Optimierer
Die Verlustfunktion misst die Leistungsfähigkeit des Modells. Der Optimierer hilft dabei, die Gewichte des Netzwerks zu verbessern, um den Verlust zu verringern. Es stehen verschiedene Optimierer zur Verfügung, der gebräuchlichste ist jedoch der stochastische Gradientenabstieg.
Die herkömmlichen Optimierer sind:
- Momentum Duplikatsentfernung, Harmonisierung und Optimierung auf Artikelebene
- Nesterov-beschleunigter Gradient
- AdaGrad
- Adam-Optimierung
ArchiDie Architektur allein garantiert noch kein brauchbares Modell.
Einschränkungen des neuronalen Netzwerks
Im Folgenden werden die Grenzen eines neuronalen Netzes aufgeführt:
Überanpassung
Ein häufiges Problem komplexer neuronaler Netze ist die Schwierigkeit, auf unbekannte Daten zu generalisieren. Ein neuronales Netz mit vielen Gewichten kann zwar spezifische Details im Trainingsdatensatz sehr gut erkennen, dies führt jedoch oft zu Überanpassung. Sind die Daten innerhalb von Gruppen unausgewogen (d. h., in einigen Gruppen sind nicht genügend Daten vorhanden), lernt das Netz zwar während des Trainings sehr gut, kann diese Muster aber nicht auf noch nie gesehene Daten übertragen.
Es gibt einen Kompromiss in Maschinelles Lernen zwischen Optimierung und Generalisierung.
- Die Optimierung eines Modells erfordert die Suche nach den besten Parametern, die den Verlust des Trainingsdatensatzes minimieren.
- Die Generalisierung gibt jedoch Aufschluss darüber, wie sich das Modell bei unsichtbaren Daten verhält.
Um zu verhindern, dass das Modell bestimmte Details oder unerwünschte Muster der Trainingsdaten erfasst, können verschiedene Techniken eingesetzt werden. Die beste Methode ist ein ausgewogener Datensatz mit ausreichend Datenmenge. Die Kunst, Überanpassung zu reduzieren, wird als Regularisierung bezeichnet. Die drei folgenden Techniken stellen gängige Ausgangspunkte dar.
| Technik | Was es einschränkt | Typische Einstellungen in diesem Tutorial |
|---|---|---|
| Netzwerkgröße | Die Anzahl der Schichten und der verborgenen Einheiten | Zwei verborgene Schichten, 300 und 100 Einheiten |
| L1 / L2 Gewichtsregularisierung | Die Größe der Gewichtungskoeffizienten | l1_regularization_strength und l2_regularization_strength von 0.01 |
| Aussteiger | Der Anteil der pro Trainingsschritt abgeschalteten Einheiten | Ausfallquote von 0.3 |
Netzwerkgröße
Ein neuronales Netzwerk mit zu vielen Schichten und verborgenen Einheiten gilt als sehr komplex. Eine einfache Möglichkeit, die Komplexität des Modells zu reduzieren, besteht darin, seine Größe zu verringern. Es gibt keine allgemeingültige Methode, die Anzahl der Schichten zu bestimmen. Man sollte mit einer geringen Anzahl von Schichten beginnen und die Größe schrittweise erhöhen, bis das Modell überangepasst ist.
Gewichtsregulierung
Eine gängige Methode zur Vermeidung von Überanpassung besteht darin, die Gewichte des Netzwerks zu beschränken. Die Beschränkung zwingt die Gewichte des Netzwerks, nur kleine Werte anzunehmen. Die Beschränkung wird der Verlustfunktion des Fehlers hinzugefügt. Es gibt zwei Arten der Regularisierung:
- L1 (Lasso): Die Kosten sind proportional zum Absolutwert der Gewichtungskoeffizienten.
- L2 (Kamm): Die Kosten sind proportional zum Quadrat des Wertes der Gewichtungskoeffizienten.
Aussteiger
Dropout ist eine ungewöhnliche, aber nützliche Technik. Bei einem Netzwerk mit Dropout werden während eines Trainingsschritts einige Einheiten zufällig abgeschaltet, sodass ihr Ausgangssignal auf Null gesetzt wird. Stellen Sie sich ein Array von Gewichten vor: [0.1; 1.7; 0.7; -0.9]. Mit Dropout reduziert sich dieses Array auf [0.1; 0; 0; -0.9], wobei die Nullen zufällig verteilt sind. Die Dropout-Rate ist der Parameter, der den Dropout steuert. Sie gibt an, wie viele Einheiten abgeschaltet werden. Üblicherweise liegt die Rate zwischen 0.2 und 0.5.
Ein kleines interaktives Beispiel macht den Trainingsablauf leicht nachvollziehbar.
Beispiel eines neuronalen Netzwerks in TensorFlow
Hier ist ein Beispiel für ein künstliches neuronales Netzwerk in Aktion, das zeigt, wie ein neuronales Netzwerk bei einem typischen Klassifizierungsproblem funktioniert. Es gibt zwei Eingaben, x1 und x2, die jeweils einen Zufallswert haben. Die Ausgabe ist eine binäre Klasse. Ziel ist es, die Klasse anhand der beiden Merkmale zu klassifizieren. Um diese Aufgabe zu erfüllen, ist die Architektur des neuronalen Netzwerks wie folgt definiert:
- Zwei versteckte Schichten
- Die erste Schicht besteht aus vier vollständig verbundenen Neuronen
- Die zweite Schicht besteht aus zwei vollständig verbundenen Neuronen
- Die Aktivierungsfunktion ist eine ReLU-Funktion.
- Fügen Sie eine L2-Regularisierung mit einer Lernrate von 0.003 hinzu
Das Netzwerk optimiert die Gewichte über 180 Epochen mit einer Batchgröße von 10. In der untenstehenden Animation des ANN-Beispiels können Sie sehen, wie sich die Gewichte im Laufe der Zeit entwickeln und wie das Netzwerk die Klassifizierungskarte verbessert.ping.

Zunächst weist das Netzwerk allen Gewichten Zufallswerte zu.
- Mit den zufälligen Gewichten, also ohne Optimierung, beträgt der Ausgabeverlust 0.453. Die Abbildung unten stellt das Netzwerk in verschiedenen Farben dar.
- Im Allgemeinen stellt die orange Farbe negative Werte dar, während die blauen Farben positive Werte anzeigen.
- Die Datenpunkte haben die gleiche Darstellung: Die blauen Punkte sind die positiven und die orangen Punkte die negativen Werte.

In der zweiten verborgenen Ebene sind die Linien entsprechend dem Vorzeichen ihrer Gewichtung farbig markiert. Die orangefarbenen Linien repräsentieren negative, die blauen positive Gewichtungen.
Wie Sie in der Ausgabekarte sehen könnenpingDas Netzwerk macht ziemlich viele Fehler. Schauen Sie sich nun an, wie sich das Netzwerk nach der Optimierung verhält.
Die Abbildung des untenstehenden Beispiels eines künstlichen neuronalen Netzes (KNN) zeigt die Ergebnisse des optimierten Netzwerks. Zunächst fällt auf, dass das Netzwerk erfolgreich gelernt hat, die Datenpunkte zu klassifizieren. Im Vergleich zur vorherigen Abbildung betrug das anfängliche Gewicht -0.43, während es nach der Optimierung -0.95 beträgt.

Das Konzept lässt sich auf Netzwerke mit mehr verborgenen Schichten und Neuronen verallgemeinern. Sie können die Einstellungen selbst ausprobieren. TensorFlow-Spielplatz.
Im Folgenden wird die gleiche Idee anhand eines realen Datensatzes im Code umgesetzt.
So trainieren Sie ein neuronales Netzwerk mit TensorFlow
Hier ist die schrittweise Anleitung zum Trainieren eines neuronalen Netzes mit TensorFlow ANN unter Verwendung des Schätzers DNNClassifier der API.
Wir werden den MNIST-Datensatz verwenden, um Ihr erstes neuronales Netzwerk zu trainieren. Training eines neuronalen Netzwerks mit TensorFlow ist nicht sehr kompliziert. Der Vorverarbeitungsschritt sieht genau so aus wie in den vorherigen Tutorials. Sie gehen wie folgt vor:
- Importieren Sie die Daten
- Transformieren Sie die Daten
- Konstruiere den Tensor
- Erstellen Sie das Modell
- Trainieren und evaluieren Sie das Modell
- Verbessern Sie das Modell
Versionshinweis: Der Code in dieser Anleitung ist auf die TensorFlow 1.x Estimator API ausgerichtet. Die finale Version des tf-estimator-Pakets wurde mit TensorFlow 2.15 ausgeliefert, und tf.estimator wurde in TensorFlow 2.16 entfernt. Um diese Schritte mit einer aktuellen Version auszuführen, fixieren Sie entweder TensorFlow 2.15 oder erstellen Sie dasselbe zweischichtige Netzwerk mit tf.keras.layers.Dense und model.fit() neu.
Schritt 1) Importieren Sie die Daten
Zunächst müssen Sie die benötigte Bibliothek importieren. Sie können den MNIST-Datensatz wie folgt importieren: scikit-lernen wie im folgenden Beispiel eines TensorFlow-Neuronalen Netzes gezeigt.
Der MNIST-Datensatz ist der am häufigsten verwendete Datensatz zum Testen neuer Techniken oder Algorithmen. Er besteht aus 28×28 Pixel großen Bildern, die jeweils eine handgeschriebene Ziffer von 0 bis 9 zeigen. Ein Zusammenschluss tiefer Faltungsnetzwerke, die mit elastischen Verzerrungen trainiert wurden, reduzierte den Testfehler auf 0.27 Prozent.
import numpy as np
import tensorflow as tf
np.random.seed(1337)
Im ursprünglichen Walkthrough wurden die MNIST-Dateien manuell heruntergeladen und fetch_mldata auf diesen Ordner verwiesen.
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata(' /Users/Thomas/Dropbox/Learning/Upwork/tuto_TF/data/mldata/MNIST original')
print(mnist.data.shape)
print(mnist.target.shape)
API-Hinweis: mldata.org ist nicht mehr online und fetch_mldata wurde in scikit-learn 0.22 entfernt. Ersetzen Sie bei einer aktuellen Installation den obigen Aufruf durch fetch_openml('mnist_784', version=1), wodurch dieselben 70,000 Ziffern heruntergeladen und die identischen Daten- und Zielattribute bereitgestellt werden.
Anschließend werden die Daten aufgeteilt, um die Form beider Datensätze zu ermitteln.
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(mnist.data, mnist.target, test_size=0.2, random_state=42)
y_train  = y_train.astype(int)
y_test  = y_test.astype(int)
batch_size =len(X_train)

print(X_train.shape, y_train.shape,y_test.shape )
Schritt 2) Transformieren Sie die Daten
Im vorherigen Tutorial haben Sie gelernt, dass Sie die Daten transformieren müssen, um den Einfluss von Ausreißern zu begrenzen. In diesem Tutorial zu neuronalen Netzen transformieren Sie die Daten mithilfe des Min-Max-Skalierers. Die Formel lautet:
(X-min_x)/(max_x - min_x)
scikit-learn verfügt bereits über eine Funktion dafür: MinMaxScaler()
## resclae
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
# Train
X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
# test
X_test_scaled = scaler.fit_transform(X_test.astype(np.float64))
Schritt 3) Konstruieren Sie den Tensor
Sie kennen nun die Vorgehensweise zum Erstellen von Tensoren In TensorFlow können Sie den Trainingsdatensatz in eine numerische Spalte umwandeln.
feature_columns = [tf.feature_column.numeric_column('x', shape=X_train_scaled.shape[1:])]
Schritt 4) Erstellen Sie das Modell
Die Architektur des neuronalen Netzes umfasst zwei verborgene Schichten mit 300 Einheiten in der ersten und 100 Einheiten in der zweiten Schicht. Diese Werte basieren auf Erfahrungswerten und nicht auf einer Formel. Sie können sie anpassen und deren Einfluss auf die Genauigkeit des Netzes beobachten.
Um das Modell zu erstellen, verwenden Sie den Estimator `DNNClassifier`. Da der Trainingsdatensatz zehn Klassen enthält, müssen Sie die Anzahl der Klassen auf 10 setzen. Die Syntax des Estimator-Objekts ist Ihnen bereits bekannt. Die Argumente `feature_columns`, `n_classes` und `model_dir` sind genau dieselben wie im vorherigen Tutorial. Das Argument `hidden_units` ist neu: Es steuert sowohl die Anzahl der Schichten als auch die Anzahl der Knoten, die jede Schicht mit dem neuronalen Netzwerk verbindet. Im folgenden Code gibt es zwei verborgene Schichten: Die erste verbindet 300 Knoten, die zweite 100 Knoten.
Um den Schätzer zu erstellen, verwenden Sie tf.estimator.DNNClassifier mit den folgenden Parametern:
- Feature-Spalten: Definieren Sie die Spalten, die im Netzwerk verwendet werden sollen.
- versteckte Einheiten: Definiere die Anzahl der verborgenen Neuronen
- n_Klassen: Legen Sie die Anzahl der vorherzusagenden Klassen fest.
- Modellverzeichnis: Definiere den Pfad von TensorBoard
estimator = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    n_classes=10,
    model_dir = '/train/DNN')
Schritt 5) Trainieren und bewerten Sie das Modell
Sie können die NumPy-Eingabefunktion verwenden, um das Modell zu trainieren und zu evaluieren.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_train_scaled},
    y=y_train,
    batch_size=50,
    shuffle=False,
    num_epochs=None)
estimator.train(input_fn = train_input,steps=1000)
eval_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_test_scaled},
    y=y_test,
    shuffle=False,
    batch_size=X_test_scaled.shape[0],
    num_epochs=1)
estimator.evaluate(eval_input,steps=None)
Ausgang:
{'accuracy': 0.9637143,
 'average_loss': 0.12014342,
 'loss': 1682.0079,
 'global_step': 1000}
Die aktuelle Architektur führt zu einer Genauigkeit von etwa 96 Prozent im Evaluierungsdatensatz.
Schritt 6) Verbessern Sie das Modell
Sie können versuchen, das Modell zu verbessern, indem Sie Regularisierungsparameter hinzufügen.
Der Schätzer verwendet hier einen Proximal-AdaGrad-Optimierer mit einer Dropout-Rate von 0.3 und L1- sowie L2-Stärken von jeweils 0.01. In einem TensorFlow-Netzwerk wird der Optimierer über das Trainingsobjekt gefolgt vom Namen des Optimierers aufgerufen. TensorFlow bietet eine integrierte API für den Proximal-AdaGrad-Optimierer.
Um dem tiefen neuronalen Netzwerk Regularisierung hinzuzufügen, können Sie tf.train.ProximalAdagradOptimizer mit den folgenden Parametern verwenden:
- Lernrate: Lernrate
- L1-Regularisierung: l1-Regularisierungsstärke
- L2-Regularisierung: l2-Regularisierungsstärke
estimator_imp = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    dropout=0.3,
    n_classes = 10,
    optimizer=tf.train.ProximalAdagradOptimizer(
      learning_rate=0.01,
      l1_regularization_strength=0.01,
      l2_regularization_strength=0.01
    ),
    model_dir = '/train/DNN1')
estimator_imp.train(input_fn = train_input,steps=1000)
estimator_imp.evaluate(eval_input,steps=None)
Ausgang:
{'accuracy': 0.95057142,
 'average_loss': 0.17318928,
 'loss': 2424.6499,
 'global_step': 2000}
Die zur Reduzierung von Overfitting gewählten Werte haben die Modellgenauigkeit nicht verbessert. Ihr erstes Modell erreichte eine Genauigkeit von 96 %, während das Modell mit dem L2-Regularisierer eine Genauigkeit von 95 % aufweist. Sie können verschiedene Werte ausprobieren und deren Auswirkungen auf die Genauigkeit beobachten.
