
Tutorial zur linearen Regression mit TensorFlow [Beispiele]
 Redaktion
⚡ Intelligente Zusammenfassung
Die lineare Regression in TensorFlow modelliert die Beziehung zwischen numerischen Merkmalen und einem kontinuierlichen Zielwert. In diesem Beispiel wird ein Bostoner Immobilienpreis-Vorhersagemodell auf drei verschiedene Arten trainiert: mit Pandas, NumPy und der nativen TensorFlow-Eingabepipeline mit dem LinearRegressor-Schätzer.
Was ist lineare Regression?
Lineare Regression Die lineare Regression ist ein statistisches Verfahren zur Modellierung von Beziehungen zwischen zwei Variablen. Dabei wird eine skalare Zielgröße mit einer oder mehreren erklärenden Variablen verglichen. Die Beziehung mit einer erklärenden Variable wird als einfache lineare Regression bezeichnet, die mit mehreren erklärenden Variablen als multiple lineare Regression.
TensorFlow bietet Tools, mit denen Sie die vollständige Kontrolle über die Berechnungen haben. Dies geschieht mit der Low-Level-API. Darüber hinaus ist TensorFlow mit einer Vielzahl von APIs ausgestattet, um viele Aufgaben auszuführen Maschinelles Lernen Algorithmen. Dies ist die High-Level-API, und TensorFlow nennt sie Schätzer.
- Low-Level-APIDie Architektur und Optimierung des Modells von Grund auf neu zu entwickeln, ist für einen Anfänger kompliziert.
- High-Level-APIDefiniere den Algorithmus. Er ist benutzerfreundlich. TensorFlow bietet eine Toolbox namens Schätzer zu konstruieren, zu trainieren, auszuwerten und eine Vorhersage zu treffen.
In diesem Tutorial verwenden Sie die Nur SchätzerDie Berechnungen sind schneller und einfacher umzusetzen. Im ersten Teil wird die Verwendung des Gradientenabstiegs-Optimierers zum Trainieren einer linearen Regression in TensorFlow erläutert. Im zweiten Teil verwenden Sie den Boston-Datensatz, um mithilfe eines TensorFlow-Schätzers den Preis eines Hauses vorherzusagen.
Laden Sie Boston DataSet herunter
So trainieren Sie ein lineares Regressionsmodell
Bevor wir mit dem Training des Modells beginnen, wollen wir uns ansehen, was eine lineare Regression eigentlich ist.
Stellen Sie sich vor, Sie haben zwei Variablen, x und y, und Ihre Aufgabe ist es, den Wert von y anhand des Wertes von x vorherzusagen. Wenn Sie die Daten grafisch darstellen, erkennen Sie einen positiven Zusammenhang zwischen Ihrer unabhängigen Variablen x und Ihrer abhängigen Variablen y, wie das untenstehende Streudiagramm zeigt.

Man kann feststellen, dass y ungefähr gleich 6 ist, wenn x=1, und dass y ungefähr 8.5 ist, wenn x=2.
Dies ist keine sehr genaue Methode und fehleranfällig, insbesondere bei einem Datensatz mit Hunderttausenden von Punkten.
Eine lineare Regression wird mit einer Gleichung ausgewertet. Die Variable y wird durch eine oder mehrere Kovariaten erklärt. In Ihrem Beispiel gibt es nur eine abhängige Variable. Wenn Sie diese Gleichung schreiben müssen, lautet sie:

Mit:
 ist die Verzerrung. Das heißt, wenn x=0, dann ist y=
 ist das Gewicht, das mit x verbunden ist.
 Das ist das Residuum oder der Fehler des Modells. Es umfasst das, was das Modell aus den Daten nicht lernen kann.
Stellen Sie sich vor, Sie passen das Modell an und finden die folgende Lösung für:
- = 3.8
- = 2.78
Sie können diese Zahlen in die Gleichung einsetzen und sie lautet:
y= 3.8 + 2.78x
Sie haben nun eine bessere Methode, die Werte für y zu bestimmen. Das heißt, Sie können x durch einen beliebigen Wert ersetzen, um y vorherzusagen. In der Abbildung unten haben wir x in der Gleichung durch alle Werte des Datensatzes ersetzt und das Ergebnis grafisch dargestellt.

Die rote Linie stellt den angepassten Wert dar, also die y-Werte für jeden x-Wert. Sie müssen den x-Wert nicht kennen, um y vorherzusagen; jedem x-Wert ist ein Wert auf der roten Linie zugeordnet. Vorhersagen sind auch für x-Werte größer als 2 möglich.
Um die lineare Regression auf weitere Kovariaten auszudehnen, können Sie dem Modell zusätzliche Variablen hinzufügen. Der Unterschied zwischen traditioneller Analyse und linearer Regression besteht darin, dass die lineare Regression untersucht, wie y auf jede einzelne Variable x reagiert.
Betrachten wir ein Beispiel. Stellen Sie sich vor, Sie möchten die Umsätze einer Eisdiele vorhersagen. Der Datensatz enthält verschiedene Informationen, wie zum Beispiel das Wetter (regnerisch, sonnig, bewölkt) und Kundeninformationen (Gehalt, Geschlecht, Familienstand).
Die traditionelle Analyse versucht, den Umsatz vorherzusagen, indem sie beispielsweise den Durchschnittswert jeder Variablen berechnet und den Umsatz für verschiedene Szenarien schätzt. Dies führt zu ungenauen Prognosen und beschränkt die Analyse auf das gewählte Szenario.
Wenn Sie die lineare Regression verwenden, können Sie diese Gleichung schreiben:
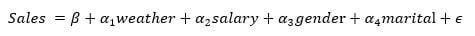
Der Algorithmus wird die beste Lösung für die Gewichte finden; das heißt, er wird versuchen, die Kosten zu minimieren, also die Differenz zwischen der angepassten Linie und den Datenpunkten.
Wie der Algorithmus funktioniert
Das folgende Diagramm fasst die Schleife zusammen, die der Algorithmus wiederholt: Gewichte auswählen, y vorhersagen, den Fehler messen und die Gewichte korrigieren.

Der Algorithmus wählt für jeden eine Zufallszahl  und
 und ersetzen Sie den Wert von x, um den vorhergesagten Wert von y zu erhalten. Wenn der Datensatz 100 Beobachtungen enthält, berechnet der Algorithmus 100 vorhergesagte Werte.
Wir können den Fehler berechnen, notiert  Der Fehler des Modells ist die Differenz zwischen dem vorhergesagten und dem tatsächlichen Wert. Ein positiver Fehler bedeutet, dass das Modell den vorhergesagten Wert von y unterschätzt, ein negativer Fehler bedeutet, dass es ihn überschätzt.

Ihr Ziel ist es, das Quadrat des Fehlers zu minimieren. Der Algorithmus berechnet den Mittelwert des quadratischen Fehlers. Dieser Schritt wird als Fehlerminimierung bezeichnet. Bei der linearen Regression ist dies die Mittlerer quadratischer Fehler, auch MSE genannt. Mathematisch ist es:

Kennzahlen:
 sind die Gewichte, also
 bezieht sich auf den vorhergesagten Wert
- y sind die tatsächlichen Werte
- m ist die Anzahl der Beobachtungen
 bezieht sich auf den vorhergesagten Wert
Beachten Sie, dass  bedeutet, dass die Transponierte der Matrizen verwendet wird. Der
 ist die mathematische Schreibweise des Mittelwerts.
Das Ziel ist es, das Beste zu finden  das minimiert den MSE.
Wenn der durchschnittliche Fehler groß ist, bedeutet dies, dass das Modell eine schlechte Leistung erbringt und die Gewichte nicht richtig gewählt sind. Um die Gewichte zu korrigieren, müssen Sie einen Optimierer verwenden. Der traditionelle Optimierer heißt Gradientenabstieg.
Der Gradientenabstieg bildet die Ableitung und verringert oder erhöht das Gewicht. Ist die Ableitung positiv, wird das Gewicht verringert; ist sie negativ, wird es erhöht. Das Modell aktualisiert die Gewichte und berechnet den Fehler neu. Dieser Prozess wird wiederholt, bis sich der Fehler nicht mehr ändert. Jeder Durchlauf wird als Fehlerdurchlauf bezeichnet. IterationAußerdem werden die Gradienten mit einer Lernrate multipliziert, die die Lerngeschwindigkeit angibt.
Ist die Lernrate zu niedrig, dauert es sehr lange, bis der Algorithmus konvergiert, da er deutlich mehr Iterationen benötigt. Ist die Lernrate zu hoch, konvergiert der Algorithmus möglicherweise nie. Die untenstehende Verlustkurve zeigt den Fehler in Abhängigkeit von der Anzahl der Iterationen für diesen Datensatz.

Aus dem obigen Bild ist ersichtlich, dass das Modell den Prozess etwa 20 Mal wiederholt, bevor es einen stabilen Wert für die Gewichte findet und somit den geringsten Fehler erreicht.
Beachten Sie, dass der Fehler nicht gleich Null ist, sondern sich um 5 stabilisiert. Das bedeutet, dass das Modell einen typischen Fehler von 5 aufweist. Um den Fehler zu reduzieren, müssen Sie dem Modell weitere Informationen hinzufügen, z. B. weitere Variablen, oder andere Schätzer verwenden.
Sie erinnern sich an die erste Gleichung:

Die endgültigen Gewichte sind 3.8 und 2.78. Das folgende Video zeigt, wie der Gradientenabstieg die Verlustfunktion optimiert, um diese Gewichte zu finden.
So trainieren Sie eine lineare Regression mit TensorFlow
Da Sie nun besser verstehen, was hinter der Haube passiert, können Sie die von TensorFlow bereitgestellte Schätzer-API verwenden, um Ihre erste lineare Regression mit TensorFlow zu trainieren.
Versionshinweis: Der unten dargestellte Estimator-Workflow wurde für TensorFlow 1.x und die frühen Versionen von 2.x entwickelt. TensorFlow hat die tf.estimator und tf.feature_column Die APIs sind in Version 2.12 vollständig veraltet und die Estimators wurden in Version 2.16 entfernt. Führen Sie diesen Code bei einer aktuellen Installation in einem TensorFlow 1.15- oder 2.x-Container aus.tf.compat.v1 Umgebung oder portieren Sie es nach Keras, wo tf.keras.layers.Dense(1) Zusätzlich ersetzen Vorverarbeitungsschichten den LinearRegressor und die Merkmalsspalten. Die Konzepte – Merkmale, Labels, Batches, Epochen, MSE und Gradientenabstieg – bleiben unverändert.
Sie werden den Boston-Datensatz verwenden, der die folgenden Variablen enthält.
| Variable | Beschreibung |
| kriminell | Pro-Kopf-Kriminalitätsrate nach Stadt |
| zn | Anteil des Wohngrundstücks, das für Grundstücke über 25,000 Quadratfuß ausgewiesen ist. |
| Indus | Anteil der Nicht-Einzelhandelsflächen pro Stadt. |
| Nox | Stickoxidkonzentration |
| rm | durchschnittliche Zimmeranzahl pro Wohnung |
| Alter | Anteil der vor 1940 gebauten Eigentumswohnungen |
| dis | gewichtete Entfernungen zu fünf Bostoner Arbeitsvermittlungszentren |
| Steuer | Vollwert-Grundsteuersatz pro 10,000 Dollar |
| ptratio | Schüler-Lehrer-Verhältnis nach Stadt |
| mit V | Medianwert der Eigentumswohnungen in Tausend Dollar |
Sie erstellen drei verschiedene Datensätze:
| Datensatz | Ziel | gestalten |
| Training | Trainieren Sie das Modell und ermitteln Sie die Gewichte | 400, 10 |
| Evaluierung | Bewerten Sie die Leistung des Modells anhand unsichtbarer Daten | 100, 10 |
| Vorhersagen | Verwenden Sie das Modell, um den Hauswert anhand neuer Daten vorherzusagen | 6, 10 |
Ziel ist es, anhand der Merkmale des Datensatzes den Wert des Hauses vorherzusagen.
Im zweiten Teil des Tutorials lernen Sie, wie Sie TensorFlow verwenden und die Daten auf drei verschiedene Arten importieren:
- Mit Pandas
- Mit NumPy
- Nur TensorFlow
Beachten Sie, dass alle drei Optionen zum gleichen Ergebnis führen.
Sie lernen, wie Sie die High-Level-API verwenden, um ein lineares Regressionsmodell von TensorFlow zu erstellen, zu trainieren und zu evaluieren. Bei Verwendung der Low-Level-API müssten Sie Folgendes manuell definieren:
- Verlustfunktion
- Optimierer: Gradientenabstieg
- Matrix-Multiplikation
- Graph und Tensor
Das ist mühsam und für einen Anfänger komplizierter.
Pandas-Lösung
Sie müssen die erforderlichen Bibliotheken importieren, um das Modell zu trainieren.
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
Schritt 1) Importieren Sie die Daten mit Pandas.
Sie definieren die Spaltennamen und speichern sie in COLUMNS. Anschließend können Sie die Daten mit pd.read_csv() importieren.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
Richten Sie jeden Aufruf auf die zuvor heruntergeladenen CSV-Dateien.
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
Sie können die Form der Daten drucken.
print(training_set.shape, test_set.shape, prediction_set.shape)
Ausgang
(400, 10) (100, 10) (6, 10)
Beachten Sie, dass die Zielvariable (y) im Datensatz enthalten ist. Daher müssen Sie zwei weitere Listen definieren: eine, die nur die Merkmale enthält, und eine, die nur den Namen der Zielvariable enthält. Diese beiden Listen teilen Ihrem Schätzer mit, welche Merkmale im Datensatz vorhanden sind und welche Spalte die Zielvariable darstellt.
Dies geschieht mit dem folgenden Code.
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
Schritt 2) Konvertieren Sie die Daten
Sie müssen die numerischen Variablen in das richtige Format konvertieren. TensorFlow bietet eine Methode zur Konvertierung einer kontinuierlichen Variable: tf.feature_column.numeric_column().
Im vorherigen Schritt haben Sie eine Liste von Merkmalen definiert, die Sie in das Modell aufnehmen möchten. Nun können Sie diese Liste verwenden, um die Merkmale in numerische Daten umzuwandeln. Wenn Sie Merkmale aus Ihrem Modell ausschließen möchten, können Sie vor der Erstellung von feature_cols eine oder mehrere Variablen aus der Liste FEATURES entfernen.
Beachten Sie, dass Sie ein/e verwenden werden. Python Eine List Comprehension mit der Liste `FEATURES` erstellt eine neue Liste namens `feature_cols`. Dadurch entfällt das neunmalige Aufrufen von `tf.feature_column.numeric_column()`. Eine List Comprehension ist eine schnellere und elegantere Methode, neue Listen zu erstellen.
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
Schritt 3) Definieren Sie den Schätzer
In diesem Schritt müssen Sie den Schätzer definieren. TensorFlow bietet sechs vordefinierte Schätzer an, drei für Klassifizierungsaufgaben und drei für TensorFlow-Regressionsaufgaben:
- Regressor
- DNNRegressor
- LinearRegressor
- DNNLinearCombinedRegressor
- klassifizieren
- DNNClassifier
- LinearClassifier
- DNNLinearCombinedClassifier
In diesem Tutorial verwenden Sie den linearen Regressor. Um auf diese Funktion zuzugreifen, müssen Sie tf.estimator verwenden.
Die Funktion benötigt zwei Argumente:
- feature_columns: Enthält die Variablen, die in das Modell aufgenommen werden sollen.
- model_dir: Pfad zum Speichern des Graphen, der Modellparameter usw.
TensorFlow erstellt automatisch einen Ordner namens „train“ in Ihrem Arbeitsverzeichnis. Sie müssen diesen Pfad verwenden, um darauf zuzugreifen. TensorBoard, wie im folgenden TensorFlow-Regressionsbeispiel gezeigt wird.
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
Ausgang
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Die Schwierigkeit bei TensorFlow liegt in der Datenzufuhr zum Modell. TensorFlow ist für paralleles Rechnen und sehr große Datensätze ausgelegt. Aufgrund begrenzter Systemressourcen ist es unmöglich, dem Modell alle Daten auf einmal zuzuführen. Daher muss jedes Mal ein Datenbatch übergeben werden. Hierbei handelt es sich um riesige Datensätze mit Millionen oder mehr Datensätzen. Ohne Batch-Verarbeitung tritt ein Speicherfehler auf.
Wenn Ihre Daten beispielsweise 100 Beobachtungen enthalten und Sie eine Stapelgröße von 10 definieren, bedeutet dies, dass das Modell 10 Beobachtungen für jede Iteration erkennt (10*10).
Sobald das Modell alle Daten verarbeitet hat, ist eine Epoche abgeschlossen. Eine Epoche definiert, wie oft das Modell die Daten durchlaufen soll. Es empfiehlt sich, diesen Schritt auf „keine“ zu setzen und das Modell eine festgelegte Anzahl von Iterationen durchführen zu lassen.
Eine weitere wichtige Information ist, ob die Daten vor jeder Iteration gemischt werden sollen. Während des Trainings ist es wichtig, die Daten zu mischen, damit das Modell kein bestimmtes Muster im Datensatz lernt. Lernt das Modell die Details des zugrundeliegenden Datenmusters, fällt es ihm schwer, Vorhersagen für unbekannte Daten zu verallgemeinern. Dies wird als Überanpassung bezeichnet. Das Modell erzielt zwar gute Ergebnisse mit den Trainingsdaten, kann aber für unbekannte Daten keine korrekten Vorhersagen treffen.
TensorFlow vereinfacht diese beiden Schritte. Sobald die Daten in die Pipeline gelangen, weiß das System, wie viele Beobachtungen benötigt werden (Batch) und ob die Daten gemischt werden müssen.
Um TensorFlow anzuweisen, wie das Modell gefüttert werden soll, können Sie pandas_input_fn verwenden. Dieses Objekt benötigt fünf Parameter:
- x: Feature-Daten
- y: Etikettendaten
- Batch_size: Batch. Standardmäßig 128
- num_epoch: Anzahl der Epochen, standardmäßig 1
- Mischen: Daten mischen oder nicht. Standardmäßig keine.
Sie müssen das Modell mehrmals mit Daten füttern, daher definieren Sie eine Funktion, die diesen Vorgang wiederholt. Nennen Sie diese Funktion get_input_fn.
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
Die übliche Methode zur Bewertung der Leistung eines Modells ist:
- Trainiere das Modell
- Evaluieren Sie das Modell anhand eines anderen Datensatzes
- Machen Sie eine Vorhersage
Der TensorFlow-Estimator bietet drei verschiedene Funktionen, um diese drei Schritte einfach durchzuführen.
Schritt 4) Trainiere das Modell
Sie können die Methode `train` des Estimators verwenden, um das Modell anzupassen. Der Estimator benötigt eine `input_fn` und die Anzahl der Schritte. Sie können die oben erstellte Funktion verwenden, um das Modell zu trainieren. Anschließend weisen Sie das Modell an, 1000 Mal zu iterieren. Beachten Sie, dass Sie die Anzahl der Epochen nicht angeben; Sie lassen das Modell 1000 Mal iterieren. Wenn Sie die Anzahl der Epochen auf 1 setzen, iteriert das Modell viermal, da der Trainingsdatensatz 400 Datensätze enthält und die Batchgröße 128 beträgt.
- 128 Zahnreihen
- 128 Zahnreihen
- 128 Zahnreihen
- 16 Zahnreihen
Daher ist es einfacher, die Anzahl der Epochen auf „None“ zu setzen und die Anzahl der Iterationen zu definieren, wie im folgenden TensorFlow-Klassifizierungsbeispiel gezeigt.
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
Ausgang
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Sie können TensorBoard mit folgendem Befehl überprüfen:
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
Schritt 5) Bewerten Sie Ihr Modell
Sie können die Anpassung Ihres Modells an den Testsatz mit dem folgenden Code bewerten:
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
Ausgang
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
Sie können den Verlust mit dem folgenden Code ausdrucken:
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
Ausgang
Loss: 3215.895996
Das Modell weist einen Verlust von 3215 auf. In den zusammenfassenden Statistiken können Sie nachsehen, wie groß der Fehler ist.
training_set['medv'].describe()
Ausgang
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
Aus der obigen Statistik geht hervor, dass der durchschnittliche Hauspreis 22 beträgt, mit einem Mindestpreis von 5 und einem Höchstpreis von 50. Da der angegebene Verlust der mittlere quadratische Fehler ist, beträgt der typische Fehler in den ursprünglichen Einheiten ungefähr die Quadratwurzel aus 32.16, also etwa 5.7 Dollar.
Schritt 6) Machen Sie die Vorhersage
Abschließend können Sie die TensorFlow-Methode `predict` verwenden, um den Wert von sechs Häusern in Boston zu schätzen.
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
Um die Schätzwerte auszugeben, können Sie diesen Code verwenden:
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Ausgang
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
Das Modell prognostiziert folgende Werte:
| Einfamilienhaus | Prognose |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
Beachten Sie, dass wir den wahren Wert dieser sechs Häuser nicht kennen. Im Deep-Learning-Tutorial werden Sie versuchen, das lineare Modell zu übertreffen.
NumPy-Lösung
Dieser Abschnitt erklärt, wie das Modell mithilfe eines NumPy-Estimators trainiert wird, um die Daten einzuspeisen. Die Methode ist dieselbe, nur dass Sie den numpy_input_fn-Estimator verwenden.
Lesen Sie dieselben drei CSV-Dateien, behalten Sie aber nur die rohen NumPy-Arrays mit .values bei.
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
Schritt 1) Importieren Sie die Daten
Zunächst müssen Sie die Merkmalsvariablen von den Zielvariablen unterscheiden. Dies ist sowohl für die Trainingsdaten als auch für die Evaluierungsdaten erforderlich. Es ist schneller, eine Funktion zur Datenaufteilung zu definieren.
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
Sie können die Funktion verwenden, um die Beschriftung von den Merkmalen der Trainings- und Evaluierungsdatensätze zu trennen.
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
Sie müssen die letzte Spalte des Vorhersagedatensatzes ausschließen, da sie nur NaN-Werte enthält.
x_predict = prediction_set_n[:, :-2]
Überprüfen Sie die Form des Arrays. Beachten Sie, dass die Beschriftung keine zweite Dimension haben sollte, also (400,).
print(X_train.shape, y_train.shape, x_predict.shape)
Ausgang
(400, 9) (400,) (6, 9)
Sie können die Merkmalsspalten wie folgt konstruieren:
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
Der Schätzer wird wie zuvor definiert: Sie geben die Merkmalsspalten und den Speicherort für das Diagramm an.
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
Ausgang
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Sie können den NumPy-Estimator verwenden, um die Daten dem Modell zuzuführen und es anschließend zu trainieren. Beachten Sie, dass wir die Funktion `input_fn` zur besseren Lesbarkeit im Voraus definieren.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
Ausgang
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
Sie wiederholen den gleichen Schritt mit einer anderen Eingabefunktion, um Ihr Modell zu evaluieren.
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
Ausgang
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
Abschließend können Sie die Vorhersage berechnen. Sie sollte dem Ergebnis von Pandas ähneln.
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Ausgang
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
TensorFlow-Lösung
Der letzte Abschnitt ist einem reinen TensorFlow Lösung. Diese Methode ist etwas komplizierter als die beiden anderen.
Beachten Sie, dass wenn Sie ein Jupyter NotizbuchUm diese Sitzung ausführen zu können, müssen Sie den Computer neu starten und den Kernel löschen.
TensorFlow bietet ein hervorragendes Tool zum Übergeben von Daten an die Pipeline. In diesem Abschnitt erstellen Sie die Funktion `input_fn` selbst.
Schritt 1) Definieren Sie den Pfad und das Format der Daten
Zunächst deklarieren Sie zwei Variablen mit den Pfaden zu den CSV-Dateien. Beachten Sie, dass Sie zwei Dateien haben: eine für den Trainingsdatensatz und eine für den Testdatensatz.
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
Anschließend müssen Sie die Spalten aus der CSV-Datei auswählen, die Sie verwenden möchten. Wir werden alle Spalten nutzen. Danach müssen Sie den Datentyp jeder Variablen festlegen.
Gleitkommazahlen werden durch [0.] definiert.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
Schritt 2) Definieren Sie die Funktion input_fn
Die Funktion lässt sich in drei Teile unterteilen:
- Importieren Sie die Daten
- Erstellen Sie den Iterator
- Verbrauchen Sie die Daten
Nachfolgend finden Sie den vollständigen Code zur Definition der Funktion. Der Code wird anschließend erläutert.
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
Importieren Sie die Daten
Die Methode `dataset` liest eine CSV-Datei zeilenweise ein. Um das Dataset zu erstellen, müssen Sie das Objekt verwenden. TextLineDatensatz. Ihr Datensatz enthält eine Kopfzeile. Verwenden Sie daher `skip(1)`, um die erste Zeile zu überspringen. Lesen Sie nun nur noch die Daten und schließen Sie die Kopfzeile in der Datenverarbeitung aus. Um das Modell zu trainieren, müssen Sie die Merkmale von den Labels trennen. Die Methode `map` wird verwendet, um Transformationen auf die Daten anzuwenden.
Diese Methode ruft eine Funktion auf, die Sie erstellen müssen, um die Datentransformation festzulegen. Kurz gesagt, Sie müssen die Daten an die Funktion übergeben. TextLineEin Datensatzobjekt wird extrahiert, wobei die Kopfzeile entfernt und eine durch eine Funktion vorgegebene Transformation angewendet wird.
Code Erklärung
- tf.data.TextLineDataset(data_file): Diese Zeile liest die CSV-Datei ein.
- .skip(1): Überspringt den Header
- .map(parse_csv)): Parst die Datensätze in die Tensoren
Sie müssen eine Funktion definieren, die das Map-Objekt anweist. Diese Funktion können Sie parse_csv nennen.
Diese Funktion parst die CSV-Datei mit der Methode `tf.decode_csv` und deklariert die Merkmale und die Bezeichnungen. Die Merkmale können als Wörterbuch oder Tupel deklariert werden. Die Wörterbuchmethode ist praktischer.
Code Erklärung
- tf.decode_csv(value, record_defaults= RECORDS_ALL): Die Methode decode_csv verwendet die Ausgabe von TextLineDatensatz zum Einlesen der CSV-Datei. `record_defaults` weist TensorFlow die Spaltentypen an. In TensorFlow 2.x befindet sich dieses Symbol unter `tf.io.decode_csv`.
- dict(zip(COLUMNS, columns)): Füllt das Wörterbuch mit allen Spalten.tracted während dieser Datenverarbeitung
- features.pop('medv'): Schließt die Zielvariable aus den Merkmalsvariablen aus und erstellt eine Labelvariable.
Das Dataset benötigt weitere Elemente, um die Tensoren iterativ zu speisen. Sie müssen die Methode `repeat` hinzufügen, damit das Dataset das Modell kontinuierlich mit Daten versorgen kann. Ohne diese Methode wird das Modell nur einmal durchlaufen und anschließend einen Fehler ausgeben, da keine weiteren Daten mehr in die Pipeline gelangen.
Anschließend können Sie die Batchgröße mit der Batch-Methode steuern. Das bedeutet, dass Sie dem Datensatz mitteilen, wie viele Daten pro Iteration an die Pipeline übergeben werden sollen. Bei einer zu großen Batchgröße wird das Modell langsamer.
Schritt 3) Erstellen Sie den Iterator
Jetzt sind Sie bereit für den zweiten Schritt: Erstellen Sie einen Iterator, um die Elemente im Datensatz zurückzugeben.
Der einfachste Weg, einen Operator zu erstellen, ist die Methode make_one_shot_iterator.
Anschließend können Sie die Features und Beschriftungen aus dem Iterator erstellen.
Schritt 4) Verbrauchen Sie die Daten
Sie können überprüfen, was mit der Funktion `input_fn` passiert. Sie müssen die Funktion in einer Session aufrufen, um die Daten zu verarbeiten. Versuchen Sie es mit einer Batchgröße von 1.
Beachten Sie, dass die Merkmale in einem Wörterbuch und die Bezeichnung als Array ausgegeben werden.
Es wird die erste Zeile der CSV-Datei angezeigt. Sie können diesen Code mehrmals mit unterschiedlichen Batchgrößen ausführen.
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
Ausgang
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
Schritt 5) Definieren Sie die Feature-Spalte
Sie müssen die numerischen Spalten wie folgt definieren:
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
Beachten Sie, dass Sie alle Variablen in einem Bucket kombinieren müssen.
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
Schritt 6) Erstellen Sie das Modell
Sie können das Modell mit dem Schätzer LinearRegressor trainieren.
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
Ausgang
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Sie benötigen ein Lambda-Funktion Damit Sie die Argumente für die Funktion input_fn schreiben können. Wenn Sie keine Lambda-Funktion verwenden, können Sie das Modell nicht trainieren.
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
Ausgang
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
Sie können die Anpassung Ihres Modells an den Testsatz mit dem folgenden Code bewerten:
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
Ausgang
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
Im letzten Schritt wird der Zielwert anhand der Werte der Merkmalsmatrix vorhergesagt. Sie können ein Wörterbuch mit den vorherzusagenden Werten erstellen. Ihr Modell hat neun Merkmale, daher müssen Sie für jedes einen Wert angeben. Das Modell liefert dann für jedes Merkmal eine Vorhersage.
Im folgenden Code schreiben Sie die Werte der einzelnen Merkmale, die in der df_predict CSV-Datei enthalten sind.
Sie müssen eine neue `input_fn`-Funktion schreiben, da im Datensatz keine Bezeichnungen vorhanden sind. Sie können die `from_tensors`-API des Dataset-Objekts verwenden.
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
Zum Schluss drucken Sie die Vorhersagen aus.
for pred in enumerate(pred_results):
print(pred)
Ausgang
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
Alle drei Pipelines liefern die gleichen sechs Vorhersagen, was bestätigt, dass die Wahl zwischen Pandas, NumPy und einem nativen TensorFlow-Datensatz eine Frage der Bequemlichkeit und nicht der Genauigkeit ist.
