
SAP HANA Architecture: Datenbankübersicht
 Maurer Garcia
⚡ Intelligente Zusammenfassung
SAP HANA ArchiArchitektur, Landschaft und Dimensionierung bilden die Grundlage einer In-Memory-Datenplattform, die auf SUSE Linux basiert und C++Dieser Artikel erläutert den Indexserver, Speichermodule, Zeilen- und Spaltenspeicher, Delta-Merge und Methoden zur Hardware-Dimensionierung.
Was ist SAP HANA-Datenbank?
SAP HANA ist eine speicherzentrierte Datenverwaltungsplattform. Die Datenbank läuft auf SUSE Linux Enterprise Server (SLES) und Red Hat Enterprise Linux (RHEL) und ist geschrieben in C++Es kann für sehr große Arbeitslasten auf mehrere Maschinen skaliert werden.
Hauptvorteile von SAP HANA:
- Extrem schnelle Abfrageleistung, da alle Daten im Arbeitsspeicher geladen werden, wodurch langsame Festplattenzugriffe aus dem kritischen Pfad entfernt werden.
- Die Kombination von OLAP (Online Analytical Processing) und OLTP (Online Transaction Processing) auf derselben Datenbank vereinfacht die Datenlandschaft.
SAP Die HANA-Datenbank besteht aus einer Reihe von In-Memory-Verarbeitungsmodulen. Das Berechnungsmodul ist das zentrale Modul und interagiert mit anderen Modulen wie dem relationalen Modul (Zeilen- und Spaltenspeicher), dem OLAP-Modul, dem Textmodul und dem Graphmodul. Eine relationale Tabelle befindet sich entweder im Zeilen- oder im Spaltenspeicher, und zusätzliche Module verarbeiten Text- und Graphdaten, solange Arbeitsspeicher verfügbar ist.
SAP HANA Architektur
Die Daten im Spaltenspeicher werden mithilfe von Techniken wie Wörterbuchkodierung, Lauflängenkodierung, Sparse-Kodierung, Clusterkodierung und indirekter Kodierung komprimiert. Sobald der Hauptspeicher erschöpft ist, werden nicht verwendete Datenbankobjekte (Tabellen, Sichten usw.) automatisch auf die Festplatte ausgelagert und bei Bedarf wieder geladen.
Administratoren können einzelne Tabellen auch manuell laden oder entladen, indem sie mit der rechten Maustaste auf die Tabelle klicken. SAP HANA Studio und wählen abladen or Laden Sie.
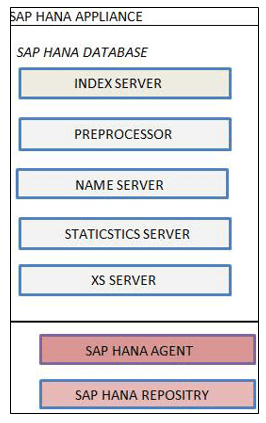
SAP HANA Server besteht aus:
- Index-Server
- Präprozessorserver
- Name Server
- Statistikserver
- XS-Motor
1. SAP HANA-Indexserver
Der Indexserver ist der Haupt SAP HANA-Datenbankkomponente:
- Es ist das Herzstück von SAP HANA-Datenbank-Engine.
- Es enthält die eigentlichen Datenspeicher und die Engines, die die Daten verarbeiten.
- Es führt eingehende SQL- und MDX-Anweisungen aus.
Die Architektur des Indexservers ist unten dargestellt.

SAP Übersicht über den HANA-Indexserver
- Sitzungs- und Transaktionsmanager: Die Session-Komponente verwaltet Verbindungen und Sitzungen für die Datenbank. Der Transaktionsmanager koordiniert und steuert alle Transaktionen.
- SQL- und MDX-Prozessor: Der SQL-Prozessor sendet Anfragen an die entsprechende Engine (SQL / SQL-Skript / R / Calc-Engine). Der MDX-Prozessor verarbeitet mehrdimensionale Anfragen (z. B. an eine analytische Sicht).
- SQL / SQL-Skript / R / Calc Engine: Führt SQL-, SQL-Skript-, R- und Berechnungsmodelle auf den Daten aus.
- Repository: Pflegt die Versionsverwaltung für SAP HANA-Metadatenobjekte wie Attributsichten, analytische Sichten und gespeicherte Prozeduren.
- Persistenzschicht: Bietet eine integrierte Funktion zur Notfallwiederherstellung durch das Schreiben von Sicherungspunkten und Protokollen auf das Datenvolume auf der Festplatte.
2. Präprozessor-Server
Der Preprocessor-Server wird von der Textanalyse verwendet.tracts und bereitet Daten aus Textinhalten auf, wenn die Suchfunktion aufgerufen wird.
3. Nameserver
Der Nameserver enthält Informationen über die gesamte Systemlandschaft. In einer verteilten Bereitstellung ist er tracks speichert alle laufenden Komponenten und den Speicherort der Daten auf den verschiedenen Knoten, damit Abfragen an den richtigen Server weitergeleitet werden können.
4. Statistikserver
Der Statistikserver erfasst Status-, Ressourcenzuweisungs-, Verbrauchs- und Leistungsdaten für den SAP HANA-System. Hinweis: In HANA SPS 7 und höher läuft der eingebettete Statistikdienst innerhalb des Indexservers und nicht als eigenständiger Prozess.
5. XS-Server
Der XS-Server hostet die XS-Engine, die es externen Anwendungen und Entwicklern ermöglicht, die SAP HANA-Datenbank über HTTP. Die XS Engine selbst fungiert als schlanker HTTP-Server und ermöglicht browserbasierten und REST-Clients die direkte Kommunikation mit HANA.
SAP HANA-Landschaft
„HANA“ steht für Hochleistungs-Analysegerät und wird als kombinierte Hardware- und Softwareplattform bereitgestellt.
- Moderne Hardware bietet weitaus mehr CPU-Kerne, RAM und Speicherbandbreite, als für die Nutzung durch ältere Datenbankserver ausgelegt waren.
- SAP HANA nutzt dies aus, indem es keeping Alle Arbeitsdaten befinden sich im Hauptspeicher, wodurch der Engpass durch Festplatten-E/A, der herkömmliche Datenbanken einschränkt, beseitigt wird.
Das folgende Diagramm fasst die SAP HANA-Hardware- und Softwareinnovationen.

SAP HANA unterstützt zwei relationale Datenspeicher: Reihenspeicher und Column Store.
Reihenspeicher
Row Store verhält sich wie eine herkömmliche Datenbank (Oracle, SQL Server). Der Hauptunterschied besteht darin, dass alle Zeilen im Hauptspeicher liegen in SAP HANA, während eine herkömmliche Datenbank die Daten primär auf der Festplatte speichert.
Column Store
Column Store speichert Daten spaltenweise im Speicher. Hier werden Spaltentabellen abgelegt, und die Engine sorgt für ein ausgewogenes Verhältnis zwischen Schreib- und Leseleistung. Das folgende Diagramm veranschaulicht die beiden Strukturen, die dieses Gleichgewicht gewährleisten.

Hauptspeicher
Der Hauptspeicher enthält den Großteil der Daten. Komprimierungsverfahren wie Wörterbuchkodierung, Clusterkodierung, Sparse-Kodierung und Lauflängenkodierung werden angewendet, um Speicherplatz zu sparen und Suchvorgänge zu beschleunigen.
- Das direkte Ändern komprimierter Daten im Hauptspeicher ist aufwändig, daher werden Schreibvorgänge nicht im Hauptspeicher durchgeführt.
- Stattdessen wird jede Änderung in einem separaten Bereich namens „…“ geschrieben. Delta LagerungLesezugriffe können entweder auf den Hauptspeicher oder den Delta-Speicher zutreffen.
Daten können manuell geladen oder entladen werden. In den Speicher laden und Aus dem Speicher entladen Die Optionen sind unten aufgeführt.

Delta Lagerung
Delta Der Speicher ist für Schreibvorgänge optimiert und verwendet eine leichtere Komprimierung. Alle nicht gespeicherten Änderungen an einer Spaltentabelle werden hier gespeichert. Wenn Änderungen in den Hauptspeicher übernommen werden müssen, führen Sie den folgenden Befehl aus: Delta Merge Betrieb von SAP HANA Studio.

- Die Delta-Merge-Funktion überträgt die im Delta-Speicher gesammelten Änderungen in den Hauptspeicher.
- Nach der Zusammenführung werden die neuen Hauptspeicherinhalte auf der Festplatte gespeichert und die Komprimierung neu berechnet.
Wie Daten von Delta zum Hauptspeicher

Ein zeilenorientierter Puffer namens L1-Delta sitzt vor jeder Spaltentabelle, weshalb eine Spaltentabelle Schreibvorgänge mit hohem Durchsatz bewältigen kann.
- Der Benutzer führt eine UPDATE- oder INSERT-Anweisung für die Tabelle aus.
- Die Daten landen zuerst in L1-Delta (unbelegte Daten).
- Sobald die Daten festgeschrieben sind, werden sie in die spaltenorientierte L2-Datenbank verschoben.Delta Puffer.
- Wenn L2-Delta Wenn der Speicher voll ist oder der Merge-Vorgang ausgeführt wird, werden die Daten in den Hauptspeicher geschrieben.
Die Spaltenspeicherung ist daher sowohl schreiboptimiert (durch L1- und L2-Delta) als auch leseoptimiert (durch den Hauptspeicher). Nach der Verarbeitung werden die Daten von der Persistenzschicht auf der Festplatte gespeichert.
Beispiel einer zeilenbasierten Tabelle:

Dieselbe logische Tabelle wird je nach Speichertyp unterschiedlich auf der Festplatte gespeichert. Im Zeilenspeicher werden die Zeilen zusammenhängend geschrieben:

Im Column Store werden Werte aus derselben Spalte zusammen gespeichert:

Da die Spaltenwerte denselben Datentyp haben und sich oft wiederholen, lässt sich das Spaltenlayout extrem gut komprimieren – das ist der größte Speichervorteil des Spaltenspeichers.

SAP HANA-Dimensionierung
Dimensionierung ist der Prozess der Bestimmung der für ein System erforderlichen Hardware-Ressourcen – RAM, Festplatte und CPU. SAP HANA-System. Der Arbeitsspeicher ist der wichtigste Faktor, die CPU der zweitwichtigste, und die Festplatte leitet sich von den beiden erstgenannten ab.
Kurz und SAP Bei der HANA-Implementierung ist die Auswahl der richtigen Servergröße für die Geschäftsauslastung eine der wichtigsten Aufgaben. Im Vergleich zu einem herkömmlichen DBMS unterscheidet sich die Dimensionierung von HANA in drei Bereichen:
- Arbeitsspeicher: angetrieben von Metadaten sowie dem Volumen der im Speicher gehaltenen Transaktions- und Analysedaten.
- ZENTRALPROZESSOR: Die Schätzungen basieren auf Prognosen der Abfrage- und Lastmuster, nicht auf Messungen.
- Scheibe: Ausgelegt auf Datenspeicherung und Protokollvolumen, nicht auf Online-Abfragedaten.
Die CPU und der Arbeitsspeicher des Anwendungsservers bleiben im Vergleich zur vorherigen Datenbank unverändert, da HANA nur die Datenbankebene ersetzt.
SAP bietet mehrere Methoden zur Berechnung der richtigen Größe:
- Dimensionierung mithilfe eines ABAP-Reports (Transaktionscode) ST03 Daten und Bericht /SDF/HDB_SIZING).
- Dimensionierung mittels eines Datenbankskripts für Nicht-ABAP-Systeme.
- Größenbestimmung anhand der SAP Schnellgrößenversteller Werkzeug auf der SAP Service-Marktplatz.
Bei Verwendung des Quick Sizer-Tools wird die Anforderung im folgenden Format angezeigt.

