
K-Mittel ClusterProgrammierung in R mit Beispiel
 Evelyn Clarke
⚡ Intelligente Zusammenfassung
K-Mittel ClusterIn R werden Beobachtungen gruppiert, indem der Abstand zwischen jedem Punkt und seinem Clusterzentrum minimiert wird. Diese Anleitung standardisiert den Datensatz zu Computerpreisen, veranschaulicht den Algorithmus, ermittelt das optimale k mithilfe der Ellbogenmethode und visualisiert die Cluster anhand einer Heatmap.

Was ist Cluster Analyse?
Cluster Die Analyse gehört zu unbeaufsichtigtes Lernen. Ein Cluster ist eine Gruppe von Daten, die ähnliche Merkmale aufweisen. Man könnte sagen, dass es bei der Clusteranalyse eher um Entdeckung als um Vorhersage geht. Die Maschine sucht nach Ähnlichkeiten in den Daten. Sie können die Clusteranalyse beispielsweise für die folgende Anwendung verwenden:
- Kundensegmentierung: Sucht nach Ähnlichkeiten zwischen Kundengruppen
- Aktienmarktclustering: Aktien nach Performance gruppieren
- Reduzierung der Dimensionalität eines Datensatzes durch Gruppierungping Beobachtungen mit ähnlichen Werten
ClusterDie Implementierung einer Analyse ist nicht allzu schwierig und für das Unternehmen sowohl sinnvoll als auch umsetzbar.
Der auffälligste Unterschied zwischen überwachtem und unüberwachtem Lernen liegt in den Ergebnissen. Unüberwachtes Lernen erzeugt eine neue Variable, die Bezeichnung, während überwachtes Lernen ein Ergebnis vorhersagt. Die Maschine unterstützt den Praktiker bei der Suche nach einer Kennzeichnung der Daten auf der Grundlage enger Zusammenhänge. Es ist Sache des Analytikers, die Gruppen zu nutzen und ihnen einen Namen zu geben.
Lassen Sie uns ein Beispiel machen, um das Konzept des Clusterings zu verstehen. Der Einfachheit halber arbeiten wir in zwei Dimensionen. Sie haben Daten über die Gesamtausgaben der Kunden und deren Alter. Um die Werbung zu verbessern, möchte das Marketingteam seinen Kunden gezieltere E-Mails senden.
In der folgenden Grafik stellen Sie die Gesamtausgaben und das Alter der Kunden dar.
library(ggplot2)
df <- data.frame(age = c(18, 21, 22, 24, 26, 26, 27, 30, 31, 35, 39, 40, 41, 42, 44, 46, 47, 48, 49, 54),
    spend = c(10, 11, 22, 15, 12, 13, 14, 33, 39, 37, 44, 27, 29, 20, 28, 21, 30, 31, 23, 24)
)
ggplot(df, aes(x = age, y = spend)) +
    geom_point()

An dieser Stelle ist ein Muster erkennbar
- Unten links sehen Sie junge Menschen mit geringerer Kaufkraft
- Die obere Mitte spiegelt Menschen wider, die einen Job haben, bei dem sie es sich leisten können, mehr auszugeben
- Endlich ältere Menschen mit geringerem Budget.

In der obigen Abbildung clustern Sie die Beobachtungen manuell und definieren jede der drei Gruppen. Dieses Beispiel ist relativ unkompliziert und sehr anschaulich. Wenn dem Datensatz neue Beobachtungen hinzugefügt werden, können Sie diese innerhalb der Kreise beschriften. Sie definieren den Kreis nach unserem Ermessen. Stattdessen können Sie verwenden Maschinelles lernen um die Daten objektiv zu gruppieren.
In diesem Tutorial erfahren Sie, wie Sie die verwenden k-bedeutet Algorithmus.
K-Means-Algorithmus
K-Means ist die am weitesten verbreitete Clustering-Methode. Der Algorithmus stammt aus den 1950er Jahren und wurde seitdem vielfach verfeinert.
Der Algorithmus versucht, Gruppen zu finden, indem er den Abstand zwischen den Beobachtungen minimiert lokal optimal Lösungen. Die Entfernungen werden anhand der Koordinaten der Beobachtungen gemessen. In einem zweidimensionalen Raum sind die Koordinaten beispielsweise einfach x und y.
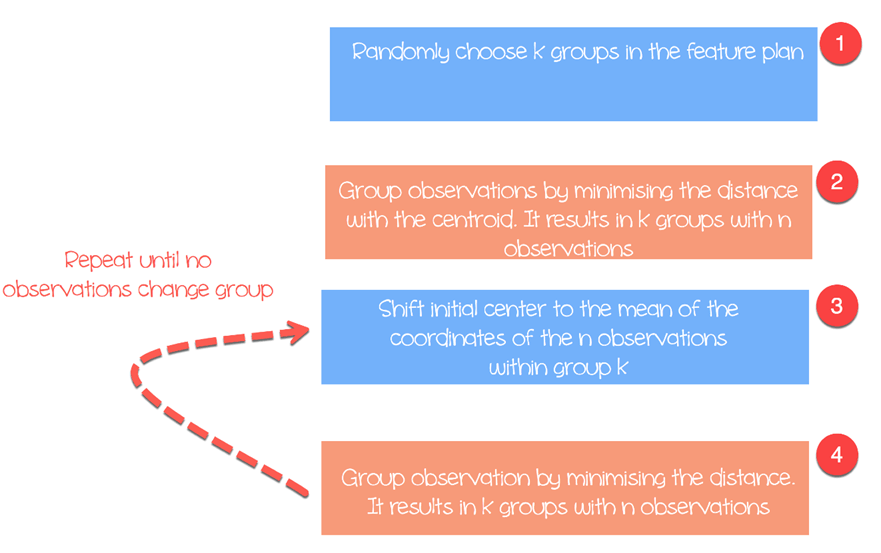
Der Algorithmus funktioniert wie folgt:
- Schritt 1: Wähle k anfängliche Zentroide zufällig im Merkmalsraum aus
- Schritt 2: Ordnen Sie jede Beobachtung ihrem nächstgelegenen Clusterzentrum zu. SchwerpunktDadurch entstehen k Gruppen
- Schritt 3: Shift vom anfänglichen Schwerpunkt zum Mittelwert der Koordinaten innerhalb einer Gruppe.
- Schritt 4: Minimieren Sie den Abstand entsprechend den neuen Schwerpunkten. Neue Grenzen werden geschaffen. Somit werden Beobachtungen von einer Gruppe zur anderen verschoben
- Wiederholen, bis keine Beobachtung die Gruppe ändert
K-Means misst normalerweise den euklidischen Abstand zwischen zwei Beobachtungen x und y:

Es stehen weitere Distanzmaße zur Verfügung, wie beispielsweise die Manhattan- oder die Minkowski-Distanz. Beachten Sie, dass der K-Means-Algorithmus bei jeder Ausführung unterschiedliche Gruppen liefert. Die anfänglichen Distanzwerte sind zufällig, und die Berechnung erfolgt so lange, bis innerhalb der Gruppen eine Homogenität erreicht ist. Daher reagiert der K-Means-Algorithmus sehr empfindlich auf die anfängliche Wahl der Distanzwerte. Sofern die Anzahl der Beobachtungen und Gruppen nicht gering ist, ist es nahezu unmöglich, dieselbe Clusterung zu erzielen.
Auswahl der Anzahl der Cluster
Eine weitere Schwierigkeit bei k-Means ist die Wahl der Clusteranzahl. Man kann einen hohen Wert für k festlegen, was eine große Anzahl von Gruppen bedeutet, um die Homogenität innerhalb der Gruppen zu verbessern, riskiert aber, dass… Überanpassung Die Daten. Überanpassung bedeutet, dass die Leistung bei neuen Daten stark abfällt, da das Modell das Rauschen in dieser speziellen Stichprobe anstatt des zugrunde liegenden Musters auswendig gelernt hat.
Die Anzahl der Cluster hängt von der Art des Datensatzes, der Branche, dem Geschäft usw. ab. Es gibt jedoch eine Faustregel für die Auswahl der geeigneten Clusteranzahl:

wobei n die Anzahl der Beobachtungen im Datensatz ist.
In der Praxis lohnt es sich, Zeit damit zu verbringen, den Wert von k zu finden, der am besten zu den Geschäftsanforderungen passt.
Wir werden den Datensatz „Preise für Personalcomputer“ verwenden, um unsere Clusteranalyse durchzuführen. Dieser Datensatz enthält 6259 Beobachtungen und 10 Merkmale. Der Datensatz beobachtet den Preis von 1993 Personalcomputern in den USA von 1995 bis 486. Die Variablen sind unter anderem Preis, Geschwindigkeit, RAM, Bildschirm und CD.
Sie gehen wie folgt vor:
- Daten importieren
- Trainiere das Modell
- Bewerten Sie das Modell
Daten importieren
K-Means ist für Faktorvariablen ungeeignet, da es mit Distanzen arbeitet und diskrete Labels keine sinnvolle Distanz zueinander aufweisen. Entfernen Sie die drei kategorialen Spalten (cd, multi, premium) zusammen mit dem Zeilenindex X. Dieser Datensatz enthält keine fehlenden Werte.
library(dplyr)
PATH <-"https://raw.githubusercontent.com/guru99-edu/R-Programming/master/computers.csv"
df <- read.csv(PATH) %>%
select(-c(X, cd, multi, premium))
glimpse(df)
Ausgang
## Observations: 6,259
## Variables: 7
## $ price <int> 1499, 1795, 1595, 1849, 3295, 3695, 1720, 1995, 2225, 2...
## $ speed <int> 25, 33, 25, 25, 33, 66, 25, 50, 50, 50, 33, 66, 50, 25, ...
## $ hd <int> 80, 85, 170, 170, 340, 340, 170, 85, 210, 210, 170, 210...
## $ ram <int> 4, 2, 4, 8, 16, 16, 4, 2, 8, 4, 8, 8, 4, 8, 8, 4, 2, 4, ...
## $ screen <int> 14, 14, 15, 14, 14, 14, 14, 14, 14, 15, 15, 14, 14, 14, ...
## $ ads <int> 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, ...
## $ trend  <int> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1...
Aus den zusammenfassenden Statistiken geht hervor, dass die Daten große Werte aufweisen. Vor Anwendung einer distanzbasierten Methode empfiehlt es sich, die Daten zu standardisieren, sodass jede Variable einen Standardwert besitzt. Mittelwert null und Standardabweichung einsOhne sie würde der Preis, dessen Werte in die Tausende gehen, die Entfernungsberechnung dominieren und die Bildschirmgröße würde fast keine Rolle mehr spielen.
summary(df)
Ausgang:
##      price          speed              hd              ram
##  Min.   : 949   Min.   : 25.00   Min.   :  80.0   Min.   : 2.000
##  1st Qu.:1794   1st Qu.: 33.00   1st Qu.: 214.0   1st Qu.: 4.000
##  Median :2144   Median : 50.00   Median : 340.0   Median : 8.000
##  Mean   :2220   Mean   : 52.01   Mean   : 416.6   Mean   : 8.287
##  3rd Qu.:2595   3rd Qu.: 66.00   3rd Qu.: 528.0   3rd Qu.: 8.000
##  Max.   :5399   Max.   :100.00   Max.   :2100.0   Max.   :32.000
##      screen           ads            trend
##  Min.   :14.00   Min.   : 39.0   Min.   : 1.00
##  1st Qu.:14.00   1st Qu.:162.5   1st Qu.:10.00
##  Median :14.00   Median :246.0   Median :16.00
##  Mean   :14.61   Mean   :221.3   Mean   :15.93
##  3rd Qu.:15.00   3rd Qu.:275.0   3rd Qu.:21.50
##  Max.   :17.00   Max.   :339.0   Max.   :35.00
Sie skalieren die Variablen mit der Funktion „scale()“ der dplyr-Bibliothek neu. Die Transformation reduziert den Einfluss von Ausreißern und ermöglicht den Vergleich einer einzelnen Beobachtung mit dem Mittelwert. Wenn ein standardisierter Wert (bzw Z-Score) hoch ist, können Sie sicher sein, dass diese Beobachtung tatsächlich über dem Mittelwert liegt (ein großer Z-Score bedeutet, dass dieser Punkt hinsichtlich der Standardabweichung weit vom Mittelwert entfernt ist. Ein Z-Score von zwei zeigt an, dass der Wert 2 Standard ist Abweichungen vom Mittelwert. Beachten Sie, dass der Z-Score einer Gaußschen Verteilung folgt und symmetrisch um den Mittelwert ist.
# Note: speed is deliberately left out of the scaled data frame
rescale_df <- df %>%
    mutate(price_scal = scale(price),
    hd_scal = scale(hd),
    ram_scal = scale(ram),
    screen_scal = scale(screen),
    ads_scal = scale(ads),
    trend_scal = scale(trend)) %>%
select(-c(price, speed, hd, ram, screen, ads, trend))
R Base verfügt über eine Funktion zum Ausführen des k-Mean-Algorithmus. Die Grundfunktion von k mean ist:
kmeans(df, k)
arguments:
-df: dataset used to run the algorithm
-k: Number of clusters
Trainiere das Modell
In Abbildung drei haben Sie die Funktionsweise des Algorithmus detailliert dargestellt. Sie können jeden Schritt grafisch mit dem Animationspaket von Yihui Xie verfolgen, der auch knitr für R Markdown entwickelt hat. Das Paket ist nicht in den Conda-Kanälen verfügbar, daher installieren Sie es bitte von CRAN.
install.packages("animation")
Nachdem Sie die Bibliothek geladen haben, fügen Sie .ani nach kmeans und hinzu R stellt alle Schritte dar. Zur Veranschaulichung führen Sie den Algorithmus nur mit den neu skalierten Variablen hd und ram mit drei Clustern aus.
set.seed(2345)
library(animation)
kmeans.ani(rescale_df[2:3], 3)
Code Erläuterung
- kmeans.ani(rescale_df[2:3], 3): Wählen Sie die Spalten 2 und 3 des rescale_df-Datensatzes aus und führen Sie den Algorithmus mit k-Sets auf 3 aus. Zeichnen Sie die Animation.


Sie können die Animation wie folgt interpretieren:
- Schritt 1: R wählt zufällig drei Punkte aus
- Schritt 2: Berechnen Sie die euklidische Distanz und zeichnen Sie die Cluster ein. Sie haben unten links einen grünen Cluster, rechts einen großen schwarz gefärbten Cluster und dazwischen einen roten.
- Schritt 3: Berechnen Sie den Schwerpunkt, also den Mittelwert der Cluster
- Wiederholen, bis sich der Cluster nicht mehr von den Daten ändert
Der Algorithmus konvergierte nach sieben Iterationen. Sie können den k-Mean-Algorithmus in unserem Datensatz mit fünf Clustern ausführen und ihn pc_cluster nennen.
pc_cluster <-kmeans(rescale_df, 5)
Die Liste pc_cluster enthält sieben nützliche Elemente:
- pc_cluster$cluster: Der Cluster, der jeder Beobachtung zugeordnet ist
- pc_cluster$centers: Die Clusterzentren
- pc_cluster$totss: Die Gesamtsumme der Quadrate
- pc_cluster$withinss: Summe der Quadrate innerhalb des Clusters, ein Wert pro Cluster
- pc_cluster$tot.withinss: Die Summe von withinss
- pc_cluster$betweenss: Gesamtquadratsumme minus der Quadratsumme innerhalb der Cluster
- pc_cluster$size: Anzahl der Beobachtungen innerhalb jedes Clusters
Sie verwenden die Summe der quadrierten Werte innerhalb (also tot.withinss), um die optimale Anzahl von Clustern k zu berechnen. Die Ermittlung von k ist in der Tat eine umfangreiche Aufgabe.
Wie man das optimale k mit der Ellbogenmethode findet
Eine Technik zur Auswahl des besten k heißt Ellbogenmethode. Diese Methode verwendet Homogenität oder Heterogenität innerhalb der Gruppe, um die Variabilität zu bewerten. Mit anderen Worten, Sie sind an dem Prozentsatz der Varianz interessiert, der durch jeden Cluster erklärt wird. Sie können davon ausgehen, dass die Variabilität mit der Anzahl der Cluster zunimmt, während die Heterogenität abnimmt. Unsere Herausforderung besteht darin, das k zu finden, das jenseits der abnehmenden Erträge liegt. Das Hinzufügen eines neuen Clusters verbessert die Variabilität in den Daten nicht, da nur noch sehr wenige Informationen übrig sind, die erklärt werden müssen.
In diesem Tutorial finden wir diesen Punkt mithilfe des Heterogenitätsmaßes. Die Summe der Quadrate innerhalb der Cluster ist tot.withinss in der von kmean() zurückgegebenen Liste.
Sie können das Ellbogendiagramm erstellen und das optimale k wie folgt ermitteln:
- Schritt 1: Erstellen Sie eine Funktion zur Berechnung der Summe der Quadrate innerhalb der Cluster
- Schritt 2: Führe den Algorithmus für einen Bereich von k-Werten aus.
- Schritt 3: Erstellen Sie einen Datenrahmen mit den Ergebnissen des Algorithmus
- Schritt 4: Zeichnen Sie die Ergebnisse grafisch auf
Schritt 1) Erstellen Sie eine Funktion zur Berechnung der Summe der Quadrate innerhalb von Clustern
Sie erstellen die Funktion, die den K-Mean-Algorithmus ausführt und die Summe der Quadrate innerhalb der Cluster speichert
kmean_withinss <- function(k) {
    cluster <- kmeans(rescale_df, k)
    return (cluster$tot.withinss)
}
Code Erläuterung
- Funktion(k): Legen Sie die Anzahl der Argumente in der Funktion fest
- kmeans(rescale_df, k): Führe den Algorithmus für diesen Wert von k aus.
- return(cluster$tot.withinss): Speichert die Summe der Quadrate innerhalb der Cluster
Teste die Funktion mit k gleich 2.
Ausgang:
## Try with 2 cluster
kmean_withinss(2)
Ausgang:
## [1] 27087.07
Schritt 2) Führen Sie den Algorithmus n-mal aus
Sie verwenden die Funktion sapply(), um den Algorithmus über einen Bereich von k auszuführen. Diese Technik ist schneller als das Erstellen einer Schleife und das Speichern des Werts.
# Set maximum cluster
max_k <-20
# Run algorithm over a range of k
wss <- sapply(2:max_k, kmean_withinss)
Code Erläuterung
- max_k <- 20: Setze den Maximalwert von k auf 20.
- sapply(2:max_k, kmean_withinss): Führen Sie die Funktion kmean_withinss() über einen Bereich von 2:max_k aus, also 2 bis 20.
Schritt 3) Erstellen Sie einen Datenrahmen mit den Ergebnissen des Algorithmus
Nachdem die Funktion geschrieben und getestet wurde, führen Sie sie im Bereich von 2 bis 20 aus und speichern Sie jeden Wert von tot.withinss.
# Create a data frame to plot the graph
elbow <-data.frame(2:max_k, wss)
Code Erläuterung
- data.frame(2:max_k, wss): Erstellen Sie einen Datenrahmen mit der Ausgabe des Algorithmusspeichers in wss
Schritt 4) Plotten Sie die Ergebnisse
Sie zeichnen das Diagramm, um zu visualisieren, wo sich der Ellbogenpunkt befindet
# Plot the graph with gglop
ggplot(elbow, aes(x = X2.max_k, y = wss)) +
    geom_point() +
    geom_line() +
    scale_x_continuous(breaks = seq(1, 20, by = 1))

Aus der Grafik können Sie ersehen, dass das optimale k bei sieben liegt, wobei die Kurve beginnt, eine abnehmende Rendite zu erzielen.
Sobald Sie unser optimales k haben, führen Sie den Algorithmus erneut mit k gleich 7 aus und bewerten die Cluster.
Untersuchung der Cluster
pc_cluster_2 <-kmeans(rescale_df, 7)
Wie bereits erwähnt, können Sie auf die verbleibenden interessanten Informationen in der von kmean() zurückgegebenen Liste zugreifen.
pc_cluster_2$cluster
pc_cluster_2$centers
pc_cluster_2$size
Die Bewertung ist subjektiv und hängt vom Zweck der Cluster ab. Ziel ist es, Computer mit ähnlichen Spezifikationen zu gruppieren. Ein Fachexperte könnte dies manuell durchführen, aber der Prozess wäre langsam und fehleranfällig. K-Means übernimmt diese Gruppierung.ping objektiv und überlässt es dem Experten, das Ergebnis zu interpretieren und zu benennen.
Zur Vorabbewertung können Sie sich die Größe der Cluster ansehen.
pc_cluster_2$size
Ausgang:
## [1] 608 1596 1231 580 1003 699 542
Der größte Cluster (Nummer 2) umfasst 1,596 Beobachtungen, während der kleinste (Nummer 7) nur 542 Computer enthält. Eine Homogenität zwischen den Clustern wäre wünschenswert; andernfalls könnte eine weniger umfangreiche Datenaufbereitung erforderlich sein.
Die Center-Komponente ermöglicht einen detaillierteren Einblick in die Daten. Die Zeilen geben die Nummerierung der Cluster an, die Spalten die vom Algorithmus verwendeten Variablen. Die Werte stellen den durchschnittlichen Score jedes Clusters für die jeweilige Spalte dar. Die Standardisierung erleichtert die Interpretation. Positive Werte zeigen an, dass der z-Score eines Clusters über dem Gesamtmittelwert liegt. Beispielsweise weist Cluster 4 den höchsten Durchschnittspreis auf (price_scal = 1.09), während Cluster 5 den niedrigsten aufweist (-0.82).
center <-pc_cluster_2$centers
center
Ausgang:
##   price_scal    hd_scal     ram_scal screen_scal   ads_scal trend_scal
## 1 -0.6372457 -0.7097995 -0.691520682  -0.4401632  0.6780366 -0.3379751
## 2 -0.1323863  0.6299541  0.004786730   2.6419582 -0.8894946  1.2673184
## 3  0.8745816  0.2574164  0.513105797  -0.2003237  0.6734261 -0.3300536
## 4  1.0912296 -0.2401936  0.006526723   2.6419582  0.4704301 -0.4132057
## 5 -0.8155183  0.2814882 -0.307621003  -0.3205176 -0.9052979  1.2177279
## 6  0.8830191  2.1019454  2.168706085   0.4492922 -0.9035248  1.2069855
## 7  0.2215678 -0.7132577 -0.318050275  -0.3878782 -1.3206229 -1.5490909
Sie können mit ggplot eine Heatmap erstellen, um uns dabei zu helfen, den Unterschied zwischen Kategorien hervorzuheben.
Die Standardfarben von ggplot müssen mit der RColorBrewer-Bibliothek geändert werden. Sie können die Conda verwenden und der Code zum Starten im Terminal:
conda install -c r r-rcolorbrewer
Um eine Heatmap zu erstellen, gehen Sie in drei Schritten vor:
- Erstellen Sie einen Datenrahmen mit den Werten des Zentrums und erstellen Sie eine Variable mit der Nummer des Clusters
- Formen Sie die Daten mit der Funktion „gather()“ der Tidyr-Bibliothek um. Sie möchten Daten von breit nach lang umwandeln.
- Erstellen Sie die Farbpalette mit FarbeRampPalette()-Funktion
Schritt 1) Erstellen Sie einen Datenrahmen
Lassen Sie uns den Umformungsdatensatz erstellen
library(tidyr)

# create dataset with the cluster number

cluster <- c(1: 7)
center_df <- data.frame(cluster, center)

# Reshape the data

center_reshape <- gather(center_df, features, values, price_scal: trend_scal)
head(center_reshape)
Ausgang:
##   cluster   features     values
## 1       1 price_scal -0.6372457
## 2       2 price_scal -0.1323863
## 3       3 price_scal  0.8745816
## 4       4 price_scal  1.0912296
## 5       5 price_scal -0.8155183
## 6       6 price_scal  0.8830191
Schritt 2) Erstelle die Farbpalette
Der unten stehende Code erstellt die Farbpalette, die von der Heatmap verwendet wird.
library(RColorBrewer)
# Create the palette
hm.palette <-colorRampPalette(rev(brewer.pal(10, 'RdYlGn')),space='Lab')
Schritt 3) Visualisieren
Sie können das Diagramm zeichnen und sehen, wie die Cluster aussehen.
# Plot the heat map
ggplot(data = center_reshape, aes(x = features, y = cluster, fill = values)) +
    scale_y_continuous(breaks = seq(1, 7, by = 1)) +
    geom_tile() +
    coord_equal() +
    scale_fill_gradientn(colours = hm.palette(90)) +
    theme_classic()

Wie man mit set.seed() und nstart reproduzierbare K-Means-Ergebnisse erzielt
Im Tutorial wird darauf hingewiesen, dass k-Means bei jedem Durchlauf unterschiedliche Gruppen liefert. Dies ist kein unerklärlicher Fehler, sondern ein Problem, für das es zwei Standardlösungen gibt, die in den obigen Beispielen jedoch nicht verwendet werden.
1. Den Startpunkt mit set.seed() festlegen. Die anfänglichen Zentroide werden zufällig ausgewählt, sodass derselbe Aufruf jedes Mal unterschiedliche Cluster erzeugt. Durch das Festlegen eines Startwerts wird die gesamte Analyse reproduzierbar:
set.seed(123)
pc_cluster_2 <- kmeans(rescale_df, 7)
2. Führen Sie mehrere Starts durch und behalten Sie den besten mit nstart. Ein einzelner zufälliger Startwert kann zu einem ungünstigen lokalen Optimum führen. Das Argument nstart führt den Algorithmus so oft von verschiedenen zufälligen Startwerten aus und gibt denjenigen mit der niedrigsten Summe der Quadrate zurück:
set.seed(123)
pc_cluster_2 <- kmeans(rescale_df, centers = 7, nstart = 25)
Fünfundzwanzig Starts sind die übliche Empfehlung und verursachen bei einem Datensatz dieser Größe nur geringe Kosten. Ohne sie wird die Ellbogenkurve selbst instabil, da jeder Punkt im Diagramm auf einem einzelnen unglücklichen oder glücklichen Start basiert. Die zuvor definierte Funktion `kmean_withinss()` sollte daher wie folgt geschrieben werden:
kmean_withinss <- function(k) {
    cluster <- kmeans(rescale_df, centers = k, nstart = 25)
    return (cluster$tot.withinss)
}
3. Erhöhe iter.max, wenn der Algorithmus eine Warnung ausgibt. Falls R meldet, dass „in 10 Iterationen nicht konvergiert“, setzen Sie iter.max = 50, um mehr Spielraum zu schaffen.
K-Means vs. hierarchische Clustering in R
K-Means ist nicht die einzige verfügbare Clustering-Methode, und die Wahl hängt in der Regel von der Größe der Daten und davon ab, ob man bereits weiß, wie viele Gruppen man haben möchte.
| Eigenschaften | K-Mittel | Hierarchisch |
|---|---|---|
| Anzahl der Cluster | Muss im Voraus ausgewählt werden. | Anschließend ausgewählt, indem das Dendrogramm ausgeschnitten wurde |
| Ergebnisstabilität | Variiert je nach zufälligem Start | Deterministisch |
| Skalierbarkeit | Verarbeitet sehr große Datensätze | Schwierigkeiten jenseits einiger tausend Reihen |
| Cluster gestalten | Setzt annähernd kugelförmige, ähnlich große Gruppen voraus. | Flexibler |
| Ausgang | Ein flacher Satz Etiketten | Ein Dendrogramm, das die verschachtelte Struktur zeigt |
| R-Funktion | kmeans(df, k) | hclust(dist(df)) |
# Hierarchical alternative on the same scaled data
hc <- hclust(dist(rescale_df), method = "ward.D2")
plot(hc)
groups <- cutree(hc, k = 7)
Bei 6,259 Beobachtungen muss die hierarchische Clusteranalyse eine Distanzmatrix von etwa 19.6 Millionen Paaren erstellen. Daher ist k-Means für diesen Datensatz die praktikablere Wahl. k-Means setzt zudem voraus, dass die Cluster ähnliche Größe und annähernd kugelförmige Gestalt aufweisen. Trifft diese Annahme nicht zu, verarbeitet DBSCAN unregelmäßige Formen und identifiziert Ausreißer, anstatt jeden Punkt einer Gruppe zuzuordnen.
K-Mittel Clustering in R: Funktionsreferenz
Alle in diesem Tutorial verwendeten Funktionen sind unten aufgeführt:
| Verpackung | Ziel | Funktion | Argument |
|---|---|---|---|
| Base | Trainieren Sie k-mean | kmeans () | df, k |
| Zugriffscluster | kmeans()$cluster | ||
| Cluster Zentren | kmeans()$centers | ||
| Cluster Größe | kmeans()$size | ||
| Summe der Quadrate | kmeans()$tot.withinss | Wird mit der Ellbogenmethode verwendet | |
| Zwischen Summe der Quadrate | kmeans()$betweenss | ||
| Base | Reproduzierbarer Lauf | set.seed() | Seed-Wert |
| Base | Ergebnis stabilisieren | kmeans(df, k, nstart = 25) | nstart |
