
Wie exportiert man Daten aus R nach CSV und Excel?
 Evelyn Clarke
⚡ Intelligente Zusammenfassung
Der Datenexport aus R umfasst das Schreiben eines Dataframes in die Formate CSV, Excel, SPSS, SAS, STATA und das native R-Format sowie das anschließende Übertragen derselben Datei an [Zielorganisation/Land einfügen]. Google Drive or DropboxJeder Export folgt einem Muster: einer Funktion, einem Datenrahmen und einem Zielpfad.
So exportieren Sie Daten aus R
In diesem Tutorial erfahren Sie, wie Sie Daten aus der R-Umgebung in verschiedene Formate exportieren.
Um Daten auf die Festplatte zu exportieren, benötigen Sie den Dateipfad und eine Erweiterung. Zunächst einmal ist der Pfad der Ort, an dem die Daten gespeichert werden. In diesem Tutorial erfahren Sie, wie Sie Daten speichern auf:
- Die Festplatte
- Google Drive
- Dropbox
Zweitens kann R die Daten in vielen Formaten ausgeben. Dieses Tutorial behandelt die wichtigsten Dateierweiterungen:
- csv
- XLSX
- RDS
- SAS
- SPSS
- STATE
Jeder Export folgt dem gleichen Aufbau: ein Funktionsaufruf, ein Datenrahmen und ein Zielpfad.
Auf Festplatte exportieren
Zunächst können Sie die Daten direkt im Arbeitsverzeichnis speichern. Der folgende Code gibt den Pfad Ihres Arbeitsverzeichnisses aus:
directory <- getwd()
directory
Ausgang:
## [1] "/Users/15_Export_to_do"
Sofern Sie keinen vollständigen Pfad angeben, wird jede Datei in dieses Arbeitsverzeichnis geschrieben. Der Standardpfad variiert je nach System; üblicherweise ist dies das Benutzerverzeichnis. macOS und Linux und der Ordner „Dokumente“ auf Windowsgetwd() gibt jedoch immer den aktuellen Wert zurück. Ändern Sie ihn mit setwd() oder übergeben Sie einfach den vollständigen Pfad an die Schreibfunktion.
setwd("/Users/USERNAME/Downloads")
Datenrahmen erstellen
Zuerst wird ein kleiner Datenrahmen erstellt: der Mittelwert von mpg und disp, gruppiert nach Gang aus dem mtcars-Datensatz.
library(dplyr)
df <-mtcars %>%
    select(mpg, disp, gear) %>%
    group_by(gear) %>%
    summarize(mean_mpg = mean(mpg), mean_disp = mean(disp))
df
Ausgang:
## # A tibble: 3 x 3
##	gear mean_mpg mean_disp
##	<dbl>	<dbl>	<dbl>
## 1	3 16.10667  326.3000
## 2 	4 24.53333  123.0167
## 3	5 21.38000  202.4800
Die Tabelle enthält drei Zeilen und drei Spalten. Sie können eine CSV-Datei mit der Funktion write.csv in R erstellen.
So exportieren Sie einen DataFrame in eine CSV-Datei in R
Die grundlegende Syntax von write.csv in R zum Exportieren des DataFrame nach CSV in R:
write.csv(df, path)
arguments
-df: Dataset to save. Need to be the same name of the data frame in the environment.
-path: A string. Set the destination path. Path + filename + extension i.e. "/Users/USERNAME/Downloads/mydata.csv" or the filename + extension if the folder is the same as the working directory
Ejemplo:
write.csv(df, "table_car.csv")
Code Erläuterung
- write.csv(df, „table_car.csv“): Erstellen Sie eine CSV-Datei auf der Festplatte:
- df: Name des Datenrahmens in der Umgebung
- „table_car.csv“: Benennen Sie die Datei table_car und speichern Sie sie als csv
Hinweis: write.csv2() schreibt die gleiche Datei, wobei ein Semikolon als Feldtrennzeichen und ein Komma als Dezimaltrennzeichen verwendet wird, was in weiten Teilen Kontinentaleuropas üblich ist.
write.csv2(df, "table_car.csv")
HinweisAus didaktischen Gründen haben wir die Funktion `open_folder()` erstellt, um das Verzeichnis für Sie zu öffnen. Führen Sie einfach den unten stehenden Code aus und prüfen Sie, wo die CSV-Datei gespeichert ist. Sie sollten eine Datei namens `table_car.csv` sehen.
# Run this code to create the function
open_folder <-function(dir){
	if (.Platform['OS.type'] == "windows"){
	shell.exec(dir)
	} else {
	system(paste(Sys.getenv("R_BROWSER"), dir))
  }
}
# Call the function to open the folder
open_folder(directory)
Wie exportiert man einen DataFrame in R in eine Excel-Datei?
Der Export nach Excel ist unkompliziert. Windows und etwas schwieriger am macOSBeide verwenden die xlsx-Bibliothek, der Unterschied liegt lediglich in der Installation, da xlsx von dieser Bibliothek abhängt. Java. Java muss auf dem Rechner vorhanden sein, bevor das Paket geladen werden kann.
Windows Nutzer
On WindowsInstallieren Sie die Bibliothek direkt mit conda:
conda install -c r r-xlsx
Sobald die Bibliothek installiert ist, erstellt write.xlsx() eine neue Excel-Arbeitsmappe im Arbeitsverzeichnis:
library(xlsx)
write.xlsx(df, "table_car.xlsx")
Wenn Sie ein Mac OS-Benutzer sind, müssen Sie die folgenden Schritte ausführen:
- Schritt 1: Installieren Sie die neueste Version von Java
- Schritt 2: Installieren Sie die Bibliothek rJava
- Schritt 3: Installieren Sie die Bibliothek xlsx
Schritt 1) Sie können herunterladen Java von offiziell Oracle Website und installieren Sie es.
Sie können zu Rstudio zurückkehren und prüfen, welche Version von Java installiert ist.
system("java -version")
Irgendwelche aktuellen Java Die Freigabe funktioniert. Wenn der Befehl keine Ausgabe liefert, Java ist nicht installiert und das xlsx-Paket kann nicht geladen werden.
Schritt 2) Sie müssen rjava in R installieren. Wir empfehlen Ihnen, R und Rstudio mit Anaconda zu installieren. Anaconda verwaltet die Abhängigkeiten zwischen Bibliotheken. In diesem Sinne wird Anaconda die Feinheiten von r handhabenJava Installation.
Zunächst müssen Sie Conda aktualisieren und dann installieren . Sie können die nächsten beiden Codezeilen kopieren und im Terminal einfügen.
conda update conda
conda install -c r r-rjava
Als nächstes öffnen Sie rjava in Rstudio
library(rJava)
Schritt 3) Schließlich ist es Zeit, xlsx zu installieren. Auch hier können Sie es verwenden conda es zu tun:
conda install -c r r-xlsx
Wie die Windows-Benutzer können Sie Daten mit der Funktion write.xlsx() speichern
library(xlsx)
Ausgang:
## Loading required package: xlsxjars
write.xlsx(df, "table_car.xlsx")
Exportieren von Daten aus R in eine andere Software
Der Export von Daten in andere Software ist so einfach wie der Import. Die Bibliothek „haven“ bietet eine bequeme Möglichkeit, Daten zu exportieren in
- spss
- sas
- war
Importieren Sie zunächst die Bibliothek. Wenn Sie „haven“ nicht haben, können Sie werden auf dieser Seite erläutert um es zu installieren.
library(haven)
SPSS-Datei
Nachfolgend finden Sie den Code zum Exportieren der Daten in die SPSS-Software:
write_sav(df, "table_car.sav")
SAS-Datei
Genauso einfach wie spss können Sie nach sas exportieren
write_sas(df, "table_car.sas7bdat")
STATA-Datei
Schließlich ermöglicht die Port-Bibliothek das Schreiben von .dta-Dateien.
write_dta(df, "table_car.dta")
Wie exportiert man Daten in native R-Formate?
Wenn Sie das Objekt in R behalten und nicht an ein anderes Programm übergeben möchten, verwenden Sie eines der beiden nativen Formate. save() schreibt ein oder mehrere benannte Objekte in eine .RData-Datei:
save(df, file ='table_car.RData')
Die Alternative ist saveRDS(), das genau ein Objekt speichert und dem Leser ermöglicht, dessen Namen beim erneuten Aufruf auszuwählen:
# One object, name chosen at read time
saveRDS(df, file = "table_car.rds")
my_data <- readRDS("table_car.rds")

# Several objects, original names restored
save(df, directory, file = "workspace.RData")
load("workspace.RData")
| Eigenschaften | saveRDS() / readRDS() | save() / load() |
|---|---|---|
| Objekte pro Datei | Genau eins | Ein oder mehrere |
| Objektname beim Neuladen | Du entscheidest es | Wiederhergestellt wie gespeichert |
| Überschreibt die Umgebung | Nein | Ja, stillschweigend. |
| Übliche Erweiterung | .rds | .RData |
Verwenden Sie in Skripten vorzugsweise `saveRDS()`, da `load()` ein vorhandenes Objekt mit demselben Namen unbemerkt überschreiben kann. Beide Formate erhalten Faktorstufen, Reihenfolge und Attribute, was mit CSV nicht möglich ist.
Sie können die oben erstellten Dateien im aktuellen Arbeitsverzeichnis überprüfen

Interagieren Sie mit den Cloud-Diensten
Ostatni, ale nie najmniej, R ist mit fantastischen Bibliotheken ausgestattet, um mit den Cloud-Computing-Diensten zu interagieren. Der letzte Teil dieses Tutorials befasst sich mit dem Export/Import von Dateien aus:
- Google Drive
- Dropbox
HinweisDieser Teil des Tutorials setzt voraus, dass Sie ein Konto bei Google und Dropbox. Wenn nicht, können Sie schnell eines erstellen für – Google Drive: https://accounts.google.com/SignUp?hl=en - Dropbox: https://www.dropbox.com/h
Google Drive
Sie müssen die Bibliothek GoogleDrive installieren, um auf die Funktion zuzugreifen, die die Interaktion mit Google Drive.
Die Bibliothek ist bei Anaconda noch nicht verfügbar. Sie können es mit dem folgenden Code in der Konsole installieren.
install.packages("googledrive")
und Sie öffnen die Bibliothek.
library(googledrive)
Für Nutzer, die Conda nicht verwenden, ist die Installation einer Bibliothek einfach: Sie können `install.packages('NAME DES PAKETS')` verwenden, wobei der Paketname in Anführungszeichen innerhalb der Klammern steht. R installiert die Bibliothek dann im ersten Verzeichnis, das von `.libPaths()` zurückgegeben wird.
Etwas hochladen auf Google Drive
Um eine Datei hochzuladen Google Um auf dem Laufwerk zu fahren, müssen Sie die Funktion drive_upload() verwenden.
Bei jedem Neustart von Rstudio werden Sie aufgefordert, den Zugriff auf Tidyverse zuzulassen Google Drive.
Die grundlegende Syntax von drive_upload() lautet
drive_upload(file, path = NULL, name = NULL)
arguments:
- file: Full name of the file to upload (i.e., including the extension)
- path: Location of the file- name: You can rename it as you wish. By default, it is the local name.
Nachdem Sie den Code gestartet haben, müssen Sie mehrere Fragen bestätigen
drive_upload("table_car.csv", name = "table_car")
Ausgang:
## Local file:
## * table_car.csv
## uploaded into Drive file:
## * table_car: 1hwb57eT-9qSgDHt9CrVt5Ht7RHogQaMk
## with MIME type:
## * text/csv
Sie geben 1 in die Konsole ein, um den Zugriff zu bestätigen
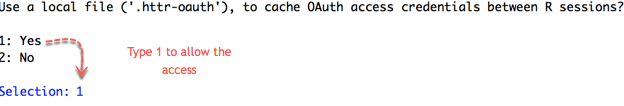
Anschließend werden Sie weitergeleitet zu Google Um den Zugriff über die API zu ermöglichen, klicken Sie auf „Zulassen“.

Sobald die Authentifizierung abgeschlossen ist, können Sie Ihren Browser schließen.

In der Konsole von RStudio können Sie die Zusammenfassung des durchgeführten Schritts einsehen. Google Die lokal auf dem Drive befindliche Datei wurde erfolgreich hochgeladen. Google Jeder Datei auf dem Laufwerk wurde eine ID zugewiesen.

Sie können diese Datei in sehen Google Spreadsheet.
drive_browse("table_car")
Ausgang:
Sie werden weitergeleitet zu Google Spreadsheet

Importieren von Google Drive
Das Herunterladen über die Datei-ID ist der zuverlässigste Weg. Wenn Sie den Dateinamen kennen, ermitteln Sie zuerst die Datei-ID:
Hinweis: Abhängig von Ihrer Internetverbindung und der Größe Ihres Laufwerks dauert es einige Zeit.
x <-drive_get("table_car")
as_id(x)

Sie haben die ID in der Variablen x gespeichert. Die Funktion „drive_download()“ ermöglicht das Herunterladen einer Datei von Google Drive.
Die grundlegende Syntax lautet:
drive_download(file, path = NULL, overwrite = FALSE)
arguments:
- file:  Name or id of the file to download
-path: Location to download the file. By default, it is downloaded to the working directory and the name as in Google Drive
-overwrite = FALSE: If the file already exists, don't overwrite it. If set to TRUE, the old file is erased and replaced by the new one.
Endlich können Sie die Datei herunterladen:
download_google <- drive_download(as_id(x), overwrite = TRUE)
Code Erläuterung
- drive_download(): Funktion zum Herunterladen einer Datei von Google Drive
- as_id(x): Verwenden Sie die ID, um die Datei zu durchsuchen Google Drive
- overwrite = TRUE: Wenn die Datei vorhanden ist, überschreiben Sie sie, andernfalls wird die Ausführung angehalten. Um den Namen der Datei lokal anzuzeigen, können Sie Folgendes verwenden:
Ausgang:

Die Datei befindet sich in Ihrem Arbeitsverzeichnis. Denken Sie daran, die Dateiendung hinzuzufügen, bevor Sie sie in R öffnen. Sie können den vollständigen Namen mit der Funktion paste() erstellen (z. B. table_car.csv).
google_file <-download_google$local_path
google_file
path <-paste(google_file, ".csv", sep = "")
google_table_car <-read.csv(path)
google_table_car
Ausgang:
##   X gear mean_mpg mean_disp
## 1 1    3 16.10667  326.3000
## 2 2    4 24.53333  123.0167
## 3 3    5 21.38000  202.4800
Schließlich können Sie die Datei von Ihrem System entfernen. Google zu fahren.
## remove file
drive_find("table_car") %>%drive_rm()
Ausgang:

Die Löschung wird asynchron verarbeitet von GoogleDaher kann es einen Moment dauern, bis die Datei verschwindet.
Exportieren nach Dropbox
R interagiert mit Dropbox über die rdrop2-Bibliothek. Die Bibliothek ist auch bei Anaconda nicht verfügbar. Sie können es über die Konsole installieren
install.packages('rdrop2')
library(rdrop2)
Sie gewähren vorübergehenden Zugriff auf Dropbox mit Ihren Zugangsdaten. Nach der Authentifizierung kann R Dateien in Ihrem Verzeichnis erstellen, löschen, hochladen und herunterladen. Dropbox.
Zunächst müssen Sie Zugriff auf Ihr Konto gewähren. Die Anmeldeinformationen werden während der gesamten Sitzung zwischengespeichert.
drop_auth()
Sie werden weitergeleitet zu Dropbox um die Authentifizierung zu bestätigen.

Sie erhalten eine Bestätigungsseite. Sie können es schließen und zu R zurückkehren

Sie können einen Ordner mit der Funktion drop_create() erstellen.
- drop_create('my_first_drop'): Erstellen Sie einen Ordner im ersten Zweig von Dropbox
- drop_create('First_branch/my_first_drop'): Erstellen Sie einen Ordner im vorhandenen First_branch-Ordner.
drop_create('my_first_drop')
Ausgang:

Im DropBox

Um die CSV-Datei in Ihr hochzuladen Dropbox, verwenden Sie die Funktion drop_upload().
Grundlegende Syntax:
drop_upload(file, path = NULL, mode = "overwrite")
arguments:
- file: local path
- path: Path on Dropbox
- mode = "overwrite":  By default, overwrite an existing file. If set to `add`, the upload is not completed.
drop_upload('table_car.csv', path = "my_first_drop")
Ausgang:

Bei DropBox

Sie können die CSV-Datei hier lesen Dropbox mit der Funktion drop_read_csv()
dropbox_table_car <-drop_read_csv("my_first_drop/table_car.csv")
dropbox_table_car
Ausgang:
##   X gear mean_mpg mean_disp
## 1 1    3 16.10667  326.3000
## 2 2    4 24.53333  123.0167
## 3 3    5 21.38000  202.4800
Wenn Sie mit der Verwendung der Datei fertig sind und diese löschen möchten. Sie müssen den Pfad der Datei in die Funktion drop_delete() schreiben
drop_delete('my_first_drop/table_car.csv')
Ausgang:

Es ist auch möglich, einen Ordner zu löschen
drop_delete('my_first_drop')
Ausgang:

Datenexport aus R: Funktionsreferenz
Alle in diesem Tutorial verwendeten Exportfunktionen sind unten aufgeführt:
| Bibliothek | Ziel | Funktion |
|---|---|---|
| Base | CSV exportieren | write.csv() |
| XLSX | Excel exportieren | write.xlsx() |
| Port | SPSS exportieren | write_sav() |
| Port | SAS exportieren | write_sas() |
| Port | Statistiken exportieren | write_dta() |
| Base | R-Objekte exportieren | save() / saveRDS() |
| google Drive | Hochladen Google Drive | drive_upload() |
| google Drive | öffnen Sie in Google Drive | drive_browse() |
| google Drive | Datei-ID abrufen | drive_get(as_id()) |
| google Drive | Download von Google Drive | Laufwerk herunterladen() |
| google Drive | Datei entfernen aus Google Drive | drive_rm() |
| rdrop2 | Authentifizierung | drop_auth() |
| rdrop2 | Erstellen Sie einen Ordner | drop_create() |
| rdrop2 | Etwas hochladen auf Dropbox | drop_upload() |
| rdrop2 | CSV lesen von Dropbox | drop_read_csv() |
| rdrop2 | Datei löschen von Dropbox | drop_delete() |
