
ANOVA in R: Einfaktorieller und zweifaktorieller Test mit Beispielen
 Redaktion
⚡ Intelligente Zusammenfassung
Die ANOVA in R vergleicht die Mittelwerte von drei oder mehr Gruppen, indem sie die Gesamtvarianz in Varianz zwischen den Gruppen und Varianz innerhalb der Gruppen aufteilt. Diese Anleitung führt einfaktorielle und zweifaktorielle Tests am Datensatz zu Vergiftungen durch, überprüft die Voraussetzungen und identifiziert mithilfe des Tukey-HSD-Tests unterschiedliche Paare.
Was ist ANOVA?
Varianzanalyse Die Varianzanalyse (ANOVA) ist ein statistisches Verfahren zum Vergleich der Mittelwerte zweier oder mehrerer Gruppen. Der Test teilt die Gesamtvarianz einer Messung in den durch die Gruppenzugehörigkeit erklärten Anteil und den verbleibenden Anteil, der als Zufallsrauschen gilt, auf. Die ANOVA in R gibt daher Auskunft darüber, ob sich mindestens ein Gruppenmittelwert von den anderen unterscheidet, nicht von welchem. Sie ist eine direkte Erweiterung der … T-Test in Situationen, in denen die Faktorvariable mehr als zwei Ausprägungen hat.
Vor der Durchführung eines Tests ist es hilfreich zu wissen, welches Mitglied der ANOVA-Familie am besten zu Ihrem Versuchsaufbau passt.
Arten von ANOVA-Tests in R
„ANOVA“ bezeichnet eine Gruppe von Tests und nicht ein einzelnes Verfahren. Die Auswahl des richtigen Tests hängt von der Anzahl der Faktoren und der Art der Datenerhebung ab.
| Test | Wann man es benutzt | R-Anruf |
|---|---|---|
| Einweg-ANOVA | Ein Faktor mit drei oder mehr Stufen | aov(y ~ x, data = df) |
| Zweiwege-ANOVA | Zwei unabhängige Faktoren | aov(y ~ x1 + x2, data = df) |
| Zwei-Wege-Interaktion | Die Wirkung des einen Faktors hängt vom anderen ab | aov(y ~ x1 * x2, data = df) |
| Varianzanalyse mit Messwiederholung | Die gleichen Probanden wurden mehrfach gemessen | aov(y ~ x + Error(subject/x)) |
| ANCOVA | Eine kontinuierliche Kovariate muss kontrolliert werden für | aov(y ~ x + Kovariate, Daten = Freiheitsgrade) |
| MANOVA | Zwei oder mehr Antwortvariablen gleichzeitig | manova(cbind(y1, y2) ~ x) |
Dieses Tutorial behandelt die ersten drei Varianten. Die übrigen Varianten verwenden dieselbe aov()-Schnittstelle; sobald Sie also eine Ausgabetabelle lesen können, können Sie alle lesen.
ANOVA vs. T-Test in R: Wichtigste Unterschiede
Beide Tests vergleichen Mittelwerte, daher ist es wichtig, genau anzugeben, wo der eine den anderen ersetzt.
| Eigenschaften | T-Test | ANOVA |
|---|---|---|
| Anzahl der Gruppen | Genau zwei | Zwei oder mehr |
| Teststatistik | t | F ist gleich t², wenn es zwei Gruppen gibt |
| Lösung | Gibt die Richtung der Differenz an | Lediglich Berichte, die einen Unterschied feststellen |
| Nachverfolgung erforderlich | Keine Präsentation | Post-hoc-Tests wie der Tukey-HSD-Test |
| R-Funktion | t.test() | aov() |
Bei drei Gruppen besteht die Versuchung, drei separate t-Tests durchzuführen. Davon ist abzuraten. Jeder Test hat eine eigene Fehlerrate von 5 Prozent, sodass drei Vergleiche die Wahrscheinlichkeit eines falsch positiven Ergebnisses auf etwa 14 Prozent erhöhen. Die ANOVA beantwortet dieselbe Frage mit einem einzigen Test, und der Tukey-HSD-Test verarbeitet anschließend die paarweisen Vergleiche, wobei die Fehlerrate kontrolliert wird. Informationen zum Fall von zwei Gruppen finden Sie in der entsprechenden Dokumentation. t-Test-Tutorial.
Einweg-ANOVA
Es gibt viele Situationen, in denen Sie den Mittelwert zwischen mehreren Gruppen vergleichen müssen. Die Marketingabteilung möchte beispielsweise wissen, ob drei Teams die gleiche Vertriebsleistung haben.
- Team: 3-Level-Faktor: A, B und C
- Verkauf: Ein Maß für die Leistung
Mit dem ANOVA-Test lässt sich feststellen, ob die Leistungen der drei Gruppen ähnlich sind.
Um zu klären, ob die Daten aus derselben Grundgesamtheit stammen, können Sie eine durchführen einseitige Varianzanalyse (Im Folgenden: einfaktorielle Varianzanalyse). Wie jeder andere statistische Test liefert er Hinweise darauf, ob die Nullhypothese verworfen werden kann. Beachten Sie, dass die Nichtverwerfung der Nullhypothese nicht bedeutet, dass sie wahr ist.
Hypothese im einfaktoriellen ANOVA-Test
- H0: Die Mittelwerte zwischen den Gruppen sind identisch
- H1: Zumindest ist der Mittelwert einer Gruppe unterschiedlich
Mit anderen Worten: Wenn die Nullhypothese nicht verworfen wird, bedeutet dies, dass nicht genügend Beweise vorliegen, um zu dem Schluss zu kommen, dass sich ein Gruppenmittelwert von den anderen unterscheidet.
Dieser Test ähnelt dem t-Test, aber die ANOVA ist die richtige Wahl, wenn mehr als zwei Gruppen vorliegen. Bei genau zwei Gruppen sind die beiden Tests äquivalent, und die F-Statistik entspricht dem Quadrat der t-Statistik.
Annahmen
Die einfaktorielle Varianzanalyse (ANOVA) basiert auf drei Voraussetzungen: Die Beobachtungen müssen zufällig ausgewählt und voneinander unabhängig sein, die Residuen innerhalb jeder Gruppe müssen annähernd normalverteilt sein und die Varianz muss in jeder Gruppe gleich sein (Varianzhomogenität). Im Abschnitt zur Überprüfung der Voraussetzungen weiter unten wird beschrieben, wie diese in R getestet werden können.
ANOVA-Test interpretieren
Die F-Statistik wird verwendet, um zu testen, ob die Daten aus deutlich unterschiedlichen Populationen stammen, dh aus unterschiedlichen Stichprobenmittelwerten.
Um die F-Statistik zu berechnen, müssen Sie dividieren Variabilität zwischen Gruppen über die Variabilität innerhalb der Gruppe.
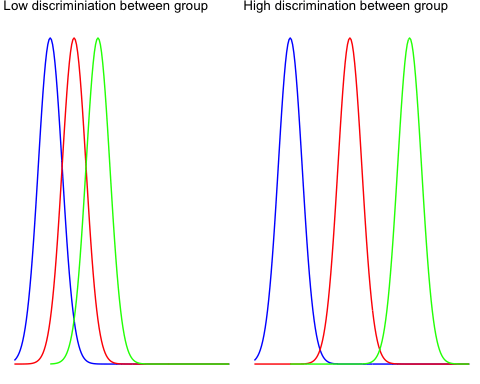
Das zwischen der Gruppe Die Variabilität spiegelt wider, wie weit der Mittelwert jeder Gruppe vom Gesamtmittelwert abweicht. Vergleichen Sie die beiden untenstehenden Grafiken, um dies zu verdeutlichen.
Die linke Grafik zeigt nur sehr geringe Unterschiede zwischen den drei Gruppen, daher liegen alle drei Gruppenmittelwerte nahe beieinander. Gesamt- bedeuten.
Die rechte Grafik zeigt drei weit voneinander entfernte Verteilungen ohne Überlappung, sodass die Differenz zwischen dem Gesamtmittelwert und dem Mittelwert jeder Gruppe groß ist.
Das innerhalb der Gruppe Die Variabilität misst, wie weit einzelne Beobachtungen vom Mittelwert ihrer jeweiligen Gruppe abweichen. Einige Punkte liegen weit außerhalb ihres Gruppenmittelwerts, und der Intra-Gruppen-Term erfasst genau diese Streuung, den Stichprobenfehler.
Um das Konzept der Variabilität innerhalb der Gruppe visuell zu verstehen, sehen Sie sich die folgende Grafik an.
Der linke Teil zeigt die Verteilung dreier verschiedener Gruppen. Sie haben die Streuung jeder Stichprobe erhöht, und es ist deutlich, dass die individuelle Varianz groß ist. Die F-Statistik sinkt, daher würden Sie die Nullhypothese nicht verwerfen.
Der rechte Teil zeigt Stichproben mit gleichen Mittelwerten, aber deutlich geringerer Streuung. Dies erhöht den F-Wert und spricht für die Alternativhypothese.

Sie können beide Maße zur Erstellung der F-Statistik verwenden. Es ist sehr intuitiv, die F-Statistik zu verstehen. Wenn der Zähler zunimmt, bedeutet dies, dass die Variabilität zwischen den Gruppen hoch ist und die Gruppen in der Stichprobe wahrscheinlich aus völlig unterschiedlichen Verteilungen stammen.
Mit anderen Worten: Ein niedriger F-Wert deutet darauf hin, dass es kaum oder gar keinen signifikanten Unterschied zwischen den Gruppenmittelwerten gibt.
Beispiel für einen einfaktoriellen ANOVA-Test
Sie verwenden den Giftdatensatz, um den einfaktoriellen ANOVA-Test durchzuführen. Der Datensatz enthält 48 Zeilen und 3 Variablen:
- Zeit: Überlebenszeit des Tieres
- Gift: Art des verwendeten Giftes: Faktorstufe: 1,2 und 3
- behandeln: Art der verwendeten Behandlung: Faktorstufe: 1,2 und 3
Bevor Sie mit der Berechnung des ANOVA-Tests beginnen, müssen Sie die Daten wie folgt vorbereiten:
- Schritt 1: Importieren Sie die Daten
- Schritt 2: Entfernen Sie unnötige Variablen
- Schritt 3: Konvertieren Sie die Variable Gift als bestellte Stufe
library(dplyr)
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/poisons.csv"
df <- read.csv(PATH) %>%
select(-X) %>%
mutate(poison = factor(poison, ordered = TRUE))
glimpse(df)
Ausgang:
## Observations: 48
## Variables: 3
## $ time   <dbl> 0.31, 0.45, 0.46, 0.43, 0.36, 0.29, 0.40, 0.23, 0.22, 0...
## $ poison <ord> 1, 1, 1, 1, 2, 2, 2, 2, 3, 3, 3, 3, 1, 1, 1, 1, 2, 2, 2...
## $ treat  <fctr> A, A, A, A, A, A, A, A, A, A, A, A, B, B, B, B, B, B, ...
Unser Ziel ist es, die folgende Annahme zu testen:
- H0: Es gibt keinen Unterschied in der durchschnittlichen Überlebenszeit zwischen den Gruppen
- H1: Die durchschnittliche Überlebenszeit ist für mindestens eine Gruppe unterschiedlich.
Mit anderen Worten, Sie möchten wissen, ob es einen statistischen Unterschied zwischen der durchschnittlichen Überlebenszeit in Abhängigkeit von der Art des dem Meerschweinchen verabreichten Giftes gibt.
Sie gehen wie folgt vor:
- Schritt 1: Überprüfen Sie das Format der Variablen Poison
- Schritt 2: Drucken Sie die zusammenfassende Statistik aus: Anzahl, Mittelwert und Standardabweichung
- Schritt 3: Erstellen Sie ein Boxplot
- Schritt 4: Berechnen Sie den einfaktoriellen ANOVA-Test
- Schritt 5: Führen Sie einen paarweisen Vergleich mit dem Tukey-HSD-Test durch.
Schritt 1) Überprüfen Sie die Giftkonzentrationen mit dem unten stehenden Code. Sie sollten drei Zeichenwerte sehen, da der Befehl `mutate` die Spalte in einen geordneten Faktor umgewandelt hat.
levels(df$poison)
Ausgang:
## [1] "1" "2" "3"
Schritt 2) Sie berechnen den Mittelwert und die Standardabweichung.
df %>%
	group_by(poison) %>%
	summarise(
		count_poison = n(),
		mean_time = mean(time, na.rm = TRUE),
		sd_time = sd(time, na.rm = TRUE)
	)
Ausgang:
##
# A tibble: 3 x 4
##   poison count_poison mean_time    sd_time
##    <ord>        <int>     <dbl>      <dbl>
## 1      1           16  0.617500 0.20942779
## 2      2           16  0.544375 0.28936641
## 3      3           16  0.276250 0.06227627
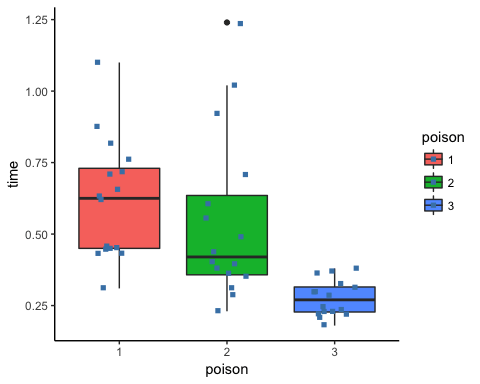
Schritt 3) Im dritten Schritt können Sie grafisch prüfen, ob es einen Unterschied zwischen der Verteilung gibt. Beachten Sie, dass Sie den gezitterten Punkt einschließen.
ggplot(df, aes(x = poison, y = time, fill = poison)) +
    geom_boxplot() +
    geom_jitter(shape = 15,
        color = "steelblue",
        position = position_jitter(0.21)) +
    theme_classic()
Ausgang:
Schritt 4) Sie können den einfaktoriellen ANOVA-Test mit dem Befehl aov ausführen. Die grundlegende Syntax für einen ANOVA-Test lautet:
aov(formula, data)
Arguments:
- formula: The equation you want to estimate
- data: The dataset used
Die Syntax der Formel lautet:
y ~ X1+ X2+...+Xn # X1 +  X2 +... refers to the independent variables
y ~ . # use all the remaining variables as independent variables
Sie können nun die Frage beantworten: Gibt es einen Unterschied in der Überlebenszeit der Meerschweinchen, abhängig von der Art des verabreichten Giftes?
Speichern Sie das Modell in einem Objekt und übergeben Sie es an summary(), um eine lesbare Ausgabe der Ergebnisse zu erhalten.
anova_one_way <- aov(time~poison, data = df)
summary(anova_one_way)
Code Erläuterung
- aov(time ~ poison, data = df): Führen Sie den ANOVA-Test mit der folgenden Formel aus
- summary(anova_one_way): Druckt die Zusammenfassung des Tests
Ausgang:
##             Df Sum Sq Mean Sq F value   Pr(>F)
## poison       2  1.033  0.5165   11.79 7.66e-05 ***
## Residuals   45  1.972  0.0438
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Der p-Wert beträgt 7.66e-05 und liegt damit weit unter dem üblichen Schwellenwert von 0.05. Die drei Sterne kennzeichnen die höchste Signifikanz. Die Nullhypothese (H0) kann verworfen werden, und es kann geschlossen werden, dass mindestens eine Giftgruppe eine abweichende mittlere Überlebenszeit aufweist.
Wie man die ANOVA-Annahmen in R überprüft
Ein ANOVA-p-Wert ist nur dann verlässlich, wenn die drei zuvor genannten Bedingungen erfüllt sind. Jede dieser Bedingungen lässt sich direkt in R überprüfen, und alle Prüfungen werden am angepassten Modellobjekt durchgeführt.
1. Unabhängigkeit der Beobachtungen. Dies ist eine Eigenschaft des Studiendesigns, nicht der Daten, daher kann kein Test Abhilfe schaffen. Jedes Meerschweinchen muss einmal gemessen und seiner Gruppe zufällig zugeordnet werden. Falls dasselbe Tier in mehreren Zeilen auftaucht, ist ein Modell mit wiederholten Messungen erforderlich.
2. Normalverteilung der Residuen. Die ANOVA setzt voraus, dass die Residuen, nicht die Rohdaten, annähernd normalverteilt sind. Untersuchen Sie das QQ-Diagramm und bestätigen Sie dies mit dem Shapiro-Wilk-Test:
par(mfrow = c(2, 2))
plot(anova_one_way)          # four diagnostic plots

shapiro.test(residuals(anova_one_way))
Punkte, die nahe an der Diagonalen des Normal-QQ-Plots liegen, deuten auf normalverteilte Residuen hin. Ein Shapiro-Wilk-p-Wert über 0.05 bedeutet, dass die Normalverteilungsannahme nicht verworfen werden kann.
3. Varianzhomogenität. Alle Gruppen sollten eine ähnliche Streuung aufweisen. Das Diagramm „Residuen vs. angepasste Werte“ sollte eher einem flachen Band als einem Trichter ähneln. Bestätigen Sie dies mit dem Levene-Test, der gegenüber Abweichungen von der Normalverteilung robuster ist als der Bartlett-Test.
library(car)
leveneTest(time ~ poison, data = df)

bartlett.test(time ~ poison, data = df)
Ein p-Wert über 0.05 spricht für gleiche Varianzen.
Was tun, wenn eine Annahme nicht zutrifft? Bei ungleichen Varianzen führen Sie `oneway.test(time ~ poison, data = df, var.equal = FALSE)` mit Welch-Korrektur durch. Sind die Residuen eindeutig nicht normalverteilt und die Stichprobe klein, wechseln Sie zum Kruskal-Wallis-Test: `kruskal.test(time ~ poison, data = df)`. Bei großen, balancierten Stichproben ist die ANOVA relativ robust gegenüber moderaten Abweichungen von der Normalverteilung, sodass ein grenzwertiges Shapiro-Wilk-Ergebnis selten schwerwiegende Folgen hat.
Paarweiser Vergleich
Ein signifikanter F-Test zeigt an, dass die Gruppenmittelwerte nicht alle gleich sind, aber nicht, welches Paar sich unterscheidet. Der Tukey-HSD-Test (Tukey Honest Significant Difference) klärt dies, indem er jedes Paar vergleicht und dabei die Fehlerwahrscheinlichkeit der Familie kontrolliert.
TukeyHSD(anova_one_way)
Ausgang:

Lesen Sie die Ausgabe zeilenweise pro Paar. diff Die Spalte enthält die Differenz zwischen den beiden Gruppenmittelwerten. ganz und upr das 95-Prozent-Konfidenzintervall für diese Differenz eingrenzen, p adj Der p-Wert wurde für Mehrfachvergleiche korrigiert. Ein Paar unterscheidet sich signifikant, wenn sein Intervall die Null nicht enthält, d. h. wenn der korrigierte p-Wert unter 0.05 liegt. In diesem Datensatz sind die Vergleiche mit Giftstoff 3 signifikant, was mit dem Boxplot übereinstimmt: Gruppe 3 weist eine deutlich geringere mittlere Überlebenszeit auf als die Gruppen 1 und 2, während sich die Gruppen 1 und 2 statistisch nicht voneinander unterscheiden.
Zweiwege-ANOVA
Eine zweifaktorielle ANOVA fügt der Formel einen zweiten Faktor hinzu. Sie funktioniert genau wie der einfaktorielle Test, nur die Formel ändert sich:
y ~ x1 + x2
Hierbei ist y die quantitative Zielvariable, während x1 und x2 beides kategoriale Faktoren sind.
Hypothese im zweiseitigen ANOVA-Test
- H0: Die Gruppenmittelwerte sind für beide Faktorvariablen gleich.
- H1: Mindestens ein Gruppenmittelwert unterscheidet sich hinsichtlich mindestens eines der beiden Faktoren.
Sie fügen die Variable „Behandlung“ zum Modell hinzu. Diese Variable erfasst die dem Meerschweinchen verabreichte Behandlung. Die untenstehende additive Formel prüft, ob jeder Faktor die Überlebenszeit allein beeinflusst, nachdem die anderen Faktoren berücksichtigt wurden.
Passen Sie den Code an, indem Sie „treat“ neben der ersten unabhängigen Variable hinzufügen.
anova_two_way <- aov(time~poison + treat, data = df)
summary(anova_two_way)
Ausgang:
##             Df Sum Sq Mean Sq F value  Pr(>F)
## poison       2 1.0330  0.5165   20.64 5.7e-07 ***
## treat        3 0.9212  0.3071   12.27 6.7e-06 ***
## Residuals   42 1.0509  0.0250
## ---
Da beide p-Werte (5.7e-07 für das Gift und 6.7e-06 für die Behandlung) weit unter 0.05 liegen, wird H0 für beide Faktoren verworfen. Daraus wird geschlossen, dass die Veränderung entweder des Giftes oder der Behandlung die Überlebenszeit beeinflusst.
Hinzufügen eines Interaktionsterms
Das obige additive Modell geht davon aus, dass die Wirkung des Giftes unabhängig von der Behandlung gleich ist. Um diese Annahme zu überprüfen, ersetzen Sie das Pluszeichen durch ein Sternchen, das sowohl die Haupteffekte als auch deren Wechselwirkung berücksichtigt:
anova_interaction <- aov(time~poison * treat, data = df)
summary(anova_interaction)
Wenn die Zeile „Gift:Behandlung“ nicht signifikant ist, ist das additive Modell die bessere Wahl, da es weniger Freiheitsgrade benötigt.
ANOVA in R: Kurzanleitung
Die folgende Tabelle listet jeden der oben verwendeten Tests, den zugehörigen R-Aufruf und die zu bewertende Hypothese auf:
| Test | Code | Hypothese | P-Wert |
|---|---|---|---|
| Einweg-ANOVA |
aov(y ~ X, data = df)
|
H1: Der Durchschnitt ist für mindestens eine Gruppe unterschiedlich | 0.05 |
| Paarweise |
TukeyHSD(ANOVA summary) |
0.05 | |
| Zweifaktorielle ANOVA |
aov(y ~ X1 + X2, data = df)
|
H1: Mindestens ein Gruppenmittelwert unterscheidet sich hinsichtlich eines der beiden Faktoren. | 0.05 |
