
Multiple lineare Regression in R: Einfache und schrittweise Regression mit Beispielen
 Evelyn Clarke
⚡ Intelligente Zusammenfassung
Einfache und multiple lineare Regression in R modellieren ein kontinuierliches Ergebnis als gewichtete Summe von Prädiktoren, die mittels der Methode der kleinsten Quadrate angepasst werden. Diese Einführung behandelt die Funktion `lm()`, das Lesen von Koeffizienten, Faktorprädiktoren, die Residuenanalyse, Vorhersagen und die automatische Variablenauswahl.
Wo die lineare Regression im maschinellen Lernen ihren Platz hat
Die lineare Regression ist eine der ältesten überwachten Methoden. Maschinelles Lernen Algorithmen, und es ist immer noch das erste Modell, zu dem die meisten Analysten greifen. Eine der frühesten Anwendungen von maschinellem Lernen war die Spam Filter.
Weitere gängige Anwendungsgebiete von maschinellem Lernen sind:
- Identifizierung unerwünschter Spam-Nachrichten in E-Mails
- Segmentierung des Kundenverhaltens für gezielte Werbung
- Reduzierung betrügerischer Kreditkartentransaktionen
- Optimierung des Energieverbrauchs in Wohnhäusern und Bürogebäuden
- Gesichtserkennung
Überwachtes Lernen
In Überwachtes Lernen, enthalten die Trainingsdaten, die Sie dem Algorithmus zuführen, eine Beschriftung.
Klassifikation ist wahrscheinlich die am häufigsten verwendete Methode des überwachten Lernens. Eine der ersten Klassifizierungsaufgaben, mit denen sich Forscher befassten, war die Spamfilterung. Ziel des Lernprozesses ist es, vorherzusagen, ob eine E-Mail als Spam oder als reguläre E-Mail (Ham) eingestuft wird. Nach dem Training kann die Maschine die E-Mail-Klasse erkennen.
Rückschritte werden häufig im Bereich des maschinellen Lernens verwendet, um kontinuierliche Werte vorherzusagen. Eine Regressionsaufgabe kann den Wert eines solchen Wertes vorhersagen. abhängige Variable basierend auf einer Reihe von unabhängige Variablen (auch Prädiktoren oder Regressoren genannt). Lineare Regressionen können beispielsweise einen Aktienkurs, eine Wettervorhersage, Umsätze usw. vorhersagen.
Einige grundlegende Algorithmen für überwachtes Lernen sind:
- Lineare Regression
- Logistische Regression
- Nächste Nachbarn
- Support-Vektor-Maschine (SVM)
- Entscheidungsbäume und Random Forest
- Neuronale Netze
Unbeaufsichtigtes Lernen
In Unbeaufsichtigtes Lernen, die Trainingsdaten sind unbeschriftet. Das System versucht, ohne Referenz zu lernen. Unten finden Sie eine Liste von Algorithmen für unüberwachtes Lernen.
- K-gemein
- Hierarchisch Cluster Analyse
- Erwartungsmaximierung
- Visualisierung und Dimensionsreduktion
- Hauptkomponentenanalyse
- Kernel-PCA
- Lokallineare Einbettung
Vor diesem Hintergrund werden im weiteren Verlauf dieses Tutorials Regressionsmodelle in R Schritt für Schritt aufgebaut.
Einfache lineare Regression in R
Die lineare Regression beantwortet eine einfache Frage: Lässt sich eine exakte Beziehung zwischen einer Zielvariablen und einer Reihe von Prädiktoren messen?
Das einfachste Wahrscheinlichkeitsmodell ist das lineare Modell:

woher
- y = Abhängige Variable
- x = Unabhängige Variable
-
 = zufällige Fehlerkomponente
-
 = abfangen
-
 = Koeffizient von x
Betrachten Sie das folgende Diagramm:
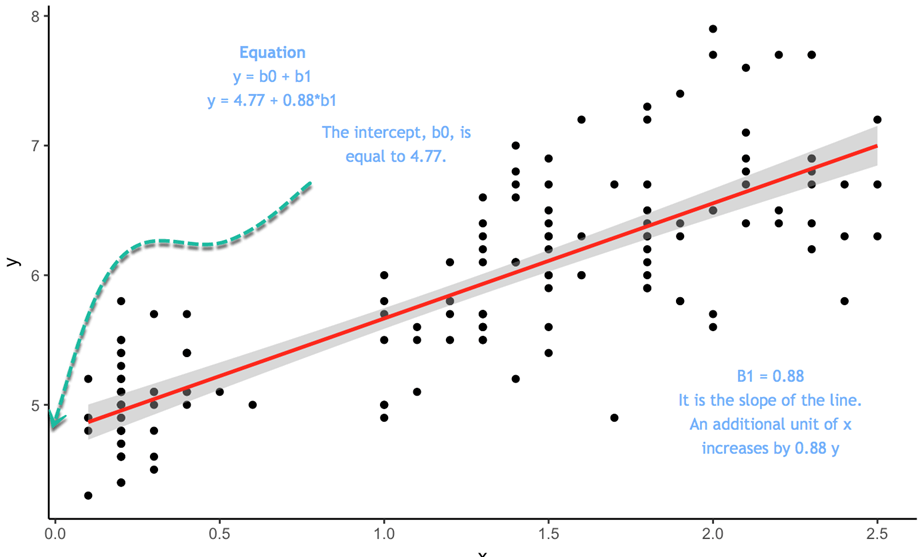
Die Gleichung ist 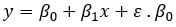 In dieser Gleichung beträgt der Achsenabschnitt 4.77. Wenn x also gleich 0 ist, beträgt der angepasste y-Wert 4.77. Die Steigung gibt an, in welchem Verhältnis sich y ändert, wenn sich x ändert.
Um die optimalen Werte von abzuschätzen  und
 , verwenden Sie eine Methode namens Gewöhnliche kleinste Quadrate (OLS). Diese Methode versucht, die Parameter zu finden, die die Summe der quadratischen Fehler minimieren, d. h. den vertikalen Abstand zwischen den vorhergesagten y-Werten und den tatsächlichen y-Werten. Der Unterschied ist als bekannt Fehlerbegriff.
Bevor Sie das Modell schätzen, können Sie durch die Erstellung eines Streudiagramms feststellen, ob eine lineare Beziehung zwischen y und x plausibel ist.
Streudiagramm
Wir werden einen sehr einfachen Datensatz verwenden, um das Konzept der einfachen linearen Regression zu erklären. Wir importieren die durchschnittlichen Größen und Gewichte amerikanischer Frauen. Der Datensatz enthält 15 Beobachtungen. Sie möchten messen, ob Höhen positiv mit Gewichten korrelieren.
library(ggplot2)
path <- 'https://raw.githubusercontent.com/guru99-edu/R-Programming/master/women.csv'
df <-read.csv(path)
ggplot(df,aes(x=height, y =  weight))+
geom_point()
Ausgang:

Das Streudiagramm deutet auf eine allgemeine Tendenz hin, dass das Gewicht mit zunehmender Körpergröße steigt. Im nächsten Schritt messen Sie, um wie viel das Gewicht pro zusätzlicher Körpergröße zunimmt.
Kleinste-Quadrate-Schätzungen
In einer einfachen OLS-Regression ist die Berechnung von  und Es ist unkompliziert. Dieses Tutorial leitet die Formeln nicht her, sondern gibt sie lediglich an.
Sie möchten abschätzen: 
Das Ziel der OLS-Regression besteht darin, die folgende Gleichung zu minimieren:

woher
 ist der tatsächliche Wert und
 ist der vorhergesagte Wert.
Die Lösung für is 
Beachten Sie, dass  bedeutet den Durchschnittswert von x
Die Lösung für  is

In R können Sie die Funktionen cov() und var() verwenden, um Schätzungen vorzunehmen. und Sie können die Funktion „mean()“ zum Schätzen verwenden 
beta <- cov(df$height, df$weight) / var (df$height)
beta
Ausgang:
##[1] 3.45
alpha <- mean(df$weight) - beta * mean(df$height)
alpha
Ausgang:
## [1] -87.51667
Der Beta-Koeffizient impliziert, dass mit jedem zusätzlichen Zoll Körpergröße das durchschnittliche Gewicht um 3.45 Pfund zunimmt.
Das Schätzen einer linearen Gleichung von Hand ist zwar lehrreich, aber unpraktisch. R Die Funktion `lm()` wird Ihnen zur Verfügung gestellt und ab dem nächsten Abschnitt verwendet. In realen Projekten werden Sie fast nie ein Modell mit nur einem Prädiktor anpassen; Regressionsaufgaben beinhalten normalerweise mehrere Schätzer gleichzeitig.
Multiple lineare Regression in R
Praktische Anwendungen der Regressionsanalyse verwenden komplexere Modelle als das einfache lineare Modell. Das probabilistische Modell, das mehr als eine unabhängige Variable enthält, wird als Regressionsmodell bezeichnet. mehrere Regressionsmodelle. Die allgemeine Form dieses Modells ist:

In Matrixnotation können Sie das Modell umschreiben:

Die abhängige Variable y ist nun eine Funktion von k unabhängigen Variablen. Der Wert des Koeffizienten  bestimmt den Beitrag der unabhängigen Variablen
 und .
Wir stellen kurz die Annahme vor, die wir über den Zufallsfehler gemacht haben  des OLS:
- Mittelwert gleich 0
- Varianz gleich

- Normalverteilung
- Zufällige Fehler sind unabhängig (im probabilistischen Sinne)

Sie müssen nach lösen , der Vektor der Regressionskoeffizienten, der die Summe der quadratischen Fehler zwischen den vorhergesagten und tatsächlichen y-Werten minimiert.
Die geschlossene Lösung lautet:

mit:
- zeigt die transponieren der Matrix X
 zeigt die invertierbare Matrix
 zeigt die invertierbare Matrix
Die folgenden Beispiele verwenden den integrierten Datensatz „mtcars“. Ziel ist es, den Kraftstoffverbrauch in Meilen pro Gallone (mpg) anhand einer Reihe von Merkmalen vorherzusagen.
Kontinuierliche Variablen in R
Vorerst verwenden Sie nur die kontinuierlichen Variablen und lassen kategorische Merkmale außer Acht. Die Variable am ist eine binäre Variable, die den Wert 1 annimmt, wenn das Getriebe manuell ist, und den Wert 0, wenn es sich um ein Auto mit Automatikgetriebe handelt; vs ist ebenfalls eine binäre Variable.
library(dplyr)
df <- mtcars %>%
select(-c(am, vs, cyl, gear, carb))
glimpse(df)
Ausgang:
## Observations: 32
## Variables: 6
## $ mpg  <dbl> 21.0, 21.0, 22.8, 21.4, 18.7, 18.1, 14.3, 24.4, 22.8, 19....
## $ disp <dbl> 160.0, 160.0, 108.0, 258.0, 360.0, 225.0, 360.0, 146.7, 1...
## $ hp   <dbl> 110, 110, 93, 110, 175, 105, 245, 62, 95, 123, 123, 180, ...
## $ drat <dbl> 3.90, 3.90, 3.85, 3.08, 3.15, 2.76, 3.21, 3.69, 3.92, 3.9...
## $ wt   <dbl> 2.620, 2.875, 2.320, 3.215, 3.440, 3.460, 3.570, 3.190, 3...
## $ qsec <dbl> 16.46, 17.02, 18.61, 19.44, 17.02, 20.22, 15.84, 20.00, 2...
Sie können die Funktion lm() verwenden, um die Parameter zu berechnen. Die grundlegende Syntax dieser Funktion lautet:
lm(formula, data, subset)
Arguments:
	-formula: The equation you want to estimate
	-data: The dataset used
	-subset: Estimate the model on a subset of the dataset
Bedenken Sie, dass eine Gleichung die folgende Form hat

in R.
- Das Symbol = wird durch ~ ersetzt
- Jedes x wird durch den Variablennamen ersetzt
- Wenn Sie die Konstante weglassen möchten, fügen Sie am Ende der Formel -1 hinzu
Ejemplo:
Sie möchten das Gewicht von Personen anhand ihrer Größe und ihres Einkommens schätzen. Die Gleichung lautet

Die Gleichung in R lautet wie folgt:
y ~ X1+ X2+…+Xn # Mit Achsenabschnitt
Also für unser Beispiel:
- Wiegen ~ Körpergröße + Umsatz
Ihr Ziel besteht darin, die Meile pro Gallone auf der Grundlage einer Reihe von Variablen zu schätzen. Die zu schätzende Gleichung lautet:

Sie schätzen Ihre erste lineare Regression und speichern das Ergebnis im Anpassungsobjekt.
model <- mpg ~ disp + hp + drat + wt + qsec
fit <- lm(model, df)
fit
Code Erläuterung
- Modell <- mpg ~ disp + hp + drat + wt + qsec: Speichere das Modell zur Schätzung
- lm(Modell, df): Schätzen Sie das Modell mit dem Datenrahmen df
##
## Call:
## lm(formula = model, data = df)
##
## Coefficients:
## (Intercept)         disp           hp         drat           wt
##    16.53357      0.00872     -0.02060      2.01577     -4.38546
##        qsec
##     0.64015
Die Ausgabe liefert nicht genügend Informationen über die Qualität der Anpassung. Weitere Details wie die Signifikanz der Koeffizienten, den Freiheitsgrad und die Form der Residuen können Sie mit der Funktion summary() abrufen.
summary(fit)
Ausgang:
## return the p-value and coefficient
##
## Call:
## lm(formula = model, data = df)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -3.5404 -1.6701 -0.4264  1.1320  5.4996
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 16.53357   10.96423   1.508  0.14362
## disp         0.00872    0.01119   0.779  0.44281
## hp          -0.02060    0.01528  -1.348  0.18936
## drat         2.01578    1.30946   1.539  0.13579
## wt          -4.38546    1.24343  -3.527  0.00158 **
## qsec         0.64015    0.45934   1.394  0.17523
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.558 on 26 degrees of freedom
## Multiple R-squared:  0.8489, Adjusted R-squared:  0.8199
## F-statistic: 29.22 on 5 and 26 DF, p-value: 6.892e-10
Schlussfolgerung aus der obigen Tabellenausgabe
- Die Tabelle zeigt einen starken negativen Zusammenhang zwischen wt und mpg sowie einen positiven Koeffizienten für drat.
- Nur die Variable wt hat einen statistischen Einfluss auf mpg. Denken Sie daran, dass wir zum Testen einer Hypothese in der Statistik Folgendes verwenden:
- H0: Kein statistischer Effekt
- H1: Der Prädiktor hat einen bedeutenden Einfluss auf y
- Wenn der p-Wert unter 0.05 liegt, bedeutet dies, dass die Variable statistisch signifikant ist
- Das korrigierte Bestimmtheitsmaß (R²) gibt den Anteil der durch das Modell erklärten Varianz von y an, bereinigt um die Anzahl der Prädiktoren. Hier beträgt es 0.8199, das Modell erklärt also etwa 82 Prozent der Varianz des Kraftstoffverbrauchs (mpg). Das R² liegt immer zwischen 0 und 1, wobei höhere Werte besser sind.
Sie können das ausführen ANOVA Testen Sie, um die Auswirkung jedes Merkmals auf die Varianzen mit der Funktion anova() abzuschätzen.
anova(fit)
Ausgang:
## Analysis of Variance Table
##
## Response: mpg
##           Df Sum Sq Mean Sq  F value   Pr(>F)
## disp       1 808.89  808.89 123.6185 2.23e-11 ***
## hp         1  33.67   33.67   5.1449 0.031854 *
## drat       1  30.15   30.15   4.6073 0.041340 *
## wt         1  70.51   70.51  10.7754 0.002933 **
## qsec       1  12.71   12.71   1.9422 0.175233
## Residuals 26 170.13    6.54
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Eine konventionellere Methode zur Schätzung der Modellleistung besteht darin, das Residuum gegenüber verschiedenen Maßen anzuzeigen.
Mit der Funktion plot() können Sie vier Diagramme anzeigen:
– Residuen vs. angepasste Werte
– Normales QQ-Diagramm: Theoretisches Quartil vs. standardisierte Residuen
– Skalenort: Angepasste Werte vs. Quadratwurzeln der standardisierten Residuen
– Residuen vs. Leverage: Leverage vs. standardisierte Residuen
Sie fügen den Code `par(mfrow = c(2, 2))` vor `plot(fit)` ein. Wenn Sie diese Codezeile nicht hinzufügen, fordert R Sie auf, die Eingabetaste zu drücken, um das nächste Diagramm anzuzeigen.
par(mfrow = c(2, 2))
Code Erläuterung
- (mfrow=c(2,2)): Gibt ein Fenster mit den vier Diagrammen nebeneinander zurück.
- Die ersten 2 addieren die Anzahl der Zeilen
- Die zweite 2 addiert die Anzahl der Spalten.
- Wenn Sie (mfrow=c(3,2)): schreiben, erstellen Sie ein Fenster mit 3 Zeilen und 2 Spalten
plot(fit)
Ausgang:

Die lm()-Funktion gibt eine Liste mit vielen nützlichen Informationen zurück. Sie können darauf zugreifen, indem Sie das von Ihnen erstellte fit-Objekt, gefolgt vom $-Zeichen und den gewünschten Informationen, verwenden.tract.
– Koeffizienten: `fit$coefficients`
– Residuen: „fit$Residuen“.
– angepasster Wert: `fit$fitted.values`
Faktorenregression in R
Bei der letzten Modellschätzung führen Sie eine Regression von mpg nur für kontinuierliche Variablen durch. Es ist einfach, Faktorvariablen zum Modell hinzuzufügen. Sie fügen Ihrem Modell die Variable am hinzu. Es ist wichtig sicherzustellen, dass es sich bei der Variablen um eine Faktorebene und nicht um eine kontinuierliche Variable handelt.
df <- mtcars %>%
    mutate(cyl = factor(cyl),
        vs = factor(vs),
        am = factor(am),
        gear = factor(gear),
        carb = factor(carb))
model <- mpg ~ .
summary(lm(model, df))
Ausgang:
##
## Call:
## lm(formula = model, data = df)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -3.5087 -1.3584 -0.0948  0.7745  4.6251
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 23.87913   20.06582   1.190   0.2525
## cyl6        -2.64870    3.04089  -0.871   0.3975
## cyl8        -0.33616    7.15954  -0.047   0.9632
## disp         0.03555    0.03190   1.114   0.2827
## hp          -0.07051    0.03943  -1.788   0.0939 .
## drat         1.18283    2.48348   0.476   0.6407
## wt          -4.52978    2.53875  -1.784   0.0946 .
## qsec         0.36784    0.93540   0.393   0.6997
## vs1          1.93085    2.87126   0.672   0.5115
## am1          1.21212    3.21355   0.377   0.7113
## gear4        1.11435    3.79952   0.293   0.7733
## gear5        2.52840    3.73636   0.677   0.5089
## carb2       -0.97935    2.31797  -0.423   0.6787
## carb3        2.99964    4.29355   0.699   0.4955
## carb4        1.09142    4.44962   0.245   0.8096
## carb6        4.47757    6.38406   0.701   0.4938
## carb8        7.25041    8.36057   0.867   0.3995
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.833 on 15 degrees of freedom
## Multiple R-squared:  0.8931, Adjusted R-squared:  0.779
## F-statistic:  7.83 on 16 and 15 DF,  p-value: 0.000124
R verwendet die erste Faktorstufe als Basisgruppe. Sie müssen die Koeffizienten der anderen Gruppe mit denen der Basisgruppe vergleichen.
Annahmen der linearen Regression in R
Die Methode der kleinsten Quadrate liefert nur dann verlässliche Koeffizienten und p-Werte, wenn fünf Bedingungen erfüllt sind. Die vier von `plot(fit)` erzeugten Diagnoseplots dienen genau dazu, diese Bedingungen zu überprüfen.
- Linearität: Die Beziehung zwischen jedem Prädiktor und y ist linear. Überprüfen Sie die Residuen vs. angepasste Werte Eine sichtbare Kurve bedeutet, dass eine Transformation oder ein Polynomterm erforderlich ist.
- Unabhängigkeit: Die Fehlerterme sind unkorreliert. Zeitlich geordnete Daten verstoßen häufig dagegen, was Sie mit durbinWatsonTest() aus dem Paket car überprüfen können.
- Homoskedastizität: Die Fehlervarianz ist über alle angepassten Werte hinweg konstant. Eine Trichterform im Maßstab-Lage Die Handlung deutet auf einen Verstoß hin.
- Normalverteilung der Residuen: Die Fehler folgen einer Normalverteilung. Die Punkte sollten auf der Diagonalen liegen. Normal QQ Grundstück.
- Keine Multikollinearität: Die Prädiktoren sind keine nahezu identischen Werte. Ein Varianzinflationsfaktor über 5 gilt üblicherweise als Warnsignal.
library(car)
vif(fit)           # variance inflation factors
shapiro.test(residuals(fit))   # normality of residuals
Verstöße führen nicht immer zur Ungültigkeit eines Modells, aber sie verändern die Sicherheit, die man bei den p-Werten haben kann. Überprüfen Sie sie daher, bevor Sie einen Koeffizienten angeben.
Wie man mit einem linearen Regressionsmodell in R Vorhersagen trifft
Das Anpassen eines Modells ist nur die halbe Miete. Die Funktion predict() wendet die angepassten Koeffizienten auf neue Beobachtungen an.
predict(object, newdata, interval = "none", level = 0.95)
arguments:
-object: The model returned by lm()
-newdata: A data frame whose columns match the predictors used in the formula
-interval: "none", "confidence" for the mean response, or "prediction" for a single new case
-level: The confidence level, 0.95 by default
Befolgen Sie diese drei Schritte.
- Erstelle einen Datenrahmen mit neuen Fällen. Die Spaltennamen müssen exakt mit den Prädiktornamen in der Formel übereinstimmen, und die Faktorstufen müssen mit den Trainingsdaten übereinstimmen.
- Rufe predict() auf. Übergeben Sie das angepasste Objekt und den neuen Datenrahmen.
- Füge ein Intervall hinzu. Wählen Sie „Konfidenz“, wenn Sie die Unsicherheit um die durchschnittliche Antwort wünschen, und „Vorhersage“, wenn Sie die Spanne für ein einzelnes Auto wünschen.
new_cars <- data.frame(wt = c(2.5, 3.2), hp = c(110, 175))
fit_final <- lm(mpg ~ wt + hp, data = mtcars)

predict(fit_final, newdata = new_cars)
predict(fit_final, newdata = new_cars, interval = "prediction")
Das Ergebnis wird gelesen. Ein Auto mit einem Gewicht von 2.5 Tonnen und 110 PS hat einen prognostizierten Verbrauch von etwa 24.1 mpg (Meilen pro Gallone). Das Prognoseintervall ist stets breiter als das Konfidenzintervall, da es zusätzlich zur Unsicherheit der Regressionsgeraden auch die Unsicherheit einer einzelnen Messung berücksichtigt.
Zwei Regeln sorgen für verlässliche Vorhersagen. Extrapolieren Sie niemals über den Bereich der Trainingsvorhersagen hinaus, da es dafür keine Grundlage gibt. Und bewerten Sie die Vorhersagen immer anhand von Daten, die das Modell noch nicht gesehen hat, da der angegebene Fehler sonst zu optimistisch ist.
Lineare Regression vs. Logistische Regression in R
Analysten greifen oft auf lm() zurück, wenn das Ergebnis nicht stetig ist. Die folgende Tabelle zeigt, wo die Grenze liegt.
| Eigenschaften | Lineare Regression | Logistische Regression |
|---|---|---|
| Antwortvariable | Kontinuierlich | Binär oder kategorisch |
| Prognostizierte Ausgabe | Jede reelle Zahl | Eine Wahrscheinlichkeit zwischen 0 und 1 |
| Schätzung | Gewöhnliche kleinste Quadrate | Maximale Wahrscheinlichkeit |
| Passformmaß | R-Quadrat, RMSE | AIC, Abweichung, Genauigkeit |
| R-Funktion | lm(Formel, Daten) | glm(formula, data, family = “binomial”) |
Wenn das Ergebnis eine Ja- oder Nein-Entscheidung ist, fahren Sie mit dem nächsten Schritt fort. verallgemeinertes lineares Modell anstatt eine gerade Linie durch Nullen und Einsen zu erzwingen.
Schrittweise lineare Regression in R
Der letzte Teil dieses Tutorials befasst sich mit dem schrittweise Regression Algorithmus. Der Zweck dieses Algorithmus besteht darin, potenzielle Kandidaten in den Modellen hinzuzufügen und zu entfernen und diejenigen beizubehalten, die einen signifikanten Einfluss auf die abhängige Variable haben. Dieser Algorithmus ist sinnvoll, wenn der Datensatz eine große Liste von Prädiktoren enthält. Sie müssen die unabhängigen Variablen nicht manuell hinzufügen und entfernen. Die schrittweise Regression wird erstellt, um die besten Kandidaten für das Modell auszuwählen.
Schauen wir uns das anhand eines Beispiels an. Sie verwenden den Datensatz „mtcars“ mit den kontinuierlichen Variablen lediglich zur Veranschaulichung. Bevor Sie mit der Analyse beginnen, empfiehlt es sich, die Zusammenhänge in den Daten mithilfe einer Korrelationsmatrix zu untersuchen. Die GGally-Bibliothek ist eine Erweiterung von ggplot2.
Die Bibliothek umfasst verschiedene Funktionen zum Anzeigen zusammenfassender Statistiken wie Korrelation und Verteilung aller Variablen in einer Matrix. Wir werden die Funktion ggscatmat verwenden, Sie können sich aber auch auf die beziehen Vignette Weitere Informationen zur GGally-Bibliothek finden Sie hier.
Die grundlegende Syntax für ggscatmat() lautet:
ggscatmat(df, columns = 1:ncol(df), corMethod = "pearson")
arguments:
-df:  A matrix of continuous variables
-columns: Pick up the columns to use in the function. By default, all columns are used
-corMethod: Define the function to compute the correlation between variable. By default, the algorithm uses the Pearson formula
Sie zeigen die Korrelationen all Ihrer Variablen an und entscheiden, welche sich am besten für den ersten Schritt der schrittweisen Regression eignen. Es bestehen einige starke Korrelationen zwischen Ihren Variablen und der abhängigen Variable „mpg“.
library(GGally)
df <- mtcars %>%
	select(-c(am, vs, cyl, gear, carb))
ggscatmat(df, columns = 1: ncol(df))
Ausgang:

Schrittweise Regression – Schritt-für-Schritt-Beispiel
Die Variablenauswahl ist ein wichtiger Bestandteil der Modellanpassung, und die schrittweise Regression führt diese Suche automatisch durch. Um abzuschätzen, wie viele mögliche Variablen im Datensatz vorhanden sind, berechnet man  wobei k die Anzahl der Prädiktoren ist. Die Anzahl der Möglichkeiten wächst mit der Anzahl unabhängiger Variablen. Deshalb ist eine automatische Suche erforderlich.
Sie müssen das olsrr-Paket von CRAN installieren. Das Paket ist in Anaconda noch nicht verfügbar. Daher installieren Sie es direkt über die Befehlszeile:
install.packages("olsrr")
Sie können alle Teilmengen der Möglichkeiten mit den Anpassungskriterien (z. B. R-Quadrat, angepasstes R-Quadrat, Bayes'sche Kriterien) grafisch darstellen. Das Modell mit den niedrigsten AIC-Kriterien ist das endgültige Modell.
library(olsrr)
model <- mpg~.
fit <- lm(model, df)
test <- ols_all_subset(fit)
plot(test)
Code Erläuterung
- mpg ~.: Konstruieren Sie das zu schätzende Modell
- lm(Modell, Freiheitsgrade): Führen Sie das OLS-Modell aus
- ols_all_subset(Anpassung): Erstellen Sie die Diagramme mit den relevanten statistischen Informationen.
- Handlung(Test): Zeichnen Sie die Diagramme
Ausgang:

Lineare Regressionsmodelle verwenden die T-Test Um den statistischen Einfluss einer unabhängigen Variable auf die abhängige Variable abzuschätzen, wird ein p-Wert verwendet. Forscher setzen den maximalen Schwellenwert üblicherweise auf 10 Prozent fest; niedrigere p-Werte deuten auf einen stärkeren statistischen Zusammenhang hin. Die schrittweise Regression basiert auf diesem Test, um potenzielle Prädiktoren hinzuzufügen und zu entfernen. Der Algorithmus funktioniert wie folgt:

- Schritt 1:: Führen Sie für jeden Prädiktor eine separate Regression auf y durch. Regressieren Sie nämlich x_1 auf y, x_2 auf y auf x_n. Speichern Sie die p-Wert und den Regressor mit einem p-Wert unter einem definierten Schwellenwert (standardmäßig 0.1) belassen. Die Prädiktoren mit einer Signifikanz unter dem Schwellenwert werden dem endgültigen Modell hinzugefügt. Wenn keine Variable einen p-Wert hat, der unter dem Eingabeschwellenwert liegt, stoppt der Algorithmus und Sie haben Ihr endgültiges Modell nur mit einer Konstante.
- Schritt 2:: Verwenden Sie den Prädiktor mit dem niedrigsten p-Wert und fügen Sie separat eine Variable hinzu. Sie führen eine Regression einer Konstante, des besten Prädiktors von Schritt eins und einer dritten Variable durch. Sie fügen dem schrittweisen Modell die neuen Prädiktoren mit einem Wert unter dem Eingangsschwellenwert hinzu. Wenn keine Variable einen p-Wert unter 0.1 hat, wird der Algorithmus angehalten und Sie haben Ihr endgültiges Modell mit nur einem Prädiktor. Sie führen eine Regression des schrittweisen Modells durch, um die Signifikanz der besten Prädiktoren von Schritt 1 zu prüfen. Wenn sie höher als der Entfernungsschwellenwert ist, behalten Sie sie im schrittweisen Modell. Andernfalls schließen Sie sie aus.
- Schritt 3:: Sie wiederholen Schritt 2 mit dem neuen besten schrittweisen Modell. Der Algorithmus fügt dem schrittweisen Modell Prädiktoren basierend auf den eingegebenen Werten hinzu und schließt Prädiktoren aus dem schrittweisen Modell aus, wenn sie den Ausschlussschwellenwert nicht erfüllen.
- Der Algorithmus läuft so lange weiter, bis keine Variable mehr hinzugefügt oder ausgeschlossen werden kann.
Sie können den Algorithmus mit der Funktion ols_stepwise() aus dem olsrr-Paket ausführen.
ols_stepwise(fit, pent = 0.1, prem = 0.3, details = FALSE)

arguments:
-fit:  Model to fit. Need to use `lm()`before to run `ols_stepwise()
-pent: Threshold of the p-value used to enter a variable into the stepwise model. By default, 0.1
-prem: Threshold of the p-value used to exclude a variable into the stepwise model. By default, 0.3
-details: Print the details of each step
⚠️ Hinweis zur Verpackung: Neuere Versionen von olsrr haben diese Funktionen umbenannt. Verwenden Sie ols_step_all_possible() anstelle von ols_all_subset() und ols_step_both_p() anstelle von ols_stepwise(). Die Argumente und die Ausgabe bleiben unverändert.
Zuvor zeigen wir Ihnen die Schritte des Algorithmus. Nachfolgend finden Sie eine Tabelle mit den abhängigen und unabhängigen Variablen:
| Abhängige Variable | Unabhängige Variablen |
|---|---|
| mpg | disp |
| hp | |
| Ratte | |
| wt | |
| qsec |
Start
Zunächst führt der Algorithmus das Modell für jede unabhängige Variable separat aus. Die Tabelle zeigt den p-Wert für jedes Modell.
## [[1]]
##  (Intercept)         disp
## 3.576586e-21 9.380327e-10
##
## [[2]]
##  (Intercept)           hp
## 6.642736e-18 1.787835e-07
##
## [[3]]
##  (Intercept)         drat
## 0.1796390847 0.0000177624
##
## [[4]]
##  (Intercept)           wt
## 8.241799e-19 1.293959e-10
##
## [[5]
## (Intercept)        qsec
##  0.61385436  0.01708199
Um in das Modell einzutreten, behält der Algorithmus die Variable mit dem niedrigsten p-Wert bei. Aus der obigen Ausgabe geht hervor, dass es wt ist
Schritt 1:
Im ersten Schritt führt der Algorithmus mpg auf wt und den anderen Variablen unabhängig aus.
## [[1]]
##  (Intercept)           wt         disp
## 4.910746e-16 7.430725e-03 6.361981e-02
##
## [[2]]
##  (Intercept)           wt           hp
## 2.565459e-20 1.119647e-06 1.451229e-03
##
## [[3]]
##  (Intercept)           wt         drat
## 2.737824e-04 1.589075e-06 3.308544e-01
##
## [[4]]
##  (Intercept)           wt         qsec
## 7.650466e-04 2.518948e-11 1.499883e-03
Jede Variable ist ein potenzieller Kandidat für das endgültige Modell. Der Algorithmus behält jedoch nur die Variable mit dem niedrigeren p-Wert bei. Es stellt sich heraus, dass hp einen etwas niedrigeren p-Wert als qsec aufweist, weshalb hp in das endgültige Modell aufgenommen wird.
Schritt 2:
Der Algorithmus wiederholt den ersten Schritt, dieses Mal jedoch mit zwei unabhängigen Variablen im endgültigen Modell.
## [[1]]
##  (Intercept)           wt           hp         disp
## 1.161936e-16 1.330991e-03 1.097103e-02 9.285070e-01
##
## [[2]]
##  (Intercept)           wt           hp         drat
## 5.133678e-05 3.642961e-04 1.178415e-03 1.987554e-01
##
## [[3]]
##  (Intercept)           wt           hp         qsec
## 2.784556e-03 3.217222e-06 2.441762e-01 2.546284e-01
Keiner der verbleibenden Kandidaten weist einen p-Wert unterhalb des Eintrittsschwellenwerts auf. Der Algorithmus stoppt hier, und dies ist das endgültige Modell:
##
## Call:
## lm(formula = mpg ~ wt + hp, data = df)
##
## Residuals:
##    Min     1Q Median     3Q    Max
## -3.941 -1.600 -0.182  1.050  5.854
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 37.22727    1.59879  23.285  < 2e-16 ***
## wt          -3.87783    0.63273  -6.129 1.12e-06 ***
## hp          -0.03177    0.00903  -3.519  0.00145 **
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.593 on 29 degrees of freedom
## Multiple R-squared:  0.8268, Adjusted R-squared:  0.8148
## F-statistic: 69.21 on 2 and 29 DF,  p-value: 9.109e-12
Sie können die Funktion ols_stepwise() verwenden, um die Ergebnisse zu vergleichen.
stp_s <-ols_stepwise(fit, details=TRUE)
Ausgang:
Der Algorithmus findet nach zwei Schritten eine Lösung und liefert die gleiche Ausgabe wie die obige manuelle Vorgehensweise.
Das endgültige Modell wird daher durch zwei Prädiktoren und einen Achsenabschnitt erklärt: Meilen pro Gallone stehen in einem negativen Zusammenhang sowohl mit der Brutto-PS-Zahl als auch mit dem Gewicht.
## You are selecting variables based on p value...
## 1 variable(s) added....
## Variable Selection Procedure
##  Dependent Variable: mpg
##
##  Stepwise Selection: Step 1
##
##  Variable wt Entered
##
##                         Model Summary
## --------------------------------------------------------------
## R                       0.868       RMSE                3.046
## R-Squared               0.753       Coef. Var          15.161
## Adj. R-Squared          0.745       MSE                 9.277
## Pred R-Squared          0.709       MAE                 2.341
## --------------------------------------------------------------
##  RMSE: Root Mean Square Error
##  MSE: Mean Square Error
##  MAE: Mean Absolute Error
##		ANOVA
## --------------------------------------------------------------------
##                 Sum of
##                Squares        DF    Mean Square      F         Sig.
## --------------------------------------------------------------------
## Regression     847.725         1        847.725    91.375    0.0000
## Residual       278.322        30          9.277
## Total         1126.047        31
## --------------------------------------------------------------------
##
##                                   Parameter Estimates
## ----------------------------------------------------------------------------------------
##       model      Beta    Std. Error    Std. Beta      t        Sig      lower     upper
## ----------------------------------------------------------------------------------------
## (Intercept)    37.285         1.878                 19.858    0.000    33.450    41.120
##          wt    -5.344         0.559       -0.868    -9.559    0.000    -6.486    -4.203
## ----------------------------------------------------------------------------------------
## 1 variable(s) added...
## Stepwise Selection: Step 2
##
##  Variable hp Entered
##
##                         Model Summary
## --------------------------------------------------------------
## R                       0.909       RMSE                2.593
## R-Squared               0.827       Coef. Var          12.909
## Adj. R-Squared          0.815       MSE                 6.726
## Pred R-Squared          0.781       MAE                 1.901
## --------------------------------------------------------------
##  RMSE: Root Mean Square Error
##  MSE: Mean Square Error
##  MAE: Mean Absolute Error
##			ANOVA
## --------------------------------------------------------------------
##                 Sum of
##                Squares        DF    Mean Square      F         Sig.
## --------------------------------------------------------------------
## Regression     930.999         2        465.500    69.211    0.0000
## Residual       195.048        29          6.726
## Total         1126.047        31
## --------------------------------------------------------------------
##
##                                   Parameter Estimates
## ----------------------------------------------------------------------------------------
##       model      Beta    Std. Error    Std. Beta      t        Sig      lower     upper
## ----------------------------------------------------------------------------------------
## (Intercept)    37.227         1.599                 23.285    0.000    33.957    40.497
##          wt    -3.878         0.633       -0.630    -6.129    0.000    -5.172    -2.584
##          hp    -0.032         0.009       -0.361    -3.519    0.001    -0.050    -0.013
## ----------------------------------------------------------------------------------------
## No more variables to be added or removed.
Lineare Regression in R: Wichtigste Erkenntnisse und Funktionsübersicht
- Die lineare Regression beantwortet eine einfache Frage: Lässt sich eine exakte Beziehung zwischen einer Zielvariablen und einer Reihe von Prädiktoren messen?
- Die Methode der kleinsten Quadrate ermittelt die Parameter, die die Summe der quadrierten Fehler minimieren, also den vertikalen Abstand zwischen den vorhergesagten y-Werten und den tatsächlichen y-Werten.
- Das probabilistische Modell, das mehr als eine unabhängige Variable umfasst, wird als multiples Regressionsmodell bezeichnet.
- Der Zweck des Algorithmus „Schrittweise lineare Regression“ besteht darin, potenzielle Kandidaten zu den Modellen hinzuzufügen und daraus zu entfernen und diejenigen beizubehalten, die einen signifikanten Einfluss auf die abhängige Variable haben.
- Die Variablenauswahl ist ein wichtiger Bestandteil der Modellanpassung, und die schrittweise Regression führt diese Suche automatisch durch.
Alle in diesem Tutorial verwendeten Funktionen sind unten aufgeführt:
| Bibliothek | Ziel | Funktion | Argumente |
|---|---|---|---|
| Base | Berechnen Sie eine lineare Regression | lm() | Formel, Daten |
| Base | Modell zusammenfassen | Zusammenfassung() | passen |
| Base | Extract-Koeffizienten | lm()$Koeffizient | |
| Base | Extract-Residuen | lm()$Residuen | |
| Base | Extract angepasster Wert | lm()$fitted.values | |
| olsrr | Führen Sie eine schrittweise Regression durch | ols_stepwise() | Passform, Pent = 0.1, Prem = 0.3, Details = FALSE |
HinweisDenken Sie daran, kategoriale Variablen vor der Modellanpassung in Faktoren umzuwandeln.
