
Node.js Streams: FileStream, Pipes & Events
 Redaktion
⚡ Intelligente Zusammenfassung
Node.js-Streams lesen und schreiben Daten in kleinen Blöcken, anstatt ganze Dateien in den Speicher zu laden. Diese Seite erklärt die Erstellung von Dateistreams, die Verkettung von Pipes, die Behandlung von Gegendruck und das Ereignismodell, das für einen effizienten Datentransfer im großen Maßstab sorgt.
Stream-Typen in Node.js
Jeder von Node.js bereitgestellte Stream lässt sich einem von vier Basistypen zuordnen. Kennt man den Rückgabetyp einer bestimmten API, ist das Verhalten des Streams bereits vor der eigentlichen Programmierung bekannt. Das mit Node.js ausgelieferte Stream-Modul definiert diese Kategorien, und die in diesem Artikel verwendeten Datei-, Netzwerk- und Komprimierungs-APIs basieren darauf.
| Stream-Typ | Datenrichtung | Beispiel-API | Häufiger Anwendungsfall |
|---|---|---|---|
| Readable | Nur Quelle (Daten fließen aus) | fs.createReadStream() | Eine Datei wird gelesen, ein HTTP-Anfragetext wird empfangen |
| Beschreibbar | Nur Ziel (Daten fließen hinein) | fs.createWriteStream() | eine Datei schreiben, eine HTTP-Antwort senden |
| Duplex | In beide Richtungen, unabhängig voneinander | net.Socket (TCP-Socket) | Zwei-Wege-Netzwerkkommunikation |
| Transformieren | In beiden Richtungen werden die Daten während der Übertragung verändert. | zlib.createGzip() | Komprimierung oder Kodierung von Daten mitten in der Pipeline |
Ein lesbarer und ein beschreibbarer Datenstrom sind die beiden Bausteine, die in diesem Artikel verwendet werden; beide treiben auch ein HTTP-Webserver in Node.js. Ein Duplex-Stream kombiniert beide Rollen in einem Objekt, während ein Transformations-Stream ein Duplex-Stream ist, dessen Ausgabe seine Eingabe verändert, wie zum Beispiel die mitten im Stream angewendete gzip-Komprimierung.
Filestream in Node.js
Nachdem die vier Stream-Kategorien definiert wurden, wird im Folgenden ein Dateitransfer unter Verwendung der lesbaren und beschreibbaren Stream-APIs beschrieben.
Der Knoten nutzt Streams in großem Umfang als Datenübertragungsmechanismus.
Wenn Sie beispielsweise mit der Funktion console.log etwas an die Konsole ausgeben, verwenden Sie tatsächlich einen Stream, um die Daten an die Konsole zu senden.
Node.js bietet außerdem die Möglichkeit, Daten aus Dateien zu streamen, sodass diese entsprechend gelesen und geschrieben werden können. Wir werden uns nun ein Beispiel ansehen, wie wir Streams zum Lesen und Schreiben von Dateien verwenden können. Für dieses Beispiel müssen wir die unten aufgeführten Schritte befolgen
Schritt 1) Erstellen Sie eine Datei mit dem Namen data.txt, die die folgenden Daten enthält. Nehmen wir an, diese Datei ist auf dem Laufwerk D unseres lokalen Computers gespeichert.
Tutorial zu Node.js
Einführung
VERANSTALTUNGEN
Datenkonnektivität
Jasmin verwenden
Schritt 2) Schreiben Sie den entsprechenden Code, der Streams zum Lesen von Daten aus der Datei verwendet.

var fs = require("fs");
var stream;
stream = fs.createReadStream("D://data.txt");

stream.on("data", function(data) {
    var chunk = data.toString();
    console.log(chunk);
});
Code Erläuterung:-
- Zuerst müssen wir die „fs“-Module einbinden, die alle zum Erstellen von Streams erforderlichen Funktionen enthalten.
- Als nächstes erstellen wir mit der Methode createReadStream einen lesbaren Stream. Als Eingabe geben wir den Speicherort unserer Datei data.txt an.
- Die Steam.on-Funktion ist ein Event-Handler und darin geben wir den ersten Parameter als „Daten“ an. Dies bedeutet, dass immer dann, wenn Daten aus der Datei in den Stream eingehen, eine Rückruffunktion ausgeführt wird. In unserem Fall definieren wir eine Callback-Funktion, die zwei grundlegende Schritte ausführt. Die erste besteht darin, die aus der Datei gelesenen Daten in eine Zeichenfolge zu konvertieren. Die zweite wäre, die konvertierte Zeichenfolge als Ausgabe an die Konsole zu senden.
- Wir nehmen jeden Datenblock, der aus dem Datenstrom gelesen wird, und wandeln ihn in einen String um.
- Schließlich senden wir die Ausgabe jedes String-konvertierten Blocks an die Konsole.
Ausgang:

- Wenn der Code ordnungsgemäß ausgeführt wird, sehen Sie die obige Ausgabe in der Konsole. Diese Ausgabe ist dieselbe wie die in der Datei data.txt.
In eine Datei schreiben
Auf die gleiche Weise, wie wir einen Lesestream erstellen, können wir auch einen Schreibstream erstellen, um Daten in eine Datei zu schreiben. Erstellen wir zunächst eine leere Datei ohne Inhalt mit dem Namen data.txt. Nehmen wir an, diese Datei befindet sich auf dem Laufwerk D unseres Computers.
Der folgende Code zeigt, wie wir Daten in die Datei schreiben können.

var fs = require("fs");
var stream;
stream = fs.createWriteStream("D://data.txt");

stream.write("Tutorial on Node.js")
stream.write("Introduction")
stream.write("Events")
stream.write("Generators")
stream.write("Data Connectivity")
stream.write("Using Jasmine")
Code Erläuterung:-
- Wir erstellen einen beschreibbaren Stream mithilfe der Methode – createWriteStream. Als Eingabe geben wir den Speicherort unserer data.txt-Datei an.
- Als nächstes haben wir die Methode stream.write verwendet, um die verschiedenen Textzeilen in unsere Textdatei zu schreiben. Der Stream kümmert sich darum, diese Daten in die Datei data.txt zu schreiben.
Wenn Sie die Datei data.txt öffnen, sehen Sie nun folgende Daten in der Datei
Tutorial zu Node.js
Einführung
VERANSTALTUNGEN
Generatoren
Datenkonnektivität
Die Verwendung von Jasmin
Pipes in Node.js
Das unabhängige Lesen und Schreiben von Datenströmen ist nützlich, aber Node.js ermöglicht es auch, einen lesbaren Datenstrom direkt mit einem beschreibbaren Datenstrom zu verbinden und so Daten ohne manuellen Pufferungscode zu übertragen.
Innerhalb von Node-Anwendungen können Streams mithilfe der Methode „pipe()“ zusammengeleitet werden, die zwei Argumente benötigt:
- Ein erforderlicher beschreibbarer Stream, der als Ziel für die Daten fungiert und
- Ein optionales Objekt, das zur Übergabe von Optionen verwendet wird.
Ein typisches Beispiel für die Verwendung von Pipes, wenn Sie Daten von einer Datei in eine andere übertragen möchten.
Sehen wir uns also ein Beispiel an, wie wir mithilfe von Pipes Daten von einer Datei in die andere übertragen können.
Schritt 1) Erstellen Sie eine Datei mit dem Namen datainput.txt, die die folgenden Daten enthält. Nehmen wir an, diese Datei ist auf dem Laufwerk D unseres lokalen Computers gespeichert.
Tutorial zu Node.js
Einführung
VERANSTALTUNGEN
Generatoren
Datenkonnektivität
Jasmin verwenden
Schritt 2) Erstellen Sie eine leere Datei mit dem Namen dataOutput.txt und legen Sie sie auf dem Laufwerk D Ihres lokalen Computers ab.
Schritt 3) Schreiben Sie den folgenden Code, um die Übertragung von Daten aus der Datei datainput.txt in die Datei dataOutput.txt durchzuführen.

var fs = require("fs");
var readStream = fs.createReadStream("D://datainput.txt");
var writeStream = fs.createWriteStream("D://dataOutput.txt");
readStream.pipe(writeStream);
Code Erläuterung:-
- Wir erstellen zunächst einen „Readstream“ zu unserer datainput.txt-Datei, der alle unsere Daten enthält, die in die neue Datei übertragen werden müssen.
- Anschließend müssen wir einen „Writestream“ für unsere Datei „dataOutput.txt“ erstellen, die unsere leere Datei ist und das Ziel für die Übertragung von Daten aus der Datei „datainput.txt“ darstellt.
- Anschließend verwenden wir den Pipe-Befehl, um die Daten vom Lesestream zum Schreibstream zu übertragen. Der Pipe-Befehl nimmt alle Daten, die in den Lesestream gelangen, und schiebt sie an den Schreibstream.
Wenn Sie nun die Datei dataOutput.txt öffnen, sehen Sie alle Daten, die in der Datei datainput.txt vorhanden waren.
Stream-Ereignisse und Gegendruck in Node.js
Der Aufruf von pipe(), wie oben gezeigt, verbirgt zwei Mechanismen, die bei großem Umfang wichtig sind: die Ereignisse, die jeder Datenstrom ausgibt, und das Gegendrucksystem, das verhindert, dass eine schnelle Quelle ein langsames Ziel überlastet.
- Daten: wird von einem lesbaren Datenstrom ausgegeben, sobald ein neuer Datenblock verfügbar ist.
- Ende: Wird ausgelöst, sobald ein lesbarer Datenstrom seinen letzten Teil geliefert hat.
- Fertig: Wird von einem beschreibbaren Datenstrom ausgegeben, sobald alle in der Warteschlange befindlichen Daten gesendet wurden.
- Fehler: Wird bei einem Fehler von einem der beiden Stream-Typen ausgelöst; muss immer behandelt werden, da es sonst zu einem Prozessabsturz kommt.
Das unten stehende Beispiel überwacht alle vier Ereignisse und steuert den Gegendruck manuell – genau das Verhalten, das pipe() automatisch bietet.
var fs = require("fs");
var readStream = fs.createReadStream("D://data.txt");
var writeStream = fs.createWriteStream("D://dataOutput.txt");

readStream.on("data", function(chunk) {
    var ok = writeStream.write(chunk);
    if (!ok) {
        readStream.pause();
    }
});

writeStream.on("drain", function() {
    readStream.resume();
});

readStream.on("end", function() {
    writeStream.end();
});

writeStream.on("finish", function() {
    console.log("Write completed.");
});

readStream.on("error", function(err) {
    console.log(err);
});
Gegendruck entsteht, wenn ein lesbarer Datenstrom schneller Daten erzeugt, als ein beschreibbarer Datenstrom sie verarbeiten kann. Die Methode `write()` gibt `false` zurück, sobald ihr Puffer voll ist. Daher pausiert der obige Code die Quelle, bis das Ziel ein Drain-Ereignis ausgibt und somit signalisiert, dass die Verarbeitung fortgesetzt werden kann. `pipe()` führt diesen Zyklus automatisch aus.
⚠ Tipp: Im Produktionsbetrieb ist die pipeline()-Funktion aus dem Stream-Modul einer manuellen pipe()-Kette vorzuziehen, da sie Fehler von jedem Stream weiterleitet und Dateihandles automatisch schließt.
Ereignisse in Node.js
Streams sind ein Beispiel für das umfassendere ereignisgesteuerte Design von Node.js. Im Folgenden wird die Funktionsweise von Ereignissen im Allgemeinen anhand der EventEmitter-Klasse erläutert, auf die auch Streams intern zurückgreifen.
Ereignisse sind eines der Schlüsselkonzepte in Node.js und manchmal wird Node.js als ereignisgesteuertes Framework bezeichnet.
Im Grunde ist ein Ereignis etwas, das passiert. Wenn beispielsweise eine Verbindung zu einer Datenbank hergestellt wird, wird das Datenbankverbindungsereignis ausgelöst. Bei der ereignisgesteuerten Programmierung geht es darum, Funktionen zu erstellen, die ausgelöst werden, wenn bestimmte Ereignisse ausgelöst werden.
Schauen wir uns ein einfaches Beispiel für die Definition eines Ereignisses in Node.js an.
Wir werden ein Ereignis namens „data_received“ erstellen. Wenn dieses Ereignis ausgelöst wird, wird der Text „Daten empfangen“ an die Konsole gesendet.

var events = require('events');
var eventEmitter = new events.EventEmitter();
eventEmitter.on('data_received', function() {
    console.log('data received succesfully.');
});

eventEmitter.emit('data_received');
Code Erläuterung:-
- Verwenden Sie die Funktion „require“, um das Modul „events“ einzubinden. Mit diesem Modul können Sie Ereignisse in Node.js erstellen.
- Erstellen Sie einen neuen Ereignisemitter. Dies wird verwendet, um das Ereignis, das in unserem Fall „data_received“ ist, an eine Rückruffunktion zu binden, die in Schritt 3 definiert wird.
- Wir definieren eine ereignisgesteuerte Funktion, die besagt, dass wir, falls das Ereignis „data_received“ ausgelöst wird, den Text „data_received“ an die Konsole ausgeben sollen.
- Schließlich haben wir einen manuellen Auslöser unseres Ereignisses mithilfe der Funktion eventEmiter.emit. Dadurch wird das data_received-Ereignis ausgelöst.
Wenn das Programm ausgeführt wird, wird der Text „Daten empfangen“ wie unten gezeigt an die Konsole gesendet.

Ereignisse ausgeben
Neben dem Auslösen und Empfangen von Ereignissen bietet Node.js zusätzliche Methoden zur Steuerung der Registrierung und Überprüfung von Listenern.
Bei der Definition von Ereignissen gibt es verschiedene Methoden für Ereignisse, die aufgerufen werden können. In diesem Thema geht es darum, jeden einzelnen davon im Detail zu betrachten.
- Einmalige Event-Handler
Manchmal möchten Sie möglicherweise nur auf ein Ereignis reagieren, wenn es zum ersten Mal auftritt. In diesen Situationen können Sie die Methode Once() verwenden.
Sehen wir uns an, wie wir die Once-Methode für Event-Handler nutzen können.

Code Erläuterung:-
- Hier verwenden wir die Methode „once“, um zu sagen, dass die Callback-Funktion für das Ereignis „data_received“ nur einmal ausgeführt werden soll.
- Hier lösen wir manuell das Ereignis „data_received“ aus.
- Wenn das Ereignis „data_received“ erneut ausgelöst wird, passiert dieses Mal nichts. Dies liegt daran, dass wir im ersten Schritt gesagt haben, dass das Ereignis nur einmal ausgelöst werden kann.
Wenn der Code ordnungsgemäß ausgeführt wird, lautet die Ausgabe im Protokoll „data_received erfolgreich“. Diese Meldung wird nur einmal in der Konsole angezeigt.
- Überprüfen von Ereignis-Listenern
Zu jedem Zeitpunkt seiner Lebensdauer können einem Ereignisemitter null oder mehr Listener zugeordnet sein. Die Listener für jeden Ereignistyp können auf verschiedene Arten überprüft werden.
Wenn Sie nur die Anzahl der angeschlossenen Listener ermitteln möchten, ist die Methode EventEmitter.listenerCount() genau das Richtige für Sie.
(Hinweis: Zuhörer sind wichtig, da das Hauptprogramm wissen sollte, ob Zuhörer spontan zu einem Ereignis hinzugefügt werden. Andernfalls kommt es zu Fehlfunktionen des Programms, da zusätzliche Zuhörer aufgerufen werden.)

Code Erläuterung:-
- Wir definieren einen eventEmitter-Typ, der für die Verwendung der ereignisbezogenen Methoden erforderlich ist.
- Anschließend definieren wir ein Objekt namens Emitter, das zur Definition unserer Event-Handler verwendet wird.
- Wir erstellen zwei Event-Handler, die im Grunde nichts tun. In unserem Beispiel ist dies einfach gehalten, nur um zu zeigen, wie die Methode listenerCount funktioniert.
- Wenn Sie nun die Methode listenerCount für unser data_received-Ereignis aufrufen, wird die Anzahl der an dieses Ereignis angehängten Ereignis-Listener im Konsolenprotokoll gesendet.
Wenn der Code ordnungsgemäß ausgeführt wird, wird im Konsolenprotokoll der Wert 2 angezeigt.
- Das newListener-Ereignis
Jedes Mal, wenn ein neuer Ereignishandler registriert wird, gibt der Ereignisemitter ein newListener-Ereignis aus. Dieses Ereignis wird verwendet, um neue Ereignishandler zu erkennen. Normalerweise verwenden Sie das Ereignis newListener, wenn Sie Ressourcen zuweisen oder eine Aktion für jeden neuen Ereignishandler ausführen müssen.
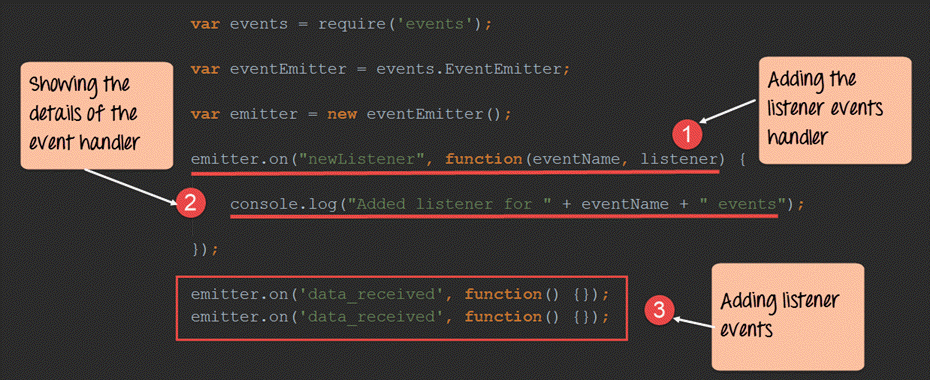
var events = require('events');
var eventEmitter = events.EventEmitter;
var emitter = new eventEmitter();
emitter.on("newListener", function(eventName, listener) {
    console.log("Added listener for " + eventName + " events");
});
emitter.on('data_received', function() {});
emitter.on('data_received', function() {});
Code Erläuterung:-
- Wir erstellen einen neuen Eventhandler für das „newListener“-Ereignis. Immer wenn ein neuer Eventhandler registriert wird, wird in der Konsole der Text „Listener für hinzugefügt“ + der Ereignisname angezeigt.
- Hier schreiben wir in die Konsole den Text „Hinzugefügter Listener für“ + den Ereignisnamen für jedes registrierte Ereignis.
- Wir definieren zwei Event-Handler für unser Event „data_received“.
Wenn der obige Code ordnungsgemäß ausgeführt wird, wird der folgende Text in der Konsole angezeigt. Es zeigt lediglich, dass der Ereignishandler „newListener“ zweimal ausgelöst wurde.
Listener für data_received-Ereignisse hinzugefügt
Listener für data_received-Ereignisse hinzugefügt
