
Apache Oozie Tutorial: Workflow-Diagramm, Zeitplaner
 Prafulla Ranadive
⚡ Intelligente Zusammenfassung
Apache Oozie ist der Workflow-Scheduler für Hadoop, der abhängige Jobs als gerichtete azyklische Graphen ausführt und eine Workflow-Engine für MapReduce-, Pig- und Hive-Aktionen mit einer Koordinierungs-Engine kombiniert, die von Zeit und Datenverfügbarkeit gesteuert wird.
Was ist Apache Oozie?
Apache Oozie ist ein Workflow-Scheduler für HadoopEs handelt sich um ein System, das den Workflow abhängiger Jobs steuert. Hier können Benutzer gerichtete azyklische Graphen von Workflows erstellen, die in Hadoop parallel und sequenziell ausgeführt werden können.
Es besteht aus zwei Teilen:
- Workflow-Engine: Die Aufgabe einer Workflow-Engine besteht darin, Workflows zu speichern und auszuführen, die aus Hadoop-Jobs bestehen, z. B. MapReduce, Schwein, Hive.
- Koordinator-Engine: Es führt Workflow-Jobs basierend auf vordefinierten Zeitplänen und der Verfügbarkeit von Daten aus.
Oozie ist skalierbar und kann die zeitgerechte Ausführung Tausender Workflows (jeweils bestehend aus Dutzenden von Jobs) in einem Hadoop-Cluster verwalten. Das folgende Diagramm zeigt die Position des Schedulers im Verhältnis zum Cluster und den von ihm gesteuerten Jobs.

Oozie ist zudem sehr flexibel. Jobs lassen sich problemlos starten, stoppen, pausieren und erneut ausführen. Mit Oozie ist es besonders einfach, fehlgeschlagene Workflows erneut auszuführen. Man versteht sofort, wie schwierig es sein kann, verpasste oder fehlgeschlagene Jobs aufgrund von Ausfallzeiten oder Störungen nachzuholen. Es ist sogar möglich, einen bestimmten fehlgeschlagenen Knoten zu überspringen.
Projektstatus: Apache Oozie wurde von der Apache Software Company eingestellt. Foundation im Februar 2025 und der Umzug zu Apache-Dachboden Die Entwicklung wurde im April 2025 abgeschlossen. Die finale Version ist weiterhin 5.2.1 vom Februar 2021, und das Quellcode-Repository ist nun schreibgeschützt. Bestehende Cluster nutzen es weiterhin, weshalb die folgenden Funktionsweisen relevant sind. Neue Pipelines basieren jedoch üblicherweise auf Apache Airflow.
Wie funktioniert Oozie?
Oozie läuft als Dienst im Cluster, und Clients übermitteln Workflow-Definitionen zur sofortigen oder späteren Verarbeitung.
Ein Oozie-Workflow besteht aus Aktionsknoten und Kontrollflussknoten.
Ein Aktionsknoten repräsentiert eine Workflow-Aufgabe, z. B. das Verschieben von Dateien nach HDFS, einen MapReduce-, Pig- oder Hive-Job ausführen, Daten importieren mit Sqoopoder das Ausführen eines Shell-Skripts oder eines in geschriebenen Programms Java.
Ein Kontrollflussknoten steuert die Workflow-Ausführung zwischen Aktionen, indem er Konstrukte wie bedingte Logik ermöglicht, bei denen je nach Ergebnis eines vorherigen Aktionsknotens unterschiedliche Zweige verfolgt werden können.
Startknoten, Endknoten und Fehlerknoten fallen unter diese Kategorie von Knoten.
- Knoten starten bezeichnet den Start des Workflow-Jobs.
- Endknoten signalisiert das Ende des Auftrags.
- Fehlerknoten Kennzeichnet das Auftreten eines Fehlers und die entsprechende Fehlermeldung, die ausgegeben werden soll.
Am Ende der Workflow-Ausführung verwendet Oozie einen HTTP-Callback, um den Client über den Workflow-Status zu informieren. Auch das Betreten oder Verlassen eines Aktionsknotens kann diesen Callback auslösen.
Oozie-Steuerungsknoten und Aktionstypen
Neben Start, Ende und Fehler unterstützt das Workflow-XML eine kleine Anzahl von Kontrollknoten, die den Graphen formen.
- Entscheidung: Wertet einen Ausdruck aus und leitet den Workflow in einen von mehreren Zweigen weiter, das Äquivalent einer Switch-Anweisung.
- Gabel: Teilt den Pfad auf, sodass zwei oder mehr Aktionen parallel ausgeführt werden.
- beitreten: Wartet, bis jeder Zweig einer passenden Gabel fertig ist, bevor fortgefahren wird.
- töten: Beendet den Workflow sofort und protokolliert die Fehlermeldung.
Aktionsknoten decken die eigentliche Arbeit ab und jeder hat sein eigenes XML-Element:
- MapReduce, Pig, Hive und Sqoop Die Aktionen starten den entsprechenden Hadoop-Job.
- Java führt eine Hauptklasse auf dem Cluster aus; Schale und ssh Skripte ausführen.
- fs führt HDFS-Haushaltsarbeiten durchping wie beispielsweise move, delete, mkdir und chmod.
- E-Mail benachrichtigt die Empfänger und Teilworkflow ruft eine weitere Workflow-Anwendung auf.
Beispiel-Workflow-Diagramm
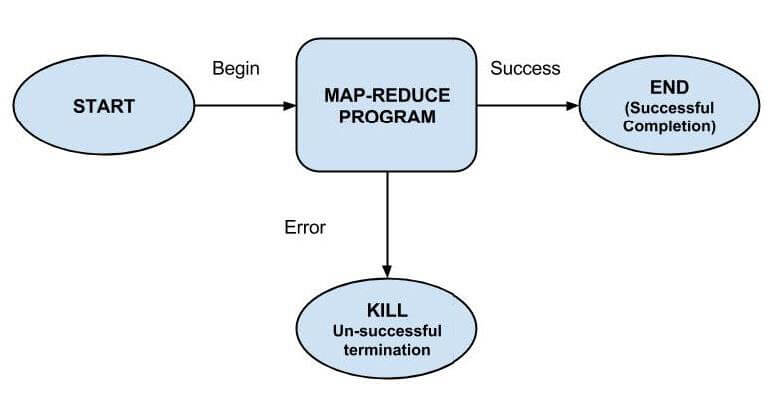
Das untenstehende Diagramm traces ist ein kleiner Workflow vom Startknoten über eine MapReduce-Aktion bis entweder zum Endknoten oder zum Fehlerpfad, wenn die Aktion fehlschlägt.
Arten von Oozie-Jobs
Oozie beschreibt Arbeit auf drei Ebenen. Jede Ebene umschließt die darunterliegende, sodass ein Bündel letztendlich viele einzelne Arbeitsabläufe steuert.
| Anstellungsart | Was es definiert | Ausgelöst durch |
|---|---|---|
| Arbeitsablauf | Ein gerichteter azyklischer Graph von Aktions- und Kontrollknoten, geschrieben in workflow.xml | Manuelle Einreichung oder ein Koordinator |
| -Koordinator | Ein wiederkehrender Zeitplan für einen Arbeitsablauf mit Startzeit, Endzeit und Häufigkeit | Verfügbarkeit von Uhrzeit und Eingangsdaten |
| Kombi-Ticket | Eine Sammlung von Koordinierungsanwendungen, die als eine einzige Datenpipeline verwaltet werden. | Ein für alle Koordinatoren geltender Anstoßzeitpunkt |
In der Praxis ist diese Unterscheidung wichtig: Ein Workflow beantwortet die Frage „Was wird ausgeführt?“, ein Koordinator die Frage „Wann wird es ausgeführt?“ und ein Bundle die Frage „Was beginnt und endet gleichzeitig?“.
Verpackung und Bereitstellung einer Oozie-Workflow-Anwendung
Eine Workflow-Anwendung besteht aus der Workflow-Definition und allen zugehörigen Ressourcen wie MapReduce-JAR-Dateien, Pig-Skripten usw. Anwendungen müssen einer einfachen Verzeichnisstruktur folgen und werden auf HDFS bereitgestellt, damit Oozie darauf zugreifen kann.
Nachfolgend ist eine beispielhafte Verzeichnisstruktur dargestellt:
<name of workflow>/
├── lib/
│   └── hadoop-examples.jar
└── workflow.xml
Die Datei workflow.xml (eine Workflow-Definitionsdatei) muss im Hauptverzeichnis (dem übergeordneten Verzeichnis mit dem Workflow-Namen) abgelegt werden. Das Verzeichnis lib enthält JAR-Dateien mit MapReduce-Klassen. Eine Workflow-Anwendung, die diesem Aufbau entspricht, kann mit jedem Build-Tool, z. B. Ant oder Maven, erstellt werden.
Ein solcher Build muss mithilfe eines Befehls nach HDFS kopiert werden, zum Beispiel:
% hadoop fs -put hadoop-examples/target/<name of workflow dir> name of workflow
Schritte zum Ausführen eines Oozie-Workflow-Auftrags
In diesem Abschnitt erfahren Sie, wie Sie einen Workflow-Job ausführen. Um dies auszuführen, verwenden wir das Oozie-Befehlszeilentool (ein Client-Programm, das mit dem Oozie-Server kommuniziert).
1. Exportiere die OOZIE_URL Umgebungsvariable, die dem Oozie-Befehl mitteilt, welchen Oozie-Server er verwenden soll (hier verwenden wir einen lokal laufenden):
% export OOZIE_URL="http://localhost:11000/oozie"
2. Führen Sie den Workflow-Job wie folgt aus:
% oozie job -config ch05/src/main/resources/max-temp-workflow.properties -run
Die Option -config bezieht sich auf eine lokale Java Properties-Datei mit Definitionen für die Parameter in der Workflow-XML-Datei sowie oozie.wf.application.path, die Oozie den Speicherort der Workflow-Anwendung in HDFS mitteilt.
Beispielinhalt der Eigenschaftendatei:
nameNode=hdfs://localhost:8020
jobTracker=localhost:8021
oozie.wf.application.path=${nameNode}/user/${user.name}/<name of workflow>
3. Den Status des Workflow-Auftrags abrufen.
Der Status eines Workflow-Jobs kann mit dem Unterbefehl 'job' und der Option '-info' angezeigt werden, wobei nach '-info' die Job-ID angegeben wird.
e.g., % oozie job -info <job id>
Die Ausgabe zeigt einen Status an, der entweder LÄUFT, BEENDET oder ERFOLGREICH ist.
4. Die Ergebnisse einer erfolgreichen Workflow-Ausführung können mit einem Hadoop-Befehl wie dem folgenden angezeigt werden:
% hadoop fs -cat <location of result>
Warum Oozie verwenden?
Der Hauptzweck von Oozie besteht darin, verschiedene Arten von Jobs zu verwalten, die in einem Hadoop-System verarbeitet werden.
Abhängigkeiten zwischen Jobs werden vom Benutzer in Form von gerichteten azyklischen Graphen (DAGs) definiert. Oozie verarbeitet diese Informationen und sorgt für die korrekte Ausführung der Jobs in der im Workflow festgelegten Reihenfolge. Dadurch spart der Benutzer Zeit bei der Workflow-Verwaltung. Zusätzlich bietet Oozie die Möglichkeit, die Ausführungshäufigkeit einzelner Jobs festzulegen.
Merkmale von Oozie
- Oozie verfügt über eine Client-API und eine Kommandozeilenschnittstelle, mit denen Jobs gestartet, gesteuert und überwacht werden können. Java Anwendung.
- Mithilfe der Web Service APIs lassen sich Aufträge von überall aus steuern.
- Oozie bietet die Möglichkeit, Jobs auszuführen, die regelmäßig laufen sollen.
- Oozie bietet die Möglichkeit, nach Abschluss von Aufträgen E-Mail-Benachrichtigungen zu versenden.
Oozie vs Apache Airflow
Da Oozie nicht mehr weiterentwickelt wird, vergleichen die meisten Teams, die heute einen Scheduler evaluieren, ihre bestehende Lösung mit Apache Airflow. Die beiden Tools lösen dasselbe Problem aus unterschiedlichen Perspektiven.
| Aspekt | Apache Oozie | Apache-Luftstrom |
|---|---|---|
| Definitionssprache | Workflows, geschrieben als XML | DAGs geschrieben als Python Code |
| Geltungsbereich | Basierend auf Hadoop-Aktionen wie MapReduce, Pig, Hive und Sqoop | Universell einsetzbar, mit Operatoren für Cloud-Dienste, Datenbanken und Container |
| Planung | Koordinatorentätigkeiten werden von Zeit und Datenverfügbarkeit bestimmt | Zeitintervalle planen plus Sensoren, die auf äußere Bedingungen warten |
| Projekt-Status | Im Jahr 2025 in den Apache Attic verlegt; endgültige Version 5.2.1 | Aktiv weiterentwickeltes Apache-Top-Level-Projekt |
Oozie bleibt die einfachere Option auf einem Cluster, auf dem es bereits läuft, da die Aktionen eins zu eins Hadoop-Komponenten zugeordnet werden können. Airflow ist die praktische Wahl für alles Neue, insbesondere wenn eine Pipeline über Hadoop hinausgeht.
