
Hadoop Pig-Tutorial: Was ist Apache Pig? Architektur, Beispiel
 Prafulla Ranadive
⚡ Intelligente Zusammenfassung
Apache Pig ist eine High-Level-Plattform zur Analyse großer Datensätze auf Hadoop, die die Datenflusssprache Pig Latin mit einer Laufzeitumgebung kombiniert, die jedes Skript in MapReduce, Tez oder .NET kompiliert. Spark Jobs werden automatisch erledigt.
Dieses Tutorial beginnt mit der Idee hinter Apache Pig und führt dann Schritt für Schritt durch die Installation und die Ausführung eines kompletten Pig Latin-Skripts von Anfang bis Ende.
Was ist Apache Pig?
Das Schwein ist ein hochrangiges Tier Programmiersprache Nützlich für die Analyse großer Datensätze. Pig entstand aus der Entwicklungsarbeit bei Yahoo!
Im MapReduce-Framework müssen Programme in eine Reihe von Map- und Reduce-Schritten übersetzt werden. Dieses Programmiermodell ist Datenanalysten jedoch nicht vertraut. Um diese Lücke zu schließen, wird daher ein abstraktes Modell entwickelt.tracDie sogenannte Schweine-Idee wurde darauf errichtet Hadoop.
Apache Pig ermöglicht es Nutzern, sich stärker auf die Analyse großer Datenmengen zu konzentrieren und weniger Zeit mit dem Schreiben von MapReduce-Programmen zu verbringen. Ähnlich wie Schweine, die alles fressen, ist die Programmiersprache Apache Pig für die Verarbeitung beliebiger Datentypen konzipiert. Daher auch der Name „Pig“ (Schwein)! Das unten abgebildete Projektmaskottchen unterstreicht dies.

Das Projekt ist noch aktiv. Apache Pig 0.18.0 wurde am 15. September 2025 veröffentlicht und bietet Unterstützung für Hadoop 3, Tez 0.10 und Hive 3. Spark 3, HBase 2 und Python 3, laut der Apache Pig-Releases-SeiteDie unten stehende Anleitung wurde ursprünglich für die deutlich ältere Version 0.12.1 geschrieben, daher enthalten einige Schritte einen Hinweis, wo sich eine aktuelle Version anders verhält.
Schwein Architektur
Die Architektur von Pig besteht aus zwei Komponenten:
- Schweinelatein, Das ist eine Sprache
- Eine Laufzeitumgebung, zum Ausführen von Pig Latin-Programmen.
Ein Pig-Latin-Programm besteht aus einer Reihe von Operationen oder Transformationen, die auf die Eingabedaten angewendet werden, um Ausgaben zu erzeugen. Diese Operationen beschreiben einen Datenfluss, der von der Hadoop-Pig-Ausführungsumgebung in eine ausführbare Darstellung übersetzt wird. Im Kern sind die Ergebnisse dieser Transformationen eine Reihe von MapReduce Aufgaben, von denen ein Programmierer nichts weiß. In gewisser Weise ermöglicht Pig in Hadoop dem Programmierer also, sich auf die Daten anstatt auf die Art der Ausführung zu konzentrieren.
Pig Latin ist eine vergleichsweise starre Sprache, die bekannte Schlüsselwörter aus der Datenverarbeitung verwendet, z. B. Join, Group und Filter. Das folgende Diagramm veranschaulicht dies. traces ein Skript von der Grunt-Shell über den Parser, Optimierer und Compiler auf seinem Weg zur Ausführungs-Engine.

Ausführungsmodi
Pig in Hadoop verfügt über zwei Ausführungsmodi, und die weiter unten stehende Installationsanleitung verwendet beide:
- Lokalbetrieb: In diesem Modus läuft die Hadoop Pig-Sprache in einem einzigen JVM und nutzt das lokale Dateisystem. Dieser Modus eignet sich nur für die Analyse kleiner Datensätze mit Pig in Hadoop.
- MapReduce-Modus: In diesem Modus werden in Pig Latin geschriebene Abfragen in MapReduce-Jobs übersetzt und auf einem Hadoop-Cluster ausgeführt (der Cluster kann pseudo- oder vollständig verteilt sein). Der MapReduce-Modus mit einem vollständig verteilten Cluster eignet sich besonders für die Ausführung von Pig auf großen Datensätzen.
Diese beiden bilden das klassische Paar. Aktuelle Versionen bieten tatsächlich sechs Ausführungstypen, oder Exectypes, die jeweils mit demselben Parameter ausgewählt werden. -x Flagge, wie in der Pig 0.18.0 – Leitfaden für Einsteiger.
| Führungstyp | Befehl | Wo die Arbeit stattfindet |
|---|---|---|
| Local | pig -x local | Eine einzelne JVM gegen das lokale Dateisystem |
| Tez lokal | pig -x tez_local | Eine einzelne JVM, die die Tez-Laufzeitumgebung verwendet (experimentell) |
| Spark aus einer regionalen | pig -x spark_local | Eine einzelne JVM, die die Spark Laufzeit (experimentell) |
| MapReduce | pig oder pig -x mapreduce | Ein Hadoop-Cluster mit HDFS; dies ist die Standardeinstellung. |
| Tez | pig -x tez | Ein Hadoop-Cluster, auf dem die Tez-Engine läuft |
| Spark | Schwein -x Funke | A Spark, YARN- oder Mesos-Cluster mit HDFS |
Pig Latin-Datentypen und Operatoren
Bevor man ein Skript schreibt, ist es hilfreich zu wissen, welche Daten Pig verarbeiten kann. Das Datenmodell ist vollständig verschachtelt, wodurch Pig auch Logdateien und andere lose strukturierte Eingaben lesen kann, die eine relationale Tabelle ablehnen würde.
Pig Latin bietet zwei Typenfamilien an:
- Skalartypen:
int,long,float,double,chararray,bytearray,boolean,datetime,bigintegerundbigdecimalDas Beispielskript deklariert später jede Spalte alschararray. - Komplexe Typen: a Tupel ist eine geordnete Menge von Feldern und verhält sich wie eine Zeile; ein beutel ist eine ungeordnete Sammlung von Tupeln und verhält sich wie eine Tabelle; eine Karte ist eine Menge von Schlüssel-Wert-Paaren, deren Schlüssel ein
chararray.
Die Betreiber lassen sich in wenige Berufe unterteilen, und eine Handvoll von ihnen betreut nahezu alle Pipelines:
| OperaDo. | Was sie tut, |
|---|---|
| LADEN / SPEICHERN | Eine Relation aus dem Dateisystem lesen und das Ergebnis zurückschreiben |
| FILTER | Behalte nur die Tupel, die einer Bedingung entsprechen. |
| FÜR JEDES … GENERIEREN | Arbeiten Sie Spalte für Spalte und erstellen Sie neue Felder. |
| GRUPPE / COGROUP | Gruppieren Sie eine Relation oder zwei oder mehr Relationen anhand eines Schlüssels |
| JOIN | Beziehungen mit einem inneren oder äußeren Join verbinden |
| VEREINIGUNG / TRENNUNG | Beziehungen zusammenführen oder eine in mehrere aufteilen |
| BESTELLEN NACH / UNTERSCHEIDEN / LIMIT | Sortieren, Deduplizieren und die Anzahl der Tupel begrenzen |
| DOLLAR / BESCHREIBEN / ERKLÄREN / ILLUSTRATEN | Ergebnisse, Schemas, Ausführungspläne und Beispielläufe prüfen |
Die vier Inspektionsbediener verfügen außerdem über Grunt-Shortcuts, was Zeit spart.ping während des Debuggens: \d für Müllkippe \de für BESCHREIBEN, \e für ERKLÄREN und \i für ILLUSTRATE.
Voraussetzungen:
Pig ist ein clientseitiges Tool. Es analysiert ein Skript, plant die Arbeitsabläufe und übermittelt Jobs, stellt aber keinen eigenen Speicher oder Cluster bereit. Daher muss zunächst eine funktionierende Hadoop-Installation vorhanden sein. Die Apache-Anforderungsliste ist kurz.
| Komponente | Anforderung | Warum es benötigt wird |
|---|---|---|
| Hadoop | Hadoop 2.x oder 3.x, mit exportiertem HADOOP_HOME | Stellt HDFS und die Ausführungs-Engine bereit. Ohne HADOOP_HOME greift Pig 0.18.0 auf ein eingebettetes Hadoop 2.7.3 zurück. |
| Java | Java Version 1.7 oder höher, wobei JAVA_HOME auf das Installationsverzeichnis gesetzt ist. | Pig und die Hadoop-Daemons sind Java Programme |
| Python (optional) | Python 2.7 | Nur für Streaming erforderlich Python benutzerdefinierte Funktionen |
| Ameise (optional) | Ameise 1.8 | Wird nur benötigt, wenn Pig aus dem Quellcode erstellt oder neu kompiliert wird. |
Zwei praktische Hinweise ergänzen diese Liste. Erstens: Führen Sie alle Programme, die bereits ein Home-Verzeichnis besitzen, als Linux-Benutzer aus. HDFS und die Erlaubnis, darauf zu schreiben; dieses Tutorial verwendet hduserDas Konto, das während der Hadoop-Einrichtung erstellt wurde. Zweitens: Starten Sie den Cluster, bevor Sie Pig im MapReduce-Modus starten, da Pig sofort fehlschlägt, wenn NameNode und ResourceManager nicht verfügbar sind. Falls Hadoop noch nicht installiert ist, gehen Sie wie folgt vor: Wie installiert man Hadoop? zuerst.
So laden Sie Pig herunter und installieren es
In diesem Apache Pig-Tutorial erfahren wir nun, wie man Pig herunterlädt und installiert:
Bevor wir mit dem eigentlichen Prozess beginnen, stellen Sie sicher, dass Hadoop installiert ist. Ändern Sie den Benutzer in 'hduser' (die ID, die bei der Konfiguration von Hadoop verwendet wurde; Sie können die Benutzer-ID verwenden, die Sie bei Ihrer eigenen Hadoop-Konfiguration verwendet haben).

Schritt 1) Laden Sie die neueste stabile Version von Pig Hadoop von einem der verfügbaren Mirror-Server herunter unter
https://pig.apache.org/releases.html
Wählen Sie die Datei tar.gz (und nicht src.tar.gz) zum Herunterladen aus, wie unten gezeigt.

Schritt 2) Sobald der Download abgeschlossen ist, navigieren Sie zu dem Verzeichnis, das die heruntergeladene TAR-Datei enthält, und verschieben Sie diese an den gewünschten Ort, um Pig Hadoop zu installieren. In diesem Fall verschieben wir sie nach /usr/local.

Wechseln Sie in das Verzeichnis, das die Pig Hadoop-Dateien enthalten soll.
cd /usr/local
Extracden Inhalt der tar-Datei wie folgt.
sudo tar -xvf pig-0.12.1.tar.gz

Schritt 3) Ändern Sie ~/.bashrc, um Pig-bezogene Umgebungsvariablen hinzuzufügen.
Öffnen Sie die Datei ~/.bashrc in einem beliebigen Texteditor Ihrer Wahl und nehmen Sie die folgenden Änderungen vor.
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

Schritt 4) Laden Sie nun diese Umgebungskonfiguration mit dem folgenden Befehl.
. ~/.bashrc

Schritt 5) Wir müssen Pig neu kompilieren, um Hadoop 2.2.0 zu unterstützen.
Hier sind die einzelnen Schritte dazu.
Gehe zum Pig-Hauptverzeichnis.
cd $PIG_HOME
Installieren Sie Ant.
sudo apt-get install ant

Hinweis: Der Download startet und die Dauer hängt von Ihrer Internetgeschwindigkeit ab.
Pig neu kompilieren.
sudo ant clean jar-all -Dhadoopversion=23

Bitte beachten Sie, dass bei diesem Neukompilierungsprozess mehrere Komponenten heruntergeladen werden. Das System muss daher mit dem Internet verbunden sein.
Sollte dieser Prozess irgendwo hängen bleiben und Sie nach mehr als 20 Minuten keine Reaktion in der Eingabeaufforderung feststellen, drücken Sie Strg + C und führen Sie denselben Befehl erneut aus.
In unserem Fall dauert es 20 Minuten.

Dieser Neukompilierungsschritt stammt aus der Ära 0.12.1, als die ausgelieferten JAR-Dateien für Hadoop 1 erstellt wurden. -Dhadoopversion=23 Durch die Option wurde der Ant-Build auf Hadoop 0.23 und 2.x umgestellt. Apache Pig 0.18.0 enthält Binärdateien, die bereits unter Hadoop 2.7 und höher sowie unter Hadoop 3 laufen. Daher können Sie bei einer aktuellen Version das Tar-Archiv normalerweise entpacken und direkt mit dem folgenden Test fortfahren.
Schritt 6) Testen Sie die Pig-Installation mit dem Befehl
pig -help

Beispiel für ein Pig-Skript
Nach der Installation von Pig wird im weiteren Verlauf dieses Apache Pig-Tutorials ein vollständiges Skript ausgeführt. Wir verwenden Pig Scripts, um die Anzahl der in jedem Land verkauften Produkte zu ermitteln.
Eingabe: Unser Eingabedatensatz ist eine CSV-Datei. SalesJan2009.csv.
Schritt 1) Hadoop starten.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Schritt 2) Pig in Big Data liest eine Datei aus HDFS im MapReduce-Modus und speichert die Ergebnisse zurück in HDFS.
Kopieren Sie die Datei SalesJan2009.csv (gespeichert im lokalen Dateisystem unter ~/input/SalesJan2009.csv) in das HDFS (Hadoop Distributed File System) Home-Verzeichnis.
In diesem Apache Pig-Beispiel befindet sich die Datei im Ordner „input“. Falls die Datei an einem anderen Ort gespeichert ist, geben Sie stattdessen diesen Namen an.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

Überprüfen Sie, ob die Datei tatsächlich kopiert wurde oder nicht.
$HADOOP_HOME/bin/hdfs dfs -ls /

Schritt 3) Pig-Konfiguration.
Navigieren Sie zunächst zu $PIG_HOME/conf und erstellen Sie eine Kopie der ursprünglichen Eigenschaftendatei.
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

Öffnen Sie pig.properties mit einem Texteditor Ihrer Wahl und geben Sie den Pfad zur Protokolldatei mit pig.logfile an.
sudo gedit pig.properties

Der Logger wird diese Datei verwenden, um Fehler zu protokollieren.
Schritt 4) Führen Sie den Befehl 'pig' aus. Dadurch wird die Pig-Befehlszeile gestartet, eine interaktive Shell für Pig-Abfragen.
pig

Schritt 5) Führen Sie in der Grunt-Befehlszeile für Pig die folgenden Pig-Befehle der Reihe nach aus.
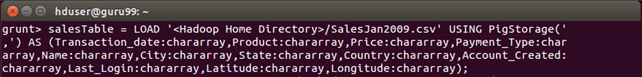
— A. Laden Sie die Datei mit den Daten.
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
Drücken Sie nach diesem Befehl die Eingabetaste.
— B. Gruppierung der Daten nach dem Feld Land.
GroupByCountry = GROUP salesTable BY Country;

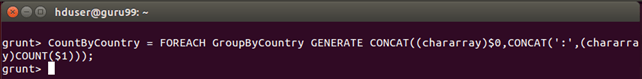
— C. Generieren Sie für jedes Tupel in 'GroupByCountry' die resultierende Zeichenkette der Form Name des Landes: Anzahl der verkauften Produkte.
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
Drücken Sie nach diesem Befehl die Eingabetaste.
— D. Speichern Sie die Ergebnisse des Datenflusses im Verzeichnis 'pig_output_sales' auf HDFS.
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

Die Ausführung dieses Befehls wird einige Zeit dauern. Anschließend sollte der folgende Bildschirm angezeigt werden.

Schritt 6) Das Ergebnis kann über die Befehlsschnittstelle eingesehen werden als
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

Die Ergebnisse können auch über eine Weboberfläche eingesehen werden.
Öffnen Sie http://localhost:50070/ in einem Webbrowser.
Port 50070 ist die NameNode-Weboberfläche in Hadoop 2. Hadoop 3 hat dieselbe Seite auf Port 9870 verschoben; verwenden Sie daher diese Adresse, wenn Ihr Cluster Hadoop 3 ausführt.

Wählen Sie nun „Dateisystem durchsuchen“ und navigieren Sie zu /user/hduser/pig_output_sales.

Öffnen Sie Teil-r-00000, um die vom Skript erzeugten Länder- und Produktanzahlpaare zu lesen.

Apache Pig vs. Hive vs. MapReduce
Pig wird selten für sich allein bewertet. Die übliche Frage ist, ob eine Aufgabe zu Pig gehört, zu Hive oder in einem handgeschriebenen MapReduce-Programm, da alle drei letztendlich als Jobs auf demselben Cluster ausgeführt werden.
| Aspekt | MapReduce (Java) | Apache-Schwein | Apache Hive |
|---|---|---|---|
| Interface | Java API | Pig Latin, eine Datenfluss-Skriptsprache | HiveQL, ein SQL-Dialekt |
| Niveau der BauchmuskelntracProduktion | Niedrig | Medium | Hoch |
| Typischer Benutzer | Java Entwickler | Dateningenieur oder Forscher | Analyst mit SQL-Kenntnissen |
| Daten, zu denen es passt | Alles, was manuell erledigt wird | Strukturiert und semistrukturiert; das Schema ist beim Laden optional. | Strukturierte Tabellen, die in einem Metastore registriert sind |
| Code Volumen | Die meisten Zeilen | Weniger Zeilen | Die wenigsten Zeilen für eine Abfrage |
| Läuft als | Ein MapReduce-Job | Kompiliert zu MapReduce, Tez oder Spark Jobs & Karriere | Kompiliert zu MapReduce, Tez oder Spark Jobs & Karriere |
| am besten bei | Volle Kontrolle und benutzerdefinierte Logik | Mehrstufige ETL-Pipelines | Ad-hoc-Abfragen und Berichte |
In der Praxis ist die Unterscheidung unkompliziert. Greifen Sie zu Hive, wenn die Daten bereits tabellarisch strukturiert sind und die Fragestellung einer SQL-Abfrage ähnelt. Greifen Sie zu Pig, wenn die Eingabedaten unstrukturiert sind, die Pipeline aus einer Kette von Transformationen anstatt einer einzelnen Abfrage besteht oder dasselbe Skript verzweigt und wieder zusammengeführt werden muss. Verwenden Sie MapReduce nur dann, wenn weder Hive noch Pig die richtige Wahl sind.traction kann die Logik ausdrücken, da die Zeilenanzahl schnell ansteigt.
Auch das Schwein fügt sich harmonisch in das übrige Ökosystem ein. Sqoop und Flume Die Rohdaten werden gelandet, von Pig oder Hive aufbereitet und ein Scheduler wie z. B. Apache Oozie Die einzelnen Schritte werden zu einer wiederholbaren Pipeline verknüpft. Einen umfassenderen Überblick darüber, wo diese Tools ihren Platz finden, erhalten Sie im Leitfaden zu große Datenmengen und die Zusammenfassung von Big-Data-ToolsEine kommerzielle ETL-Alternative zu handgeschriebenen Skripten finden Sie unter Talend.
