
Hadoop MapReduce Beispiel: Erste Java Programm mit Code
 Prafulla Ranadive
⚡ Intelligente Zusammenfassung
Hadoop MapReduce-Programme werden als drei geschrieben Java Klassen, ein Mapper, ein Reducer und ein Treiber werden kompiliert, in ein JAR-Archiv verpackt und an den Cluster übermittelt, um die Verkäufe pro Land zu zählen.
In diesem Tutorial erfahren Sie, wie Sie Hadoop mit MapReduce-Beispielen verwenden. Die verwendeten Eingabedaten sind SalesJan2009.csvSie enthält verkaufsbezogene Informationen wie Produktname, Preis, Zahlungsart, Stadt und Land des Kunden. Ziel ist es, die Anzahl der in jedem Land verkauften Produkte zu ermitteln.
Erstes Hadoop MapReduce-Programm
Jetzt hier MapReduce-Tutorial, erstellen wir unser erstes Java MapReduce-Programm:
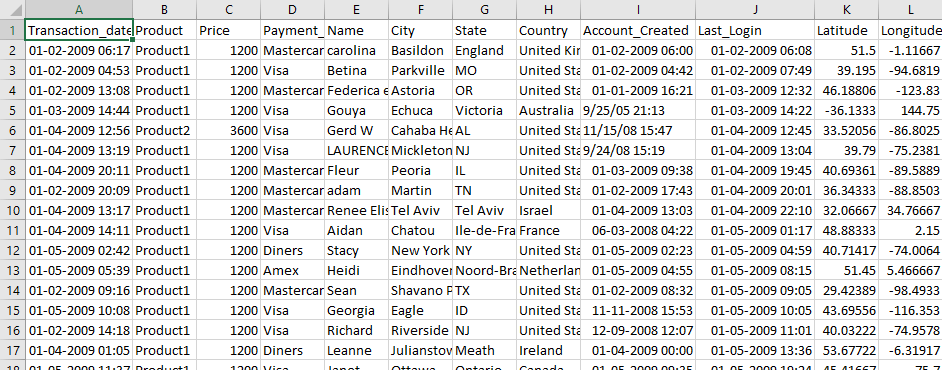
Der untenstehende Screenshot zeigt die Rohdaten von SalesJan2009, wobei jede Zeile eine Transaktion darstellt und das Land in der achten, durch Kommas getrennten Spalte angegeben ist.
Stellen Sie sicher, dass Hadoop installiert ist. Bevor Sie mit dem eigentlichen Prozess beginnen, ändern Sie den Benutzer in 'hduser' (die ID, die bei der Konfiguration von Hadoop verwendet wurde – Sie können zur Benutzer-ID wechseln, die Sie während Ihrer eigenen Hadoop-Konfiguration verwendet haben).
su - hduser_
Die Eingabeaufforderung ändert sich zum hduser-Konto, wie unten dargestellt.

Schritt 1) Projektverzeichnis und Quelldateien erstellen
Erstellen Sie ein neues Verzeichnis mit dem Namen MapReduceTutorial, wie im folgenden MapReduce-Beispiel gezeigt.
sudo mkdir MapReduceTutorial

Berechtigungen erteilen
sudo chmod -R 777 MapReduceTutorial

Erstelle die drei Java Die Quelldateien befinden sich im Ordner „MapReduceTutorial“. Beachten Sie, dass alle drei die ältere Version verwenden. org.apache.hadoop.mapred API, die immer noch mit Hadoop 3.x ausgeliefert wird.
SalesMapper.java
package SalesCountry;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesMapper extends MapReduceBase implements Mapper <LongWritable, Text, Text, IntWritable> {
	private final static IntWritable one = new IntWritable(1);

	public void map(LongWritable key, Text value, OutputCollector <Text, IntWritable> output, Reporter reporter) throws IOException {

		String valueString = value.toString();
		String[] SingleCountryData = valueString.split(",");
		output.collect(new Text(SingleCountryData[7]), one);
	}
}
SalesCountryReducer.java
package SalesCountry;

import java.io.IOException;
import java.util.*;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {

	public void reduce(Text t_key, Iterator<IntWritable> values, OutputCollector<Text,IntWritable> output, Reporter reporter) throws IOException {
		Text key = t_key;
		int frequencyForCountry = 0;
		while (values.hasNext()) {
			// replace type of value with the actual type of our value
			IntWritable value = (IntWritable) values.next();
			frequencyForCountry += value.get();

		}
		output.collect(key, new IntWritable(frequencyForCountry));
	}
}
SalesCountryDriver.java
package SalesCountry;

import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.*;
import org.apache.hadoop.mapred.*;

public class SalesCountryDriver {
    public static void main(String[] args) {
        JobClient my_client = new JobClient();
        // Create a configuration object for the job
        JobConf job_conf = new JobConf(SalesCountryDriver.class);

        // Set a name of the Job
        job_conf.setJobName("SalePerCountry");

        // Specify data type of output key and value
        job_conf.setOutputKeyClass(Text.class);
        job_conf.setOutputValueClass(IntWritable.class);

        // Specify names of Mapper and Reducer Class
        job_conf.setMapperClass(SalesCountry.SalesMapper.class);
        job_conf.setReducerClass(SalesCountry.SalesCountryReducer.class);

        // Specify formats of the data type of Input and output
        job_conf.setInputFormat(TextInputFormat.class);
        job_conf.setOutputFormat(TextOutputFormat.class);

        // Set input and output directories using command line arguments,
        //arg[0] = name of input directory on HDFS, and arg[1] =  name of output directory to be created to store the output file.

        FileInputFormat.setInputPaths(job_conf, new Path(args[0]));
        FileOutputFormat.setOutputPath(job_conf, new Path(args[1]));

        my_client.setConf(job_conf);
        try {
            // Run the job
            JobClient.runJob(job_conf);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
Laden Sie die Dateien hier herunter
Das Archiv entfaltet sich in dieselben drei Quelldateien, wie hier gezeigt.
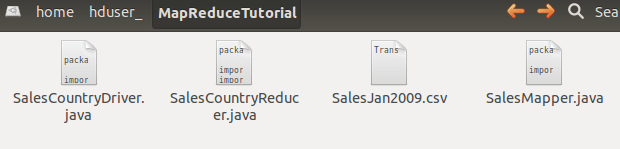
Überprüfen Sie die Dateiberechtigungen aller dieser Dateien

Falls die Leseberechtigung fehlt, erteilen Sie sie:

Schritt 2) Exportieren Sie den Hadoop-Classpath
Exportieren Sie den Klassenpfad wie im folgenden Hadoop-Beispiel gezeigt.
export CLASSPATH="$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-core-2.2.0.jar:$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-common-2.2.0.jar:$HADOOP_HOME/share/hadoop/common/hadoop-common-2.2.0.jar:~/MapReduceTutorial/SalesCountry/*:$HADOOP_HOME/lib/*"
Der exportierte Klassenpfad wird an der Eingabeaufforderung wieder angezeigt.

Schritt 3) Kompilieren Sie die Java Dateien
Kompilieren Sie die Java Die Dateien (diese Dateien befinden sich im Verzeichnis Final-MapReduceHandsOn) und ihre Klassendateien werden im Paketverzeichnis abgelegt.
javac -d . SalesMapper.java SalesCountryReducer.java SalesCountryDriver.java
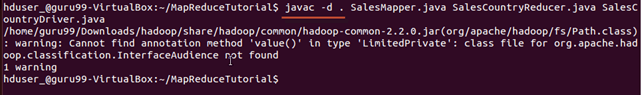
Diese Warnung kann getrost ignoriert werden – sie besagt lediglich, dass die mapred-API veraltet ist.
Diese Kompilierung erstellt im aktuellen Verzeichnis ein Verzeichnis mit dem Namen des im Paket angegebenen Pakets. Java Die Quelldatei (in unserem Fall SalesCountry) enthält alle kompilierten Klassendateien.

Schritt 4) Erstellen Sie die Manifestdatei
Erstelle eine neue Datei namens Manifest.txt
sudo gedit Manifest.txt
Fügen Sie folgende Zeile hinzu:
Main-Class: SalesCountry.SalesCountryDriver

SalesCountry.SalesCountryDriver ist der Name der Hauptklasse. Bitte beachten Sie, dass Sie am Ende dieser Zeile die Eingabetaste drücken müssen.
Schritt 5) Packen Sie die Klassen in ein JAR-Archiv.
Erstellen Sie eine Jar-Datei
jar cfm ProductSalePerCountry.jar Manifest.txt SalesCountry/*.class

Überprüfen Sie, ob die JAR-Datei erstellt wurde

Schritt 6) Hadoop starten
Starten Sie Hadoop
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Schritt 7) Kopieren Sie die Eingabedatei in HDFS.
Kopieren Sie die Datei SalesJan2009.csv nach ~/inputMapReduce
Verwenden Sie nun den folgenden Befehl, um ~/inputMapReduce nach HDFS zu kopieren.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/inputMapReduce /
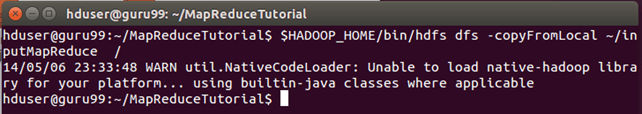
Wir können diese Warnung getrost ignorieren.
Überprüfen Sie, ob eine Datei tatsächlich kopiert wird oder nicht.
$HADOOP_HOME/bin/hdfs dfs -ls /inputMapReduce

Schritt 8) Führen Sie den MapReduce-Job aus.
Führen Sie den MapReduce-Job aus
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales

Dadurch wird ein Ausgabeverzeichnis mit dem Namen „mapreduce_output_sales“ erstellt HDFS. Der Inhalt dieses Verzeichnisses ist eine Datei mit den Produktverkäufen pro Land.
Schritt 9) Lesen Sie die Ergebnisse.
Das Ergebnis kann über die Befehlsschnittstelle wie folgt angezeigt werden:
$HADOOP_HOME/bin/hdfs dfs -cat /mapreduce_output_sales/part-00000
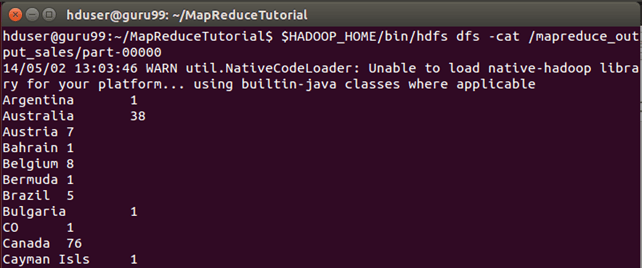
Die Ergebnisse können auch über eine Weboberfläche eingesehen werden.
Öffne http://localhost:50070/ in einem Webbrowser. Bei Hadoop 3.x wurde die NameNode-Weboberfläche auf Port verschoben. 9870, also benutze http://localhost:9870/ dort statt.

Wählen Sie nun „Dateisystem durchsuchen“ und navigieren Sie zu /mapreduce_output_sales

Öffnen Sie Teil-r-00000

Erläuterung der SalesMapper-Klasse
Nachdem der gesamte Prozess von Anfang bis Ende durchlaufen wurde, werden in den nächsten drei Abschnitten die einzelnen Klassen detailliert beschrieben.
In diesem Abschnitt werden wir die Implementierung der SalesMapper-Klasse verstehen.
1. Zunächst legen wir einen Paketnamen für unsere Klasse fest. Dieser lautet „SalesCountry“. Bitte beachten Sie, dass die Ausgabedatei der Kompilierung, „SalesMapper.class“, in einem Verzeichnis mit dem Namen dieses Pakets gespeichert wird: „SalesCountry“.
Anschließend importieren wir Bibliothekspakete.
Der folgende Screenshot zeigt eine Implementierung der SalesMapper-Klasse.

Musteranfrage Code Erläuterung:
1. SalesMapper-Klassendefinition –
public class SalesMapper extends MapReduceBase implements Mapper<LongWritable, Text, Text, IntWritable> {
Jede Mapper-Klasse muss von der MapReduceBase-Klasse abgeleitet werden und das Mapper-Interface implementieren.
2. Definieren der „Karten“-Funktion –
public void map(LongWritable key,
         Text value,
OutputCollector<Text, IntWritable> output,
Reporter reporter) throws IOException
Der Hauptteil der Mapper-Klasse ist eine 'map()'-Methode, die vier Argumente akzeptiert.
Bei jedem Aufruf der Methode 'map()' wird ein Schlüssel-Wert-Paar übergeben (in diesem Code 'key' und 'value').
Die Methode 'map()' beginnt damit, den als Argument übergebenen Eingabetext aufzuteilen. Sie zerlegt jede Zeile in Felder.
String valueString = value.toString();
String[] SingleCountryData = valueString.split(",");
Hier wird ',' als Trennzeichen verwendet.
Anschließend wird ein Paar aus dem Datensatz am 7. Index des Arrays 'SingleCountryData' und dem Wert '1' gebildet.
output.collect(new Text(SingleCountryData[7]), one);
Wir wählen den Datensatz an Index 7 aus, weil wir Länderdaten benötigen und diese sich an Index 7 im Array 'SingleCountryData' befinden.
Bitte beachten Sie, dass unsere Eingabedaten im folgenden Format vorliegen (wobei das Land an siebter Stelle des Index steht und 0 der Startindex ist):
Transaction_date,Product,Price,Payment_Type,Name,City,State,Country,Account_Created,Last_Login,Latitude,Longitude
Die Ausgabe des Mappers ist wiederum ein Schlüssel-Wert-Paar, das mit der Methode 'collect()' des 'OutputCollector' erzeugt wird.
Erläuterung der SalesCountryReducer-Klasse
In diesem Abschnitt werden wir die Implementierung der SalesCountryReducer-Klasse verstehen.
1. Zunächst legen wir einen Paketnamen für unsere Klasse fest. Unser Paket heißt „SalesCountry“. Bitte beachten Sie, dass die Ausgabedatei der Kompilierung, „SalesCountryReducer.class“, in einem Verzeichnis mit dem Namen dieses Pakets gespeichert wird: „SalesCountry“.
Anschließend importieren wir Bibliothekspakete.
Der folgende Screenshot zeigt eine Implementierung der SalesCountryReducer-Klasse.
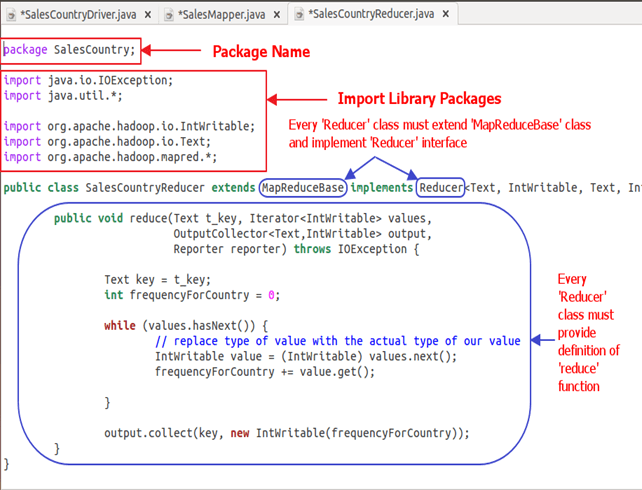
Code Erläuterung:
1. SalesCountryReducer-Klassendefinition-
public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {
Hierbei handelt es sich bei den ersten beiden Datentypen, 'Text' und 'IntWritable', um die Datentypen der Eingabe-Schlüssel-Wert-Paare für den Reducer.
Die Ausgabe des Mappers hat folgendes Format: , Die Ausgabe des Mappers dient als Eingabe für den Reducer. Um den Datentypen gerecht zu werden, werden hier Text und IntWritable verwendet.
Die letzten beiden Datentypen, 'Text' und 'IntWritable', sind die Datentypen der Ausgabe, die vom Reducer in Form eines Schlüssel-Wert-Paares erzeugt wird.
Jede Reducer-Klasse muss von der MapReduceBase-Klasse abgeleitet werden und das Reducer-Interface implementieren.
2. Definieren der Funktion „Reduzieren“-
public void reduce( Text t_key,
             Iterator<IntWritable> values,
             OutputCollector<Text,IntWritable> output,
             Reporter reporter) throws IOException {
Die Eingabe für die reduce()-Methode ist ein Schlüssel mit einer Liste von mehreren Werten.
In unserem Fall wird es zum Beispiel so sein:
, , , , , .
Dies wird dem Reduzierstück übergeben als
Um Argumente dieser Form zu akzeptieren, werden zunächst zwei Datentypen verwendet, nämlich Text und Iterator. Text ist ein Datentyp von Schlüssel und Iterator ist ein Datentyp für eine Liste von Werten für diesen Schlüssel.
Das nächste Argument ist vom Typ OutputCollector. welches den Ausgang der Reduzierstufe auffängt.
Die reduce()-Methode beginnt damit, dass der Schlüsselwert kopiert und der Häufigkeitszähler auf 0 initialisiert wird.
Text key = t_key;int frequencyForCountry = 0;
Anschließend iterieren wir mithilfe einer 'while'-Schleife durch die Liste der Werte, die dem Schlüssel zugeordnet sind, und berechnen die endgültige Häufigkeit, indem wir alle Werte aufsummieren.
 while (values.hasNext()) {
            // replace type of value with the actual type of our value
            IntWritable value = (IntWritable) values.next();
            frequencyForCountry += value.get();

        }
Nun leiten wir das Ergebnis in Form eines Schlüssels und der ermittelten Häufigkeitszählung an den Ausgabekollektor weiter.
Der folgende Code bewirkt Folgendes:
output.collect(key, new IntWritable(frequencyForCountry));
Erläuterung der SalesCountryDriver-Klasse
In diesem Abschnitt werden wir die Implementierung der SalesCountryDriver-Klasse verstehen.
1. Zunächst legen wir einen Paketnamen für unsere Klasse fest. Unser Paket heißt „SalesCountry“. Bitte beachten Sie, dass die Ausgabedatei der Kompilierung, „SalesCountryDriver.class“, in einem Verzeichnis mit dem Namen dieses Pakets gespeichert wird: „SalesCountry“.
Hier ist eine Zeile, die den Paketnamen angibt, gefolgt von Code zum Importieren von Bibliothekspaketen.

2. Definieren Sie eine Treiberklasse, die einen neuen Client-Job und ein neues Konfigurationsobjekt erstellt und Mapper- und Reducer-Klassen ankündigt.
Die Treiberklasse ist dafür verantwortlich, dass unser MapReduce-Job ausgeführt wird HadoopIn dieser Klasse legen wir den Jobnamen, den Datentyp der Ein-/Ausgabe sowie die Namen der Mapper- und Reducer-Klassen fest.

3. Im folgenden Codeausschnitt legen wir Eingabe- und Ausgabeverzeichnisse fest, die zum Konsumieren des Eingabedatensatzes bzw. zum Erzeugen der Ausgabe verwendet werden.
arg[0] und arg[1] sind die Befehlszeilenargumente, die mit einem Befehl in MapReduce hands-on übergeben werden, d.h.
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales
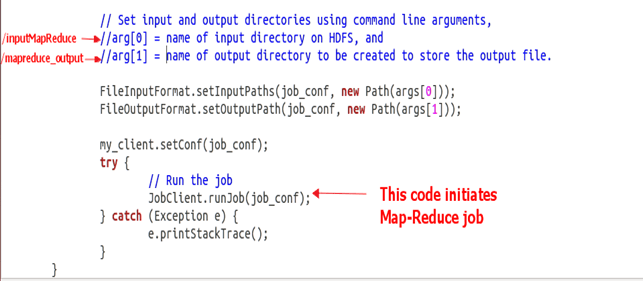
4. Lösen Sie unseren Job aus
Der folgende Code startet die Ausführung des MapReduce-Jobs:
try {
    // Run the job
    JobClient.runJob(job_conf);
} catch (Exception e) {
    e.printStackTrace();
}
