
Was ist Hadoop? ArchiArchitektur, Ökosystem & Komponenten
 Prafulla Ranadive
⚡ Intelligente Zusammenfassung
Apache Hadoop ist ein Open-Source-Framework, das riesige Datensätze auf Clustern von Standardmaschinen speichert und die Verarbeitungslogik zu den Daten verlagert, sodass die Analyse durch Hinzufügen günstiger Knoten anstatt größerer Server skaliert wird.
Was ist Hadoop?
Apache Hadoop ist ein Open-Source-Software-Framework zur Entwicklung von Datenverarbeitungsanwendungen, die in einer verteilten Computerumgebung ausgeführt werden.
Anwendungen, die mit Hadoop entwickelt wurden, laufen auf großen Datensätzen, die auf Clustern von Standardrechnern verteilt sind. Standardrechner sind kostengünstig und weit verbreitet. Sie eignen sich besonders, um mit geringem Aufwand eine höhere Rechenleistung zu erzielen.
Ähnlich wie Daten, die sich in einem lokalen Dateisystem eines PCs befinden, werden Daten in Hadoop in einem verteilten Dateisystem gespeichert, das als Hadoop bezeichnet wird. Hadoop verteiltes DateisystemDas Verarbeitungsmodell basiert auf dem „Datenlokalität“ Das Konzept sieht vor, dass die Berechnungslogik an die Clusterknoten (Server) gesendet wird, die die Daten enthalten. Diese Berechnungslogik ist einfach eine kompilierte Version eines Programms, das in einer höheren Programmiersprache wie beispielsweise … geschrieben ist. JavaEin solches Programm verarbeitet Daten, die in Hadoop HDFS.
Weißt du es? Ein Computercluster besteht aus mehreren Verarbeitungseinheiten (Speicherplatte + Prozessor), die miteinander verbunden sind und als ein einziges System fungieren.
Version 3.5.0, veröffentlicht am 2. April 2026, ist die aktuelle stabile Version; die 3.4-Reihe erhält weiterhin Wartungsupdates.
Hadoop-Ökosystem und Komponenten
Das untenstehende Diagramm zeigt die verschiedenen Komponenten des Hadoop-Ökosystems, gruppiert nach der Aufgabe, die jede von ihnen erfüllt – Speicherung, Verarbeitung und die dazugehörigen Abfrage-, Aufnahme- und Koordinierungswerkzeuge.

Apache Hadoop besteht aus zwei Teilprojekten –
- Hadoop MapReduce: MapReduce ist ein Rechenmodell und Software-Framework zum Schreiben von Anwendungen, die auf Hadoop ausgeführt werden. Diese MapReduce-Programme können enorme Datenmengen parallel auf großen Clustern von Rechenknoten verarbeiten.
- HDFS (Hadoop verteiltes Dateisystem): HDFS kümmert sich um den Speicherteil von Hadoop-Anwendungen. MapReduce-Anwendungen nutzen Daten von HDFS. HDFS erstellt mehrere Replikate von Datenblöcken und verteilt sie auf Rechenknoten in einem Cluster. Diese Verteilung ermöglicht zuverlässige und extrem schnelle Berechnungen.
Die aktuellen Versionen enthalten zwei weitere Kernmodule. Hadoop-GARN, hinzugefügt in Hadoop 2.x, plant die Arbeit auf dem Cluster, und Hadoop-Common hält die gemeinsame Java Bibliotheken, von denen jedes Modul abhängt. YARN ermöglicht es Engines wie … SparkTez und Flink laufen parallel zu MapReduce.
Obwohl Hadoop vor allem für MapReduce und sein verteiltes Dateisystem HDFS bekannt ist, wird der Begriff auch für eine Reihe verwandter Projekte verwendet, die unter den Oberbegriff verteiltes Rechnen und Verarbeitung großer Datenmengen fallen. Weitere Hadoop-bezogene Projekte bei Apache sind: Hive, HBase, Mahout, Sqoop, Flumeund ZooKeeper.
Hadoop Architektur
Hadoop verfügt über eine Master-Slave-Architektur für die Datenspeicherung und verteilte Datenverarbeitung. MapReduce und HDFS-Methoden. Das folgende Diagramm stellt diese Rollen nebeneinander dar, mit der Speicherschicht auf der einen Seite und der Verarbeitungsschicht auf der anderen.
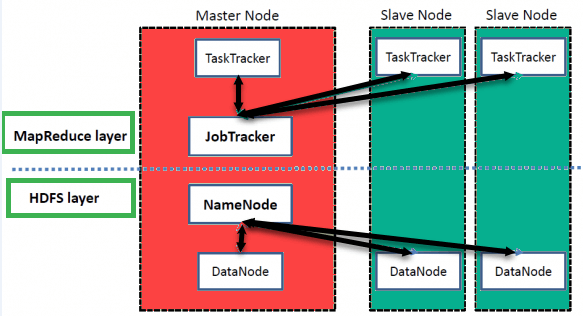
High-Level-Hadoop Architektur
NameNode
Der NameNode speichert die Metadaten für jede Datei und jedes Verzeichnis, das im Namensraum verwendet wird, einschließlich der Blöcke, aus denen jede Datei besteht, und wo sich diese Blöcke befinden.
Datenknoten
Ein DataNode verwaltet den Zustand eines HDFS-Knotens und ermöglicht die Interaktion mit den darin gespeicherten Blöcken. Er sendet regelmäßig Blockberichte und Heartbeats an den NameNode zurück.
MasterNode
Der Masterknoten ermöglicht Ihnen die parallele Verarbeitung von Daten mithilfe von Hadoop MapReduce.
Slave-Knoten
Die Slave-Knoten sind zusätzliche Maschinen im Hadoop-Cluster, die das Speichern von Daten und das Ausführen komplexer Berechnungen ermöglichen. Darüber hinaus führt jeder Slave-Knoten eine Aufgabe aus.Tracker und ein DataNode. Dies ermöglicht die Synchronisierung der Prozesse mit dem NameNode und dem Job.Tracker bzw.
In Hadoop können Master- oder Slave-Systeme in der Cloud oder lokal eingerichtet werden.
Eine Anmerkung zur Namensgebung: JobTracker und AufgabeTracker Sie gehören zur MapReduce-Laufzeitumgebung der ersten Generation (MRv1). Ab Hadoop 2.x teilt YARN seine Aufgaben zwischen einem clusterweiten Netzwerk auf. Ressourcenmanagerherunter, eine NodeManager pro Arbeiter und eins Bewerbungsmaster pro Auftrag. NameNode und DataNode bleiben unverändert.
Merkmale von Hadoop
Geeignet für Big-Data-Analyse
As Big Data Da Datenmengen tendenziell verteilt und unstrukturiert sind, eignen sich Hadoop-Cluster optimal für die Analyse von Big Data. Da die Verarbeitungslogik (und nicht die eigentlichen Daten) zu den Rechenknoten fließt, wird weniger Netzwerkbandbreite verbraucht. Dies wird als … bezeichnet. Datenlokalitätskonzeptund es trägt dazu bei, die Effizienz von Hadoop-basierten Anwendungen zu steigern.
Skalierbarkeit
Hadoop-Cluster lassen sich durch Hinzufügen weiterer Clusterknoten problemlos beliebig skalieren und ermöglichen so das Wachstum von Big Data. Die Skalierung erfordert zudem keine Änderungen an der Anwendungslogik.
Fehlertoleranz
Das Hadoop-Ökosystem bietet die Möglichkeit, die Eingabedaten auf andere Clusterknoten zu replizieren. Dadurch kann die Datenverarbeitung im Falle eines Clusterknotenausfalls mithilfe der auf einem anderen Clusterknoten gespeicherten Daten fortgesetzt werden. HDFS speichert standardmäßig drei Kopien jedes Blocks; dieser Wert wird vom System festgelegt. dfs.replication Eigenschaft, und der NameNode repliziert jeden Block neu, der unter diesen Wert fällt.
Netzwerk-Topologie in Hadoop
Die Topologie (Anordnung) des Netzwerks beeinflusst die Leistung des Hadoop-Clusters mit zunehmender Clustergröße. Neben der Leistung sind auch hohe Verfügbarkeit und die Fehlerbehandlung wichtige Faktoren. Um dies zu gewährleisten, nutzt die Hadoop-Clusterbildung die Netzwerktopologie.
Das untenstehende Baumdiagramm zeigt, wie diese Anordnung modelliert wird, vom Rechenzentrum bis hin zu den Knoten in jedem Rack.

Die Netzwerkbandbreite ist typischerweise ein wichtiger Faktor beim Aufbau eines Netzwerks. Da die Messung der Bandbreite jedoch schwierig sein kann, wird ein Netzwerk in Hadoop als Baum dargestellt. Die Distanz zwischen den Knoten dieses Baums (die Anzahl der Hops) gilt dabei als wichtiger Faktor für die Bildung eines Hadoop-Clusters. Die Distanz zwischen zwei Knoten entspricht der Summe ihrer Distanzen zu ihrem nächsten gemeinsamen Vorfahren.
Ein Hadoop-Cluster besteht aus einem Rechenzentrum, dem Rack und den Knoten, die die Jobs ausführen. Das Rechenzentrum besteht aus Racks, und ein Rack enthält Knoten. Die für Prozesse verfügbare Netzwerkbandbreite variiert je nach Standort der Prozesse. Das heißt, die verfügbare Bandbreite nimmt mit zunehmender Entfernung vom Standort ab.
- Prozesse auf demselben Knoten
- Verschiedene Knoten im selben Rack
- Knoten auf verschiedenen Racks desselben Rechenzentrums
- Knoten in verschiedenen Rechenzentren
Rack Awareness verwendet denselben Baum: HDFS platziert Replikate auf mehr als einem Rack, sodass der Verlust eines Rack-Switches nicht alle Kopien der Daten mit sich bringt.
