
Wie stellt man das ein Cassandra Cluster auf mehreren Knoten
 Redaktion
⚡ Intelligente Zusammenfassung
Cassandra Cluster Mehrere Knoten werden gruppiert, sodass die Daten verteilt werden und keine einzelne Maschine alle Daten speichert. Diese Seite erklärt die Clusterkomponenten, den Partitioner und den Token Ring, die Voraussetzungen, die Konfigurationseinstellungen zum Verbinden der Knoten und wie das Ergebnis überprüft werden kann.
Was ist Cassandra Cluster?
A Cassandra Cluster ist eine der Schalen im Ganzen Cassandra Datenbank. Die Cassandra Der Cluster enthält zahlreiche verschiedene Schichten von Speichereinheiten, und jede Schicht enthält die anderen.
Große Organisation wie z AmazonUnternehmen wie Facebook usw. müssen riesige Datenmengen verwalten. Diese Organisationen können diese Datenmengen nicht auf einem einzigen Rechner speichern. Deshalb verwenden sie Datenbanken wie … Cassandra mit verteilter Architektur.
Diese Organisationen speichern diese riesigen Datenmengen auf mehreren Knoten. Diese Knoten kommunizieren miteinander. Zu diesem Zweck Cassandra Cluster wird eingerichtet.
- Cluster Es handelt sich im Grunde um eine Gruppe von Knoten, sodass die Knoten problemlos miteinander kommunizieren können.
- Der Koordinatorknoten empfängt Clientanfragen und kommuniziert im Namen des Clients mit den Replikaten. Jeder Knoten kann als Koordinator für beliebige Anfragen fungieren.
Partitionierer
Ein Partitionierer bestimmt, wie die Daten im Cluster verteilt werden sollen. Der Partitionierer verwendet eine Hash-Funktion, um die Daten im Cluster zu verteilen. Er benötigt den Partitionsschlüssel, um den Hash zu berechnen. Dieser Hash heißt Zeichen. Die Datenverteilung erfolgt auf Basis dieses Tokens.
Der Standardpartitioner ist Murmur3Partitioner, der Token gleichmäßig über einen festen Bereich verteilt erzeugt. Jeder Knoten besitzt einen oder mehrere Bereiche dieses Bereichs, und die Gesamtheit der Bereiche bildet den Token. Token-RingDa die Zuordnung per Hash und nicht per Wert erfolgt, werden beim Hinzufügen eines Knotens nur die Bereiche verschoben, die er übernimmt, anstatt den gesamten Datensatz neu zu mischen.
Voraussetzungen für Cassandra Cluster
Für die Clustereinrichtung gelten die folgenden Anforderungen.
- Sie sollten mehrere Maschinen, physische oder virtuelle, als Knotenpunkte einsetzen.
- Die Knoten müssen im Netzwerk miteinander erreichbar sein. Die Ports 7000 für den Datenverkehr zwischen den Knoten, 7001 (falls TLS aktiviert ist) und 9042 für Client-Verbindungen müssen zwischen ihnen geöffnet sein.
- Linux sollte auf jedem Knoten installiert sein. Es ist die Plattform. Cassandra wird getestet und unterstützt auf
- Apache Cassandra Die Software muss auf jedem Knoten in derselben Version installiert sein. Unterschiedliche Versionen können keine Schemaübereinstimmung herstellen.
- A unterstützt JDK muss auf jedem Rechner installiert sein, wobei JAVA_HOME gesetzt sein muss.
- Die Uhren müssen mit NTP synchronisiert werden. Cassandra Konfliktierende Schreibvorgänge werden anhand des Zeitstempels aufgelöst, sodass eine Taktabweichung unbemerkt zu falschen Ergebnissen führt.
Die letzte Anforderung wird am häufigsten übersehen, und das führt eher zu Datenproblemen als zu Startproblemen.
.
So installieren Sie Cassandra Cluster unter Linux
Cassandra DataStax Enterprise muss auf jedem Rechner installiert werden, bevor dieser einem Cluster beitreten kann. Die folgenden Screenshots stammen vom grafischen Installationsprogramm von DataStax Enterprise, das zum Zeitpunkt der Erstellung dieser Anleitung die gängige Installationsmethode war. Da dieses Installationsprogramm nicht mehr für die Community bereitgestellt wird, wird zunächst die aktuelle Vorgehensweise beschrieben, der Installationsassistent folgt anschließend als Referenz.
Aktuelle Methode: Installieren Sie die Apache Cassandra Das Paket oder Binär-Tarball wird auf jedem Knoten identisch erstellt. Anschließend wird überprüft, ob jeder Knoten einzeln startet, bevor versucht wird, sie zu verbinden.
tar -xzf apache-cassandra-x.y.z-bin.tar.gz -C /opt/
export CASSANDRA_HOME=/opt/apache-cassandra-x.y.z
$CASSANDRA_HOME/bin/cassandra -f
Sobald ein einzelner Knoten ordnungsgemäß gestartet ist, stoppen Sie ihn, löschen Sie sein Datenverzeichnis und fahren Sie mit dem unten stehenden Abschnitt zur Clusterkonfiguration fort.
Schritt 1) Führen Sie die Cassandra Einrichtung der Enterprise Edition. Linux Öffnen Sie das Terminal und führen Sie das Setup aus. Die folgende Seite wird angezeigt.

Diese Seite stellt keine notwendigen Informationen bereit. Es liefert lediglich Informationen über die Cassandra Ausführung. Überspringen Sie also diese Seite und klicken Sie auf die Schaltfläche „Weiter“.
Schritt 2) Akzeptieren Sie die Lizenzvereinbarung. Nach dem Klicken auf „Weiter“ wird die folgende Seite angezeigt.

Diese Seite bietet Informationen zu den Paketen und Unterpaketen im Cassandra Das Programm wird nun installiert. Im Anschluss werden Sie nach der Lizenz gefragt. Aktivieren Sie das Kontrollkästchen „Ich akzeptiere die Vereinbarung“ und klicken Sie auf „Weiter“.
Schritt 3) Installieren Sie Builder und klicken Sie auf Weiter. Nach dem Klicken auf Weiter wird Ihnen die folgende Seite angezeigt.

Auf dieser Seite werden Sie nach den Installationsmöglichkeiten gefragt.
- Zunächst wird nach dem Installationsverzeichnis gefragt. Standardmäßig wird es im Home-Verzeichnis installiert.
- Als nächstes werden Sie nach dem Installationstyp gefragt. Wählen Sie „Einfache Installation“ aus.
- Als nächstes wird nach dem Update-System gefragt. Klicken Sie auf „Nein“.
- Als Nächstes werden Sie nach der Standardschnittstelle gefragt. Es gibt zwei Möglichkeiten: Sie können die Installation lokal durchführen oder eine IP-Adresse auswählen. Wählen Sie für die Installation eine IP-Adresse.
- Drücken Sie die nächste Taste.
Schritt 4) Richten Sie den Knoten ein und klicken Sie auf „Weiter“. Nach dem Klicken auf die Schaltfläche „Weiter“ wird die folgende Seite angezeigt.

Auf dieser Seite wird nach der Knoteneinrichtung gefragt.
- Wählen Sie zunächst den Knotentyp „Cassandra Knoten'.
- Geben Sie als Nächstes unter „Ringname“ Ihren Clusternamen ein. Cluster Der Name sollte für alle Knoten im selben Cluster derselbe sein.
- Wählen Sie als Nächstes den Startknoten aus. Der Startknoten ist der Knoten, mit dem alle anderen Knoten (außer dem Startknoten) beim Start in Kontakt treten.
- Nachdem Sie diese Informationen eingegeben haben, klicken Sie auf die Schaltfläche „Weiter“.
Schritt 5) Installieren Sie den Überwachungsagenten. Nach dem Klicken auf „Weiter“ wird die folgende Seite angezeigt. Auf dieser Seite werden Sie nach der IP-Adresse gefragt, unter der der Agent installiert werden soll.
- Der Agent wird für die Überwachungskonsole benötigt, in der alle Knoten an einem Ort beobachtet werden können.
- Nachdem Sie diese Informationen eingegeben haben, klicken Sie auf die Schaltfläche „Weiter“.

Schritt 6) Klicken Sie auf „Weiter“, um zur Installation zu gelangen. Nach dem Klicken auf „Weiter“ wird die folgende Seite angezeigt.

Jetzt ist das Setup zur Installation bereit. Drücken Sie die Weiter-Taste.
Schritt 7) Bitte warten Sie, bis die Installation abgeschlossen ist. Nach dem Klicken auf „Weiter“ wird die folgende Seite angezeigt.
Die Installation wird gestartet.
Schritt 8) Klicken Sie auf die Schaltfläche „Fertigstellen“. Nach der Installation wird die folgende Seite angezeigt. Auf dieser Seite sehen Sie das Häkchen bei der Option, die standardmäßig ausgewählt ist.

Konfiguration der cassandra.yaml-Datei zum Verbinden von Knoten
Die Installation allein erzeugt noch keinen Cluster. Die Knoten finden sich erst dann gegenseitig, wenn vier Einstellungen in der cassandra.yaml-Datei übereinstimmen, und genau in dieser Datei liegt der Fehler bei den meisten Cluster-Konfigurationen.
cluster_name: 'Guru99 Cluster'
seed_provider:
  - class_name: org.apache.cassandra.locator.SimpleSeedProvider
    parameters:
      - seeds: "192.168.1.10,192.168.1.11"
listen_address: 192.168.1.10
rpc_address: 0.0.0.0
broadcast_rpc_address: 192.168.1.10
endpoint_snitch: GossipingPropertyFileSnitch
- Clustername Die Übereinstimmung muss auf jedem Knotenpunkt erfolgen. Eine Nichtübereinstimmung ist die häufigste Ursache dafür, dass ein Knoten den Beitritt verweigert.
- Saatgut listet die Kontaktpunkte auf, mit denen ein Startknoten kommuniziert. Zwei oder drei Startknoten pro Rechenzentrum sind ausreichend; wenn jeder Knoten ein Startknoten ist, wird ein automatischer Bootstrap verhindert.ping.
- listen_address Dies ist die Adresse, über die andere Knoten diesen Knoten erreichen. Es muss eine gültige, routingfähige Adresse sein, niemals localhost.
- endpoint_snitch erzählt Cassandra Rack- und Rechenzentrumslayout. GossipingDie übliche Wahl ist PropertyFileSnitch, wobei die Werte in cassandra-rackdc.properties festgelegt werden.
Die Änderung des Snitch- oder Clusternamens, nachdem bereits Daten vorhanden sind, erfordert zusätzliche Schritte; daher sollten beide vor dem Start des ersten Knotens festgelegt werden.
Schon ab Cassandra Knoten
Nach der Installation Cassandra Starten Sie auf jedem Knoten die Server und befolgen Sie die unten stehenden Schritte. Die Reihenfolge ist wichtig: Starten Sie zuerst die Seed-Knoten nacheinander und warten Sie, bis jeder Knoten seine Betriebsbereitschaft meldet, bevor Sie den nächsten starten. Das gleichzeitige Starten mehrerer Knoten kann zu Tokenbereichskonflikten führen.
Schritt 1) Gehen Sie zur Cassandra Installationsverzeichnis und Server starten.
bin/cassandra -f

Durch Ausführen dieses Befehls Cassandra Der Server wird gestartet. Hier ist der Screenshot, auf dem der Cassandra Der Server wird gestartet.
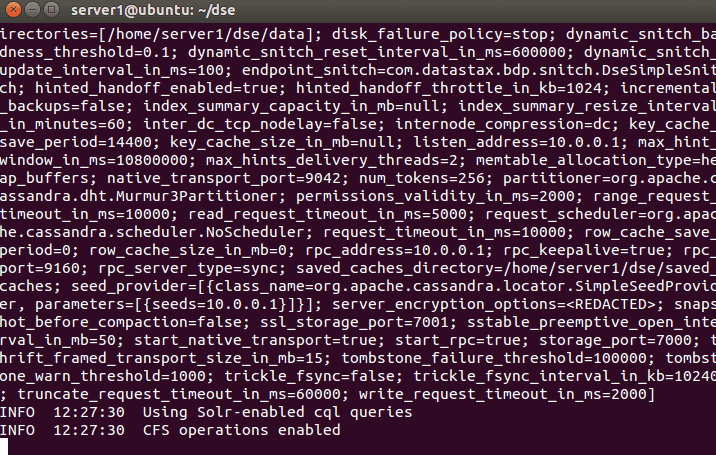
Nach etwa einer Minute ist der Server betriebsbereit. Starten Sie die einzelnen Node-Server nacheinander. Nachdem alle Node-Server gestartet wurden, … Cassandra Der Cluster ist einsatzbereit.
Schritt 2) Überprüfen Sie, ob alle Knoten beigetreten sind, indem Sie den Ring von einem beliebigen Knoten aus prüfen.
nodetool status
nodetool describecluster
Jeder Knoten sollte mit dem Status angezeigt werden. UNDies bedeutet, dass die Knoten aktiv und normal sind, und die Spalte „Owns“ sollte annähernd gleiche Prozentwerte aufweisen. Eine einheitliche Schemaversion in der Ausgabe von describecluster bestätigt, dass alle Knoten das Schema verwenden.
Drei Symptome decken die meisten Fehler ab. Ein Knoten, der nie angezeigt wird, hat in der Regel einen nicht übereinstimmenden Clusternamen oder einen blockierten Port 7000. Ein Knoten, der festhängt bei UJDer Beitrittsprozess streamt weiterhin Daten und benötigt auf einem großen Cluster lediglich etwas Zeit. Die stark ungleiche Verteilung der Daten deutet auf eine Fehlkonfiguration des Snitch-Servers hin, bei der die Knoten im falschen Rack oder Rechenzentrum platziert wurden.
Wenn der Ring fehlerfrei funktioniert, legen die Replikationseinstellungen für jeden Schlüsselbereich fest, wie die Daten darin verteilt werden, wie in der Dokumentation beschrieben. Cassandra Schlüsselraum Tutorial und das Cassandra Architektur Nervenzusammenbruch.
