
Problem des Handlungsreisenden: Python, C++ Algorithmus
 Redaktion
⚡ Intelligente Zusammenfassung
Das Problem des Handlungsreisenden ist eine klassische NP-schwere Optimierungsaufgabe, bei der die kürzeste Tour gesucht wird, die jede Stadt genau einmal besucht und zum Ausgangspunkt zurückkehrt. Die Entfernungsdaten werden über einen Graphen bereitgestellt.
Was ist das Travelling-Salesman-Problem (TSP)?
Das Problem des Handlungsreisenden (Travelling Salesman Problem, TSP) ist ein klassisches kombinatorisches Optimierungsproblem der theoretischen Informatik. Gegeben ein Graph von Städten, fragt das TSP nach dem kürzesten Pfad, der jeden Knoten genau einmal besucht und zur Ausgangsstadt zurückkehrt.
Die Aufgabenstellung enthält eine Liste von Städten sowie die Entfernungen zwischen jeweils zwei Städten.
Ziel: Man beginnt in der Startstadt, besucht jede andere Stadt genau einmal und kehrt dann zur Startstadt zurück. Ziel ist es, die kürzeste mögliche Rundreise zu finden.
Beispiel für TSP
Betrachten Sie die untenstehende Grafik, in der 1, 2, 3 und 4 die Städte darstellen und das Gewicht an jeder Kante die Entfernung zwischen diesen Städten angibt.
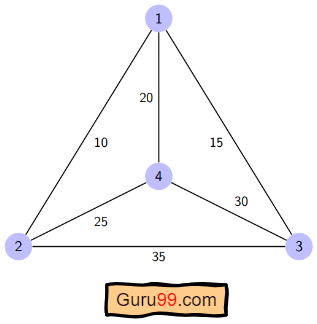
Ziel ist es, die kürzestmögliche Tour zu finden, die in der Ausgangsstadt beginnt, jede andere Stadt genau einmal besucht und zur Ausgangsstadt zurückkehrt.
Für die obige Grafik ist die optimale Route folgende: 1-2-4-3-1Die Kosten der kürzesten Tour betragen 10 + 25 + 30 + 15 = 80.
Verschiedene Lösungen für das Problem des Handlungsreisenden

Das Problem des Handlungsreisenden wird als NP-schwer eingestuft, da es keinen bekannten Polynomialzeitalgorithmus gibt, der es exakt löst. Die Komplexität wächst exponentiell mit der Anzahl der Städte.
Es gibt mehrere Möglichkeiten, TSP anzugreifen. Die gängigsten Ansätze sind:
Brute-Force-Ansatz: Die naive Methode berechnet jede mögliche Tour und vergleicht sie. Die Anzahl der Touren in einem Graphen mit n Städten beträgt n!, was die Brute-Force-Methode für alles über etwa zehn Städte hinaus zu einem sehr hohen Rechenaufwand macht.
Branch-and-Bound-Verfahren: Das Problem wird in Teilprobleme zerlegt, deren Lösungen zu einer optimalen Lösung kombiniert werden. Durch effektives Pruning werden Teillösungen verworfen, die die aktuell besten Kosten nicht unterbieten können.
Dieses Tutorial demonstriert die dynamischer Programmieransatz, was die memoisierte Version des Branch-and-Bound-Verfahrens ist und dem Bellman-Held-Karp-Algorithmus entspricht.
Dynamische Programmierung: Dies ist eine exakte Methode, die durch die Wiederverwendung von Überlappungen die optimale Lösung sucht.ping Ergebnisse des Teilproblems. Es ist langsamer als das nahezu optimale. gierige MethodenEs liefert aber immer eine global optimale Tour zurück.
Die Rechenkomplexität dieses Ansatzes ist O(N² × 2^N)worüber wir später im Artikel sprechen werden.
Nächste-Nachbar-Methode: Ein heuristischer Greedy-Ansatz, der stets zur nächstgelegenen unbesuchten Stadt springt. Er ist deutlich effizienter als dynamische Programmierung, garantiert aber keine optimale Tour und wird daher für nahezu optimale Lösungen verwendet, wenn Geschwindigkeit wichtiger ist als exakte Minima.
Algorithmus für das Problem des Handlungsreisenden
Wir verwenden den Ansatz der dynamischen Programmierung zur Lösung des TSP. Bevor wir mit dem Algorithmus beginnen, wollen wir einige Begriffe klären:
- Ein Graph
G = (V, E)ist eine Menge von Knoten und Kanten. Vist die Menge der Eckpunkte.Eist die Menge der Kanten.- Eckpunkte werden durch Kanten verbunden.
Dist(i, j)bezeichnet den nichtnegativen Abstand zwischen den Knoten i und j.
Angenommen, S ist eine Teilmenge von Städten aus {1, 2, 3, …, n}, wobei i und j zwei Städte in dieser Teilmenge sind. Dann cost(i, S, j) ist die Länge des kürzesten Weges, der bei i beginnt, jede Stadt in S genau einmal besucht und bei j endet.
Zum Beispiel, cost(1, {2, 3, 4}, 1) bezeichnet den kürzesten Weg, wobei:
- Startstadt ist 1
- Die Städte 2, 3 und 4 werden nur einmal besucht
- Der Endpunkt ist 1
Die dynamische Programmierungsrekursion lautet:
- Stelle den
cost(i, {}, i) = 0Das bedeutet, dass wir bei i mit Nullkosten beginnen und enden. - Wenn die Funktion
|S| > 1, definierencost(i, S, 1) = ∞füri ≠ 1weil die tatsächlichen Tourkosten noch unbekannt sind. - Ausgehend von Stadt 1 wähle die nächste Stadt so, dass
cost(i, S, j) = min [ cost(i, S − {i}, j) + dist(i, j) ]füri ∈ Sundi ≠ j.
Für das obige Diagramm lautet die Adjazenzmatrix wie folgt:
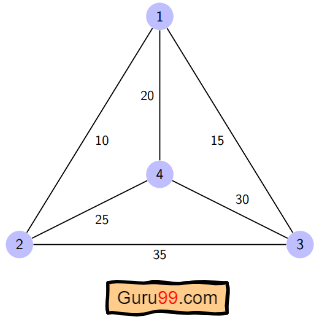
| dist(i, j) | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| 1 | 0 | 10 | 15 | 20 |
| 2 | 10 | 0 | 35 | 25 |
| 3 | 15 | 35 | 0 | 30 |
| 4 | 20 | 25 | 30 | 0 |
So funktioniert der Algorithmus:
Schritt 1) Die Reise beginnt in Stadt 1, besucht jede andere Stadt einmal und kehrt dann nach Stadt 1 zurück.
Schritt 2) S ist eine Teilmenge der Städte. Für jedes |S| > 1 initialisiere cost(i, S, 1) = ∞. Hier cost(i, S, j) bezeichnet eine Tour, die bei i beginnt, die Städte in S einmal besucht und j erreicht. Wir beginnen im Unendlichen, da die Entfernung zu diesem Zeitpunkt unbekannt ist. Die Werte sind also:
cost(2, {3, 4}, 1) = ∞ Das bedeutet, wir starten in Stadt 2, durchlaufen die Städte 3 und 4 und erreichen Stadt 1, wobei die Kosten unbekannt sind. Ähnlich:
cost(3, {2, 4}, 1) = ∞
cost(4, {2, 3}, 1) = ∞
Schritt 3) Berechne für jede Teilmenge von S:
cost(i, S, j) = min [ cost(i, S − {i}, j) + dist(i, j) ], Wobei j ∈ S und i ≠ j.
Das ist die kostengünstigste Tour, die in Stadt i beginnt, die Teilmenge der Städte einmal besucht und nach Stadt j zurückkehrt. Da die Tour in Stadt 1 beginnt, betragen die optimalen Kosten cost(1, {other cities}, 1).
Die Wiederholung Schritt für Schritt bearbeiten
Nun ist S = {1, 2, 3, 4}. Es gibt vier Elemente, also ist die Anzahl der Teilmengen 2^4 = 16Diese Teilmengen sind:
1) |S| = 0: {Φ}
2) |S| = 1: {{1}, {2}, {3}, {4}}
3) |S| = 2: {{1, 2}, {1, 3}, {1, 4}, {2, 3}, {2, 4}, {3, 4}}
4) |S| = 3: {{1, 2, 3}, {1, 2, 4}, {2, 3, 4}, {1, 3, 4}}
5) |S| = 4: {{1, 2, 3, 4}}
Da die Tour in Stadt 1 beginnt, können wir bei der Berechnung der Zwischenkosten alle Teilmengen, die Stadt 1 enthalten, verwerfen.
Die Berechnung des Algorithmus verläuft wie folgt:
1) |S| = Φ:
- Kosten(2, Φ, 1) = Distanz(2, 1) = 10
- Kosten(3, Φ, 1) = Distanz(3, 1) = 15
- Kosten(4, Φ, 1) = Distanz(4, 1) = 20
2) |S| = 1:
- cost(2, {3}, 1) = dist(2, 3) + cost(3, Φ, 1) = 35 + 15 = 50
- cost(2, {4}, 1) = dist(2, 4) + cost(4, Φ, 1) = 25 + 20 = 45
- cost(3, {2}, 1) = dist(3, 2) + cost(2, Φ, 1) = 35 + 10 = 45
- cost(3, {4}, 1) = dist(3, 4) + cost(4, Φ, 1) = 30 + 20 = 50
- cost(4, {2}, 1) = dist(4, 2) + cost(2, Φ, 1) = 25 + 10 = 35
- cost(4, {3}, 1) = dist(4, 3) + cost(3, Φ, 1) = 30 + 15 = 45
3) |S| = 2:
- cost(2, {3, 4}, 1) = min [ dist(2, 3) + cost(3, {4}, 1) = 35 + 50 = 85, dist(2, 4) + cost(4, {3}, 1) = 25 + 45 = 70 ] = 70
- cost(3, {2, 4}, 1) = min [ dist(3, 2) + cost(2, {4}, 1) = 35 + 45 = 80, dist(3, 4) + cost(4, {2}, 1) = 30 + 35 = 65 ] = 65
- cost(4, {2, 3}, 1) = min [ dist(4, 2) + cost(2, {3}, 1) = 25 + 50 = 75, dist(4, 3) + cost(3, {2}, 1) = 30 + 45 = 75 ] = 75
4) |S| = 3:
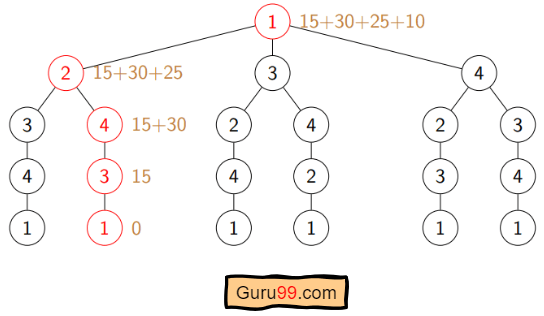
- cost(1, {2, 3, 4}, 1) = min [ dist(1, 2) + cost(2, {3, 4}, 1) = 10 + 70 = 80, dist(1, 3) + cost(3, {2, 4}, 1) = 15 + 65 = 80, dist(1, 4) + cost(4, {2, 3}, 1) = 20 + 75 = 95 ] = 80
Die optimale Lösung lautet also: 1-2-4-3-1.
Pseudocode
Algorithm: Traveling-Salesman-Problem
Cost (1, {}, 1) = 0
for s = 2 to n do
    for all subsets S belongs to {1, 2, 3, ..., n} of size s
        Cost (s, S, 1) = Infinity
    for all i in S and i != 1
        Cost (i, S, j) = min {Cost (i, S - {i}, j) + dist(i, j) for j in S and i != j}
Return min(i) Cost (i, {1, 2, 3, ..., n}, j) + d(j, i)
Implementierung in C/C++
Hier ist die Implementierung in C++Die unten stehende Version behebt einen frühen Fehler im Quellcode. return Fehler, der dazu führte, dass nach der allerersten Permutation eine Rückkehr erfolgte, anstatt alle Touren aufzuzählen.
#include <bits/stdc++.h>
using namespace std;
#define V 4
#define MAX 1000000

int tsp(int graph[][V], int s) {
    vector<int> vertex;
    for (int i = 0; i < V; i++)
        if (i != s)
            vertex.push_back(i);

    int min_cost = MAX;
    do {
        int current_cost = 0;
        int j = s;
        for (int i = 0; i < vertex.size(); i++) {
            current_cost += graph[j][vertex[i]];
            j = vertex[i];
        }
        current_cost += graph[j][s];
        min_cost = min(min_cost, current_cost);
    } while (next_permutation(vertex.begin(), vertex.end()));

    return min_cost;
}

int main() {
    int graph[][V] = {
        { 0, 10, 15, 20 },
        { 10, 0, 35, 25 },
        { 15, 35, 0, 30 },
        { 20, 25, 30, 0 }
    };
    int s = 0;
    cout << tsp(graph, s) << endl;
    return 0;
}
Ausgang:
80
Umsetzung in Python
Das Python Die Umsetzung spiegelt die C++ Version. Sie korrigiert die Quellcode-Version. from itertools, import Komma-Tippfehler, das falsch platzierte return innerhalb der inneren Schleife und der zufälligen Einbuchtung auf s = 0.
from sys import maxsize
from itertools import permutations

V = 4

def tsp(graph, s):
    vertex = []
    for i in range(V):
        if i != s:
            vertex.append(i)

    min_cost = maxsize
    for perm in permutations(vertex):
        current_cost = 0
        k = s
        for j in perm:
            current_cost += graph[k][j]
            k = j
        current_cost += graph[k][s]
        min_cost = min(min_cost, current_cost)
    return min_cost

graph = [[0, 10, 15, 20],
         [10, 0, 35, 25],
         [15, 35, 0, 30],
         [20, 25, 30, 0]]
s = 0
print(tsp(graph, s))
Ausgang:
80
Akademische Lösungen für TSP
Informatiker suchen seit Jahrzehnten nach verbesserten Polynomzeitalgorithmen für das Problem des Handlungsreisenden. Bislang gilt das TSP weiterhin als NP-schwer.
Mehrere veröffentlichte Verfahren reduzieren die praktische Komplexität für bestimmte Familien von TSP-Instanzen:
- Das klassische symmetrische TSP wird durch das Methode mit Nullsuffix.
- Das Biogeographiebasierter Optimierungsalgorithmus nutzt Migrationsstrategien zur Lösung von Optimierungsproblemen, die dem TSP zugeordnet werden können.
- Das Evolutionärer Multi-Objective-Algorithmus ist für das mehrkriterielle TSP konzipiert und basiert auf NSGA-II.
- Das Multi-Agenten-System Der Ansatz löst das TSP für N Städte mit festen Rechenressourcen.
- Das Lin-Kernighan-Heuristik und sein Nachfolger LKH Touren innerhalb von 2-3% des Optimums für Fälle mit Millionen von Städten anbieten.
- Kongruenz Verwendet Schnittebenen und Branch-and-Cut, um exakte Optima für Benchmark-Instanzen mit Zehntausenden von Städten zu berechnen.
Anwendung des Problems des Handlungsreisenden
Das Problem des Handlungsreisenden tritt in der realen Welt sowohl in reiner als auch in abgewandelter Form auf. Einige der wichtigsten Anwendungsgebiete sind:
- Planung, Logistik und Mikrochip-Herstellung: Chip-Einsetzprobleme in der Mikrochip-Industrie werden als TSP-Varianten modelliert, um die Fahrzeit des Roboterarms zu minimieren.
- DNA-Sequenzierung: Bei der DNA-Sequenzierung wird ein modifiziertes TSP verwendet, bei dem Städte DNA-Fragmente und Entfernungen die Ähnlichkeit zwischen den Fragmenten darstellen.
- Astronomie: Astronomen nutzen TSP, um die Zeit zu minimieren, die für das Schwenken von Teleskopen zwischen Beobachtungszielen benötigt wird.
- Optimale Steuerung: TSP-Formulierungen modellieren optimale Steuerungsprobleme, bei denen mehrere Nebenbedingungen eingehalten werden müssen, während gleichzeitig die Traversierungskosten minimiert werden.
- Zustellung auf der letzten Meile: AmazonUPS und Essensliefer-Apps lösen dynamische TSP-Varianten, um die Stopps für Fahrer zu sequenzieren.
- Kommissionierung im Lager: Robotergestützte und menschliche Kommissionierer folgen TSP-optimierten Routen, die die Wegezeiten innerhalb der Verteilzentren verkürzen.
Komplexitätsanalyse von TSP
- Zeitliche Komplexität: Der Held-Karp-Ansatz der dynamischen Programmierung löst 2N Teilmengen für jeden Startknoten, die ergeben
N × 2^NTeilprobleme. Die Kombination jedes Teilproblems benötigt lineare Zeit. Ist der Startknoten nicht festgelegt, ist eine äußere Schleife über N Knoten erforderlich. Die Gesamtzeitkomplexität beträgtO(N² × 2^N). - Raumkomplexität: Die DP-Tabelle speichert
C(S, i)für jede Teilmenge S der Knotenmenge. Es gibt 2N Teilmengen pro Knoten, daher ist die SpeicherkomplexitätO(N × 2^N), was oft geschrieben wird alsO(2^N)wenn N als fest betrachtet wird.
Erfahren Sie als nächstes mehr über die Sieb des Eratosthenes-Algorithmus.
