
Beaufsichtigtes maschinelles Lernen: Algorithms, Typen und Beispiele
 Evelyn Clarke
⚡ Intelligente Zusammenfassung
Beim überwachten maschinellen Lernen wird ein Algorithmus anhand von gekennzeichneten Beispielen trainiert, damit er Ergebnisse für Daten vorhersagen kann, die er noch nie zuvor gesehen hat. Dabei wird Regression für numerische Ziele und Klassifizierung für Kategorienziele wie Spam oder Betrug verwendet.
Was ist überwachtes maschinelles Lernen?
Überwachtes maschinelles Lernen ist ein Algorithmus, der anhand von gelabelten Trainingsdaten lernt, um Vorhersagen für unbekannte Daten zu treffen. Beim überwachten Lernen wird die Maschine mit gut gelabelten Daten trainiert. Das bedeutet, dass einige Daten bereits mit korrekten Antworten versehen sind. Man kann es mit dem Lernen unter Anleitung eines Lehrers vergleichen.
Der erfolgreiche Aufbau, die Skalierung und die Implementierung präziser, überwachter Machine-Learning-Modelle erfordern Zeit und das technische Know-how eines Teams hochqualifizierter Data Scientists. Diese müssen die Modelle zudem regelmäßig überarbeiten, damit die gewonnenen Erkenntnisse auch bei sich ändernden Daten gültig bleiben.
Wie überwachtes Lernen funktioniert
Beim überwachten maschinellen Lernen werden Trainingsdatensätze verwendet, um die gewünschten Ergebnisse zu erzielen. Diese Datensätze enthalten Eingaben und die richtige Ausgabe, die dem Modell hilft, schneller zu lernen. Beispielsweise möchten Sie einer Maschine beibringen, vorherzusagen, wie lange Sie für die Fahrt von Ihrem Arbeitsplatz nach Hause brauchen werden.
Hier beginnen Sie mit der Erstellung eines Satzes beschrifteter Daten. Zu diesen Daten gehören:
- Wetterverhältnisse
- Tageszeit
- Feiertage
- Ausgewählte Route
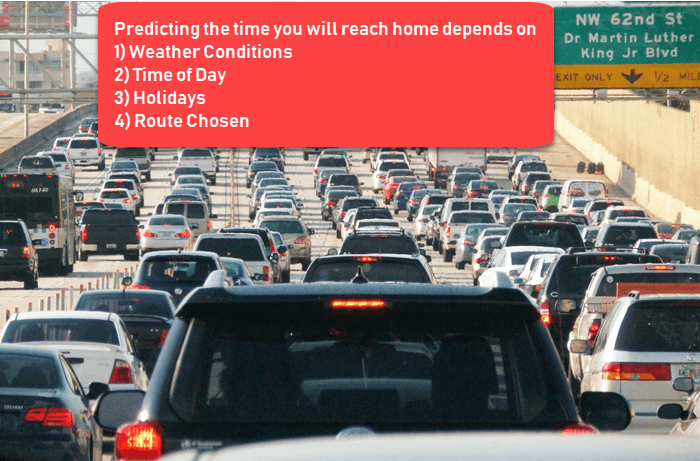
Alle diese Details sind Ihre Eingaben in diesem Beispiel für überwachtes Lernen. Die Ausgabe ist die Zeit, die Sie an diesem Tag für die Heimfahrt benötigt haben, wie die Abbildung unten zeigt.
Man weiß instinktiv, dass die Heimfahrt bei Regen länger dauert. Aber die Maschine braucht Daten und Statistiken.
Als Erstes müssen Sie einen Trainingsdatensatz erstellen. Dieser enthält die gesamte Pendelzeit und entsprechende Faktoren wie Wetter, Uhrzeit usw. Anhand dieses Trainingsdatensatzes kann Ihr System möglicherweise erkennen, dass ein direkter Zusammenhang zwischen der Regenmenge und Ihrer Heimfahrzeit besteht.
Das zeigt also, dass die Heimfahrt umso länger dauert, je stärker es regnet. Es könnte auch einen Zusammenhang zwischen dem Zeitpunkt, an dem Sie die Arbeit verlassen, und der Fahrzeit erkennen. Je näher Sie 6 Uhr kommen, desto länger dauert die Heimfahrt.
Ihr System erkennt möglicherweise einige Zusammenhänge in Ihren gekennzeichneten Daten. Diese Lernphase wird unten dargestellt.
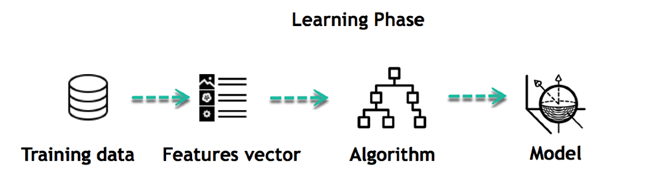
Dies ist der Beginn Ihres Datenmodells. Es erfasst zunächst, wie sich Regen auf das Fahrverhalten auswirkt und dass zu bestimmten Tageszeiten mehr Menschen unterwegs sind.
Arten des überwachten maschinellen Lernens Algorithms
Im Folgenden sind die Typen von überwachten maschinellen Lernalgorithmen aufgeführt:
Regression
Die Regressionstechnik sagt anhand von Trainingsdaten einen einzelnen kontinuierlichen Ausgabewert voraus.
Beispiel: Mithilfe der Regression können Sie den Hauspreis anhand von Trainingsdaten vorhersagen. Die Eingabevariablen sind Ort, Größe eines Hauses usw.
Stärken: Die Ergebnisse sind leicht zu interpretieren, und der Algorithmus kann regularisiert werden, um Überanpassung zu vermeiden.
Schwächen: Ein lineares Modell ist nicht flexibel und kann daher ohne zusätzliche Merkmale keine komplexen Zusammenhänge erfassen.
Hier sind einige Arten der Regression Algorithms:
- Lineare Regression
- Polynomialregression
- Ridge- und Lasso-Regression
- Logistische Regression (zur Klassifizierung)
- Entscheidungsbaum- und Random-Forest-Regression
- Support-Vektor-Regression
Logistische Regression:
Die logistische Regression dient der Schätzung diskreter Werte auf Basis einer gegebenen Menge unabhängiger Variablen. Sie hilft, die Eintrittswahrscheinlichkeit eines Ereignisses vorherzusagen, indem sie Daten an eine Logit-Funktion anpasst. Daher wird sie auch als Logit-Regression bezeichnet. Da sie eine Wahrscheinlichkeit vorhersagt, liegt ihr Ausgabewert zwischen 0 und 1. Bei mehreren oder nichtlinearen Entscheidungsgrenzen kann die Genauigkeit jedoch beeinträchtigt sein.
Klassifikation
Klassifizierung bedeutet, die Ausgabe einer Klasse zuzuordnen. Versucht der Algorithmus, die Eingabe in zwei verschiedene Klassen einzuordnen, spricht man von binärer Klassifizierung. Die Auswahl zwischen mehr als zwei Klassen wird als Mehrklassenklassifizierung bezeichnet.
Beispiel: Feststellung, ob jemand mit der Rückzahlung des Darlehens in Verzug geraten wird.
Stärken: Klassifikationsbäume bewähren sich in der Praxis sehr gut.
Schwächen: Unbeschränkt, neigen einzelne Bäume zu Überanpassung.
Hier sind einige Arten der Klassifizierung Algorithms:
- Naive Bayes Klassifikatoren
- Entscheidungsbäume
- Unterstützung Vektor Maschine
- K-Nächste Nachbarn
- Random Forest und Gradient Boosting
Naive Bayes-Klassifikatoren
Das Naiver Bayes Das Modell ist einfach zu erstellen und sehr nützlich für große Datensätze. Diese Methode basiert auf gerichteten azyklischen Graphen mit einem Elternknoten und mehreren Kindknoten. Sie setzt die Unabhängigkeit der Kindknoten von ihrem Elternknoten voraus.
Entscheidungsbäume
Entscheidungsbäume klassifizieren Daten, indem sie diese anhand ihrer Merkmalswerte sortieren. Dabei repräsentiert jeder Knoten ein Merkmal der zu klassifizierenden Daten, und jeder Zweig einen möglichen Wert des Knotens. Es handelt sich um eine weit verbreitete Klassifizierungsmethode.
Das gleiche Prinzip lässt sich auch für die Regression anwenden: Ein Regressionsbaum hilft dabei, reale Werte zu schätzen (Kosten für den Kauf eines Autos, Anzahl der Anrufe, monatlicher Gesamtumsatz usw.).
Unterstützung Vektor Maschine
Die Support Vector Machine (SVM) ist ein in den 1990er Jahren eingeführter Lernalgorithmus. Diese Methode basiert auf Ergebnissen der statistischen Lerntheorie, die von Vladimir Vapnik und seinen Kollegen entwickelt wurden.
SVMs sind eng mit Kernelfunktionen verknüpft, die ein zentrales Konzept für die meisten Lernaufgaben darstellen. Das Kernel-Framework und SVMs finden in verschiedenen Bereichen Anwendung, darunter Multimedia-Informationsabruf, Bioinformatik und Mustererkennung. Jeder der oben genannten Schätzer ist mit seinen Abstimmungsparametern dokumentiert. scikit-lernen Referenz.
Überwachte vs. unüberwachte maschinelle Lernverfahren
Die Methode daneben platzieren unbeaufsichtigtes Lernen macht seine Grenzen deutlich.
| Beyogen auf | Überwachte maschinelle Lerntechnik | Unbeaufsichtigte maschinelle Lerntechnik |
|---|---|---|
| Eingabedaten | Algorithms werden anhand gekennzeichneter Daten trainiert. | Algorithms werden für Daten verwendet, die nicht gekennzeichnet sind |
| Rechenkomplexität | Überwachtes Lernen ist eine einfachere Methode. | Unüberwachtes Lernen ist rechnerisch komplex |
| Genauigkeit | Sehr genaue und vertrauenswürdige Methode. | Less genaue und vertrauenswürdige Methode. |
| Typische Algorithmen | Logistische Regression, Entscheidungsbäume, SVM, Naive Bayes | K-Means, hierarchisches Clustering, PCA |
| Wie die Ergebnisse beurteilt werden | Bewertet im Vergleich zu bekannten Antworten (Genauigkeit, RMSE) | Bewertet anhand interner Kennzahlen und menschlicher Überprüfung |
Herausforderungen beim überwachten maschinellen Lernen
Hier sind die Herausforderungen beim überwachten maschinellen Lernen:
- Irrelevante Eingabemerkmale in den Trainingsdaten können zu ungenauen Ergebnissen führen.
- Die Datenaufbereitung und -vorverarbeitung ist immer eine Herausforderung.
- Die Genauigkeit leidet, wenn unmögliche, unwahrscheinliche und unvollständige Werte als Trainingsdaten eingegeben wurden.
- Wenn der betreffende Experte nicht verfügbar ist, bleibt als Alternative die „Brute-Force“-Methode. Das bedeutet, dass man erraten muss, mit welchen Merkmalen (Eingabevariablen) die Maschine trainiert werden soll, und diese Vermutung kann ungenau sein.
Vorteile des überwachten Lernens
Im Gegensatz zu diesen Herausforderungen bietet das überwachte maschinelle Lernen folgende Vorteile:
- Betreutes Lernen in Maschinelles lernen ermöglicht es Ihnen, Daten aus früheren Erfahrungen zu sammeln oder eine Datenausgabe zu erstellen.
- Hilft Ihnen, Leistungskriterien mithilfe von Erfahrung zu optimieren
- Überwachtes maschinelles Lernen hilft Ihnen, verschiedene Arten realer Rechenprobleme zu lösen.
Nachteile des überwachten Lernens
Nachfolgend sind die Nachteile des überwachten maschinellen Lernens aufgeführt:
- Die Entscheidungsgrenze könnte überangepasst sein, wenn Ihr Trainingsdatensatz keine Beispiele enthält, die Sie in einer Klasse haben möchten.
- Sie müssen viele gute Beispiele aus jeder Klasse auswählen, während Sie den Klassifikator trainieren.
- Die Klassifizierung großer Datenmengen kann eine echte Herausforderung sein.
- Das Training für überwachtes Lernen erfordert viel Rechenzeit.
Best Practices für überwachtes Lernen
Die folgende Sequenz hält ein Projekt am Laufen track:
- Bevor Sie irgendetwas anderes tun, entscheiden Sie, welche Art von Daten als Trainingsdatensatz verwendet werden sollen.
- Legen Sie die Struktur der zu lernenden Funktion und den Lernalgorithmus fest.
- Sammeln Sie entsprechende Ergebnisse entweder von menschlichen Experten oder aus Messungen.
- Halten Sie einen Testdatensatz zurück, den das Modell nie sieht, und geben Sie das Ergebnis dafür an.
