
Relationale Algebra in DBMS mit Beispielen
 Redaktion
⚡ Intelligente Zusammenfassung
Die relationale Algebra in Datenbankmanagementsystemen (DBMS) ist eine prozedurale Abfragesprache, die Relationen als Eingabe nimmt und neue Relationen als Ausgabe erzeugt. Sie gruppiert Operatoren in unäre, Mengen- und binäre Kategorien und bildet damit die theoretische Grundlage, die SQL-Engines in ausführbare Abfragepläne übersetzen.
Was ist relationale Algebra?
Relationale Algebra SQL ist eine prozedurale Abfragesprache, die Instanzen von Relationen als Eingabe akzeptiert und neue Instanzen von Relationen als Ausgabe zurückgibt. Sie wendet einen festen Satz von Operatoren rekursiv auf eine oder mehrere Relationen an, wobei das Ergebnis jedes Operators selbst eine Relation ist, die in die nächste Operation eingespeist werden kann. SQL-Engines nutzen diese Algebra zur Planung und Ausführung von Abfragen.
Grundlegende relationale Algebra Operations
Die Operatoren der relationalen Algebra lassen sich in drei Gruppen einteilen.
Unär relational Operations
- AUSWÄHLEN (σ)
- PROJEKT (π)
- UMBENENNEN (ρ)
OperaKonzepte aus der Mengenlehre
- UNION (∪)
- SCHNITTSTELLE (∩)
- DIFFERENZ (−)
- KARTESISCHES PRODUKT (×)
Binär relational Operations
- JOIN
- DIVISION
In den folgenden Abschnitten werden die einzelnen Operatoren anhand von Beispielen erläutert.
AUSWÄHLEN (σ)
Das SELECT Die Operation wählt eine Teilmenge von Tupeln aus, die ein gegebenes Prädikat erfüllen. Das Sigma-Symbol σ bezeichnet es:
σp(r)woher σ ist der Betreiber, p ist die aussagenlogische Bedingung, und r Die Tabelle ist eine Relation. SELECT erhält das Schema und verwirft Zeilen, die die Bedingung nicht erfüllen.
Beispiel 1
σ topic = "Database" (Tutorials)Wählt Tupel aus aus Tutorials wobei das Thema „Datenbank“ entspricht.
Beispiel 2
σ topic = "Database" AND author = "guru99" (Tutorials)Wählt Tupel aus aus Tutorials wobei das Thema „Datenbank“ lautet und der Autor guru99 ist.
Beispiel 3
σ sales > 50000 (Customers)Wählt Tupel aus aus Kunden deren Umsatzwert über 50,000 liegt.
Projektion (π)
Das Projektion Der Operator entfernt alle Attribute aus der Eingaberelation außer den aufgeführten und erzeugt so eine vertikale Teilmenge. Die Projektion eliminiert außerdem doppelte Zeilen, die durch das Entfernen von Zeilen entstehen.ping Attribute. Das Pi-Symbol π bezeichnet es.
Ejemplo: Betrachten Sie die folgende Tabelle.
| Kundennummer | Kundenname | Status |
|---|---|---|
| 1 | Aktives | |
| 2 | Amazon | Aktives |
| 3 | Apple | Inaktiv |
| 4 | Alibaba | Aktives |
Projektion auf Kundennamen und Status:
π CustomerName, Status (Customers)| Kundenname | Status |
|---|---|
| Aktives | |
| Amazon | Aktives |
| Apple | Inaktiv |
| Alibaba | Aktives |
Umbenennen (ρ)
Das umbenennen Ein Operator ist eine unäre Operation, die einem Attribut (oder einer gesamten Relation) einen neuen Namen gibt. Zum Beispiel: ρ(a/b) R Attribut umbenennen b Beziehung R zu aDie Funktion „Umbenennen“ ist besonders nützlich, wenn Sie eine Selbstverknüpfung durchführen oder zwei Relationen verknüpfen müssen, die gemeinsame Attributnamen haben.
Union Operation (∪)
Das UNION Operator, bezeichnet durch ∪Gibt jedes Tupel zurück, das entweder in Relation A oder in Relation B vorkommt, wobei Duplikate automatisch entfernt werden.
Result ← A ∪ BDamit eine Vereinigung gültig ist:
- A und B müssen die gleiche Anzahl an Attributen (gleiche Stelligkeit) haben.
- Die entsprechenden Attributdomänen müssen kompatibel sein.
- Doppelte Datensätze werden automatisch entfernt.
Beispiel. Betrachten Sie diese beiden Tabellen:
| Tabelle A | Tabelle B | |||
|---|---|---|---|---|
| Spalte 1 | Spalte 2 | Spalte 1 | Spalte 2 | |
| 1 | 1 | 1 | 1 | |
| 1 | 2 | 1 | 3 | |
A ∪ B gibt:
| Spalte 1 | Spalte 2 |
|---|---|
| 1 | 1 |
| 1 | 2 |
| 1 | 3 |
Mengendifferenz (−)
Das Minuszeichen bedeutet Satzdifferenz. Das Ergebnis von A − B ist eine Relation, die alle Tupel enthält, die in A, aber nicht in B enthalten sind.
- A und B müssen verbündungskompatibel sein.
- Attributnamen und Domänen müssen übereinstimmen.
Beispiel: A − B
| Spalte 1 | Spalte 2 |
|---|---|
| 1 | 2 |
Schnittpunkt (∩)
Das Überschneidung Operator, bezeichnet durch ∩, definiert eine Relation, die jedes Tupel enthält, das sowohl in A als auch in B vorkommt. A und B müssen vereinigungskompatibel sein.

Visuelle Definition einer Kreuzung.
Beispiel: A ∩ B
| Spalte 1 | Spalte 2 |
|---|---|
| 1 | 1 |
Kartesisches Produkt (×) in DBMS
Das kartesisches Produkt Die Funktion kombiniert jedes Tupel einer Relation mit jedem Tupel einer anderen und führt deren Spalten zusammen. Alleinstehend ist das Ergebnis selten nützlich, aber in Verbindung mit einem SELECT-Prädikat bildet sie die Grundlage für JOIN. Sie wird auch Kreuzprodukt oder Kreuzverknüpfung genannt.
Beispiel: σ Spalte 2 = '1' (A × B)
Der Ausdruck gibt jede Zeile zurück A × B deren column 2 Wert ist 1.
| Spalte 1 | Spalte 2 |
|---|---|
| 1 | 1 |
| 1 | 1 |
Registrieren Operations
A join ist ein kartesisches Produkt, gefolgt von einem Auswahlprädikat. Joins werden durch das Symbol gekennzeichnet. ⋈ Symbol und ermöglicht es Ihnen, verwandte Tupel aus verschiedenen Relationen auf sinnvolle Weise zu kombinieren.
Join-Typen:
- Innere Verbindungen: Theta join, Equi join, Natural join.
- Äußere Verbindungen: Links-, Rechts- und Full Outer Joins.
Innerer Beitritt
In einem innere VerbindungEs werden nur Tupel berücksichtigt, die die Übereinstimmungskriterien erfüllen; die übrigen werden verworfen.
Theta Join
Die allgemeine Form von JOIN ist die Theta macht mit, bezeichnet mit θ. Der Theta-Join kann beliebige Vergleichsbedingungen in seinen Auswahlkriterien verwenden.
A ⋈θ BBeispielsweise:
A ⋈ A.column 2 > B.column 2 (B)| Spalte 1 | Spalte 2 |
|---|---|
| 1 | 2 |
Gleich beitreten
Wenn ein Theta-Join nur Gleichheitsbedingungen verwendet, wird er zu einem Equi join.
A ⋈ A.column 2 = B.column 2 (B)| Spalte 1 | Spalte 2 |
|---|---|
| 1 | 1 |
Equi-Join ist einer der am häufigsten verwendeten Join-Stile, und der RDBMS Der Abfrageoptimierer investiert typischerweise erhebliche Anstrengungen in dessen Effizienz.
Natürliche Verbindung (⋈)
A Natürliche Verbindung Die Relationen benötigen ein gemeinsames Attribut (eine gemeinsame Spalte). Dieses gemeinsame Attribut muss denselben Namen und dieselbe Domäne haben. Das Ergebnis enthält eine Kopie der übereinstimmenden Spalte.
Betrachten Sie diese beiden Tabellen.
| Tabelle C. | |
|---|---|
| Num | Quadratisch |
| 2 | 4 |
| 3 | 9 |
| Tabelle D. | |
|---|---|
| Num | Würfel |
| 2 | 8 |
| 3 | 27 |
C ⋈ D produziert:
| Num | Quadratisch | Würfel |
|---|---|---|
| 2 | 4 | 8 |
| 3 | 9 | 27 |
Äußere Verbindung
An äußere Verbindung speichert Tupel, die die Übereinstimmungskriterien erfüllen. und Tupel, die dies nicht tun, füllen fehlende Spalten mit NULL auf.
Linker äußerer Join (A ⟕ B)
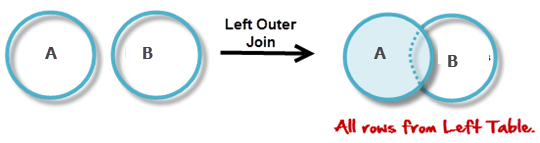
Der linke äußere Join behält alle Tupel der linken Relation bei. Wenn eine Zeile in A keine entsprechende Zeile in B hat, werden die von B beigesteuerten Attribute mit NULL aufgefüllt.
Betrachten Sie die folgenden Tabellen:
| Tabelle A | |
|---|---|
| Num | Quadratisch |
| 2 | 4 |
| 3 | 9 |
| 4 | 16 |
| Tabelle B | |
|---|---|
| Num | Würfel |
| 2 | 8 |
| 3 | 18 |
| 5 | 75 |
A ⟕ B gibt:
| Num | Quadratisch | Würfel |
|---|---|---|
| 2 | 4 | 8 |
| 3 | 9 | 18 |
| 4 | 16 | NULL |
Right Outer Join (A ⟖ B)
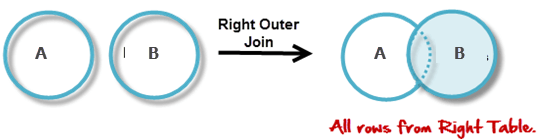
Der rechte äußere Join sorgt dafür, dass jedes Tupel in der richtigen Relation verbleibt. Wenn eine Zeile in B keine entsprechende Zeile in A hat, werden die von A beigesteuerten Spalten mit NULL aufgefüllt.
A ⟖ B gibt:
| Num | Würfel | Quadratisch |
|---|---|---|
| 2 | 8 | 4 |
| 3 | 18 | 9 |
| 5 | 75 | NULL |
Vollständiger äußerer Join (A ⟗ B)
Der vollständige äußere Join behält alle Tupel beider Relationen bei, unabhängig davon, ob die Join-Bedingung erfüllt war. Fehlende Werte auf beiden Seiten werden zu NULL.
A ⟗ B gibt:
| Num | Quadratisch | Würfel |
|---|---|---|
| 2 | 4 | 8 |
| 3 | 9 | 18 |
| 4 | 16 | NULL |
| 5 | NULL | 75 |
Operator Referenzübersicht
Anhand dieser Referenztabelle können Sie sich auf einen Blick merken, was jeder Operator bewirkt.
| Operation (Symbol) | Zweck |
|---|---|
| AUSWÄHLEN (σ) | Wählt eine Teilmenge von Tupeln aus, die ein gegebenes Prädikat erfüllen. |
| PROJEKT (π) | Es werden nur die aufgeführten Attribute beibehalten und doppelte Zeilen entfernt. |
| UNION (∪) | Gibt alle Tupel zurück, die entweder in A oder in B vorkommen, ohne Duplikate. |
| SET DIFFERENZ (−) | Gibt Tupel aus A zurück, die nicht in B enthalten sind. |
| SCHNITTSTELLE (∩) | Gibt Tupel zurück, die sowohl in A als auch in B vorkommen. |
| KARTESISCHES PRODUKT (×) | Kombiniert jedes Tupel von A mit jedem Tupel von B. |
| INNER JOIN | Es werden nur Tupel beibehalten, die der Join-Bedingung entsprechen. |
| THETA JOIN (θ) | Join in allgemeiner Form mit beliebigem Vergleichsprädikat. |
| EQUI JOIN | Theta-Join, der nur Gleichheitsvergleiche verwendet. |
| NATÜRLICHE VERBINDUNG (⋈) | Verknüpft Beziehungen über Attribute, die denselben Namen und dieselbe Domäne haben. |
| LEFT OUTER JOIN (⟕) | Behält alle Tupel der linken Relation bei und füllt die rechte mit NULL auf. |
| RIGHT OUTER JOIN (⟖) | Behält alle Tupel der rechten Relation bei und füllt die linke mit NULL auf. |
| VOLLSTÄNDIGER ÄUSSERER VERBINDUNGSSCHLUSS (⟗) | Behält jedes Tupel aus beiden Relationen bei und füllt fehlende Werte mit NULL auf. |
