
Relationales Datenmodell in DBMS: Concepts & Beispiel
 Redaktion
⚡ Intelligente Zusammenfassung
Das relationale Modell stellt eine Datenbank als eine Sammlung von Relationen dar, wobei jede Relation eine Tabelle mit Zeilen und Spalten ist. Es definiert Kernkonzepte, Integritätsbedingungen und Aktualisierungsoperationen, die die Konsistenz der relationalen Daten gewährleisten und deren Abfrage vereinfachen.
Was ist das relationale Modell?
Relationales Modell (RM) stellt die Datenbank als eine Sammlung von Beziehungen dar. Eine Relation ist nichts anderes als eine Wertetabelle. Jede Zeile in der Tabelle stellt eine Sammlung zusammengehöriger Datenwerte dar. Diese Zeilen in der Tabelle bezeichnen eine reale Entität oder Beziehung.
Tabellen- und Spaltennamen helfen, die Bedeutung der Werte in jeder Zeile zu interpretieren. Die Daten werden als Menge von Relationen dargestellt. Im relationalen Modell werden Daten als Tabellen gespeichert. Die physische Speicherung der Daten ist jedoch unabhängig von ihrer logischen Organisation.
Das Modell wurde 1970 von EF Codd vorgeschlagen und bildet bis heute die Grundlage fast aller gängigen Datenbanken. Einige gängige relationale Datenbankmanagementsysteme sind:
- DB2 und Informix Dynamic Server – IBM
- Oracle und RDB – Oracle
- SQL Server und Zugriff – Microsoft
Relationales Modell Concepts im DBMS
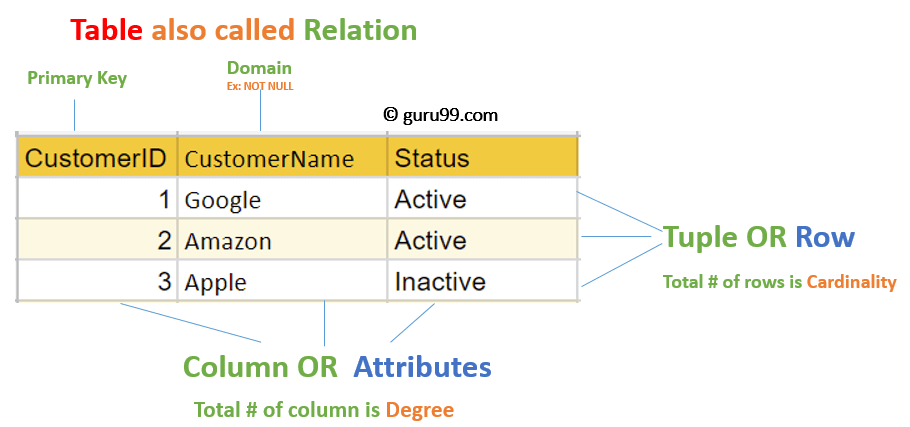
- Attribut: Jede Spalte einer Tabelle. Attribute sind die Eigenschaften, die eine Beziehung definieren, z. B. Matrikelnummer, Name usw.
- Tabellen: Im relationalen Modell werden Relationen in Tabellenform gespeichert. Sie werden zusammen mit ihren Entitäten abgelegt. Eine Tabelle besitzt zwei Eigenschaften: Zeilen und Spalten. Zeilen repräsentieren Datensätze und Spalten Attribute.
- Tupel: Es handelt sich lediglich um eine einzelne Zeile einer Tabelle, die einen einzelnen Datensatz enthält.
- Beziehungsschema: Ein Relationsschema repräsentiert den Namen der Relation mit ihren Attributen.
- Abschluss: Die Gesamtzahl der Attribute in der Relation wird als Grad der Relation bezeichnet.
- Kardinalität: Die Gesamtzahl der Zeilen in der Tabelle.
- Säule: Die Spalte stellt den Wertesatz für ein bestimmtes Attribut dar.
- Beziehungsinstanz: Eine Relationsinstanz ist eine endliche Menge von Tupeln in einem relationalen Datenbankmanagementsystem. Relationsinstanzen enthalten niemals doppelte Tupel.
- Beziehungsschlüssel: Jede Zeile hat ein, zwei oder mehrere Attribute, die als Beziehungsschlüssel bezeichnet werden.
- Attributdomäne: Jedes Attribut hat einen vordefinierten Wert und einen vordefinierten Gültigkeitsbereich, der als Attributdomäne bezeichnet wird.
Nachdem der Wortschatz vorhanden ist, besteht die nächste Herausforderung darin, ihn beizubehalten.ping Die Daten in diesen Relationen müssen gültig sein; dies ist die Aufgabe von Integritätsbedingungen.
Relational Integrity Einschränkungen
Relationale Integritätsbedingungen in Datenbankmanagementsystemen (DBMS) bezeichnen Bedingungen, die für eine gültige Relation erfüllt sein müssen. Diese relationalen Bedingungen werden aus den Regeln der Miniwelt abgeleitet, die die Datenbank repräsentiert.
Es gibt viele Arten von Integritätsbedingungen. Die Bedingungen für relationale Datenbankmanagementsysteme lassen sich hauptsächlich in drei Kategorien unterteilen:
- Domäneneinschränkungen
- Wichtige Einschränkungen
- Referent Integrity Einschränkungen
Domäneneinschränkungen
Domänenbeschränkungen können verletzt werden, wenn ein Attributwert nicht in der entsprechenden Domäne vorkommt oder wenn er nicht den passenden Datentyp hat.
Domänenbeschränkungen legen fest, dass innerhalb jedes Tupels der Wert jedes Attributs atomar sein und aus der korrekten Domäne stammen muss. Domänen werden als Datentypen definiert, darunter Standardtypen wie ganze Zahlen, reelle Zahlen, Zeichen, boolesche Werte und Zeichenketten variabler Länge.
Ejemplo:
CREATE DOMAIN CustomerName
CHECK (value NOT NULL)
Das gezeigte Beispiel veranschaulicht die Erstellung einer Domänenbeschränkung, sodass CustomerName nicht NULL ist.
Wichtige Einschränkungen
Ein Attribut, das ein Tupel in einer Beziehung eindeutig identifizieren kann, wird als Schlüssel der Tabelle bezeichnet. Der Wert des Attributs für verschiedene Tupel in der Beziehung muss eindeutig sein.
Ejemplo:
In der gegebenen Tabelle ist CustomerID ein Schlüsselattribut der Kundentabelle. Es gibt höchstwahrscheinlich genau einen Schlüssel für jeden Kunden; CustomerID = 1 gilt nur für den Kundennamen „CustomerName“.GoogleEine ausführliche Beschreibung der verschiedenen Schlüsseltypen findet sich im Leitfaden zu DBMS-Schlüssel.
| Kundennummer | Kundenname | Status |
|---|---|---|
| 1 | Aktives | |
| 2 | Amazon | Aktives |
| 3 | Apple | Inaktiv |
Referent Integrity Einschränkungen
Referenzielle Integritätsbedingungen in Datenbankmanagementsystemen basieren auf dem Konzept von Fremdschlüsseln. Ein Fremdschlüssel ist ein wichtiges Attribut einer Relation, auf das in anderen Relationen verwiesen werden muss. Eine referenzielle Integritätsbedingung liegt vor, wenn eine Relation auf ein Schlüsselattribut einer anderen oder derselben Relation verweist. Dieses Schlüsselelement muss in der referenzierten Tabelle vorhanden sein.
Ejemplo:

Im obigen Beispiel haben wir zwei Relationen, Kunde und Billing.
Das Tupel für CustomerID = 1 wird in der Relation zweimal referenziert. BillWir kennen also den Kundennamen.Google„hat einen Rechnungsbetrag von 300 Dollar.“
Operationen im relationalen Modell
Im relationalen Datenbankmodell werden vier grundlegende Aktualisierungsoperationen durchgeführt: Einfügen, Aktualisieren, Löschen und Auswählen.
- Mit der Funktion „Insert“ werden Daten in die Relation eingefügt.
- Mit „Delete“ werden Tupel aus der Tabelle gelöscht.
- Mit „Ändern“ können Sie die Werte einiger Attribute in vorhandenen Tupeln ändern.
- Mit „Auswählen“ können Sie einen bestimmten Datenbereich auswählen.
Bei jeder Anwendung einer dieser Operationen dürfen die für das relationale Datenbankschema festgelegten Integritätsbedingungen keinesfalls verletzt werden.
Insert OperaProduktion
Die Einfügeoperation liefert die Werte der Attribute für ein neues Tupel, das in eine Relation eingefügt werden soll.

Update OperaProduktion
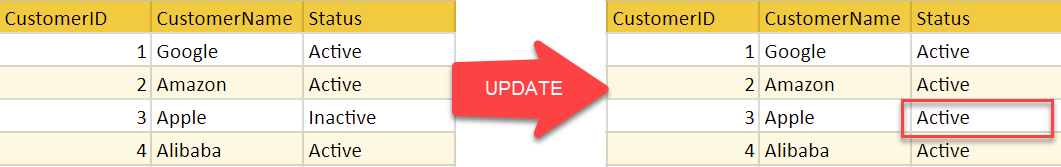
Sie können in der untenstehenden Beziehungstabelle sehen, dass der Kundenname 'Apple' von Inaktiv auf Aktiv aktualisiert wurde.
Löschen OperaProduktion
Um das Löschen anzugeben, wählt eine Bedingung für die Attribute der Beziehung das zu löschende Tupel aus.

Im obigen Beispiel wird der Kundenname „Apple“ aus der Tabelle gelöscht.
Der Löschvorgang könnte die referenzielle Integrität verletzen, wenn das zu löschende Tupel von Fremdschlüsseln anderer Tupel im selben Datensatz referenziert wird. Datenbank.
Auswählen OperaProduktion

Im obigen Beispiel ist CustomerName „Amazon" ist ausgewählt.
Relationales Modell vs. hierarchische und Netzwerkmodelle
Das relationale Modell ersetzte zwei frühere Ansätze, und der Kontrast erklärt, warum es sich durchsetzte. Die folgende Tabelle vergleicht die drei Ansätze.
| Aspekt | Relationales Modell | Hierarchisches Modell | Netzwerkmodell |
|---|---|---|---|
| Struktur | Tabellen (Relationen) | Baumstruktur, Eltern-Kind-Zustand | Graph, viele zu vielen |
| Datenzugriff | Deklarativ, per Wert | Navigation, nach Weg | Navigation, per Zeiger |
| Beziehungen | Fremde Schlüssel | Eltern-Kind-Verbindungen | Mengen und Zeiger |
| Abfragesprache | SQL | Verfahrensordnung | Verfahrensordnung |
| Flexibilität | Hoch | Niedrig | Medium |
Da das relationale Modell Daten anhand ihres Wertes und nicht durch die Navigation physischer Verbindungen adressiert, ist eine höhere Programmiersprache wie SQL kann eine Anfrage formulieren, ohne zu wissen, wie die Daten gespeichert sind.
Best Practices für die Erstellung eines relationalen Modells
- Daten müssen als eine Sammlung von Relationen dargestellt werden.
- Jede Beziehung sollte in der Tabelle klar dargestellt werden.
- Die Zeilen sollten Daten über Instanzen einer Entität enthalten.
- Die Spalten müssen Daten über Attribute der Entität enthalten.
- Die Zellen der Tabelle sollten jeweils einen einzelnen Wert enthalten.
- Jeder Spalte sollte ein eindeutiger Name gegeben werden.
- Keine zwei Reihen können identisch sein.
- Die Werte eines Attributs sollten aus derselben Domäne stammen.
Vorteile des relationalen Datenbankmodells
- Einfachheit: Ein relationales Datenmodell in einem DBMS ist einfacher als die hierarchischen und Netzwerkmodelle.
- Strukturelle Unabhängigkeit: Die relationale Datenbank befasst sich ausschließlich mit Daten und nicht mit deren Struktur, was die Leistungsfähigkeit des Modells verbessern kann.
- Einfach zu verwenden: Das relationale Modell ist einfach anzuwenden, da Tabellen, die aus Zeilen und Spalten bestehen, natürlich und leicht verständlich sind.
- Abfragefunktion: Dadurch wird es einer Abfragesprache auf höherer Ebene wie SQL ermöglicht, komplexe Datenbanknavigationen zu vermeiden.
- Datenunabhängigkeit: Die Struktur einer relationalen Datenbank kann geändert werden, ohne dass Änderungen an der Anwendung erforderlich sind.
- Skalierbar: Hinsichtlich der Anzahl der Datensätze bzw. Zeilen und der Anzahl der Felder kann eine Datenbank vergrößert werden, um ihre Benutzerfreundlichkeit zu verbessern.
Nachteile des relationalen Modells
- Nur wenige relationale Datenbanken haben Beschränkungen hinsichtlich der Feldlänge, die nicht überschritten werden dürfen.
- Relationale Datenbanken können mitunter komplex werden, wenn die Datenmenge wächst und die Beziehungen zwischen den Datenelementen komplizierter werden.
- Komplexe relationale Datenbanksysteme können zu isolierten Datenbanken führen, in denen Informationen nicht zwischen den Systemen ausgetauscht werden können.
