
Was ist Reinforcement Learning? Arten, Algorithms & Beispiel
 Redaktion
⚡ Intelligente Zusammenfassung
Reinforcement Learning ist eine Methode des maschinellen Lernens, bei der ein Softwareagent lernt, indem er in einer Umgebung agiert, Belohnungen oder Strafen sammelt und sein Verhalten anpasst, um die kumulative Belohnung über viele Schritte hinweg zu maximieren.
Was ist Reinforcement Learning?
Verstärkung lernen ist eine Maschinelles lernen Die Methode befasst sich damit, wie Softwareagenten in einer Umgebung agieren sollen. Dem Agenten werden keine korrekten Antworten angezeigt; er lernt aus den erhaltenen Belohnungen und passt sein Verhalten an, um die Gesamtbelohnung zu maximieren.
Reinforcement Learning ist ein eigenständiger Zweig des maschinellen Lernens, neben Aufsicht und unbeaufsichtigt Lernen. Wenn die Strategie oder Wertfunktion des Agenten durch ein neuronales Netzwerk dargestellt wird, nennt man diese Kombination Lernen. tiefes Lernen der Verstärkung — Diese Paarung ermöglicht es einem Akteur, ein komplexes Ziel zu erreichen oder eine bestimmte Dimension über viele Schritte hinweg zu maximieren.
Wichtige Komponenten der Reinforcement-Learning-Methode
Bevor die Algorithmen verständlich werden, ist es hilfreich, die einzelnen Bestandteile zu benennen. Das folgende Diagramm veranschaulicht, wie Agent, Umgebung, Aktion und Belohnungssignal in einer Schleife zusammenwirken.
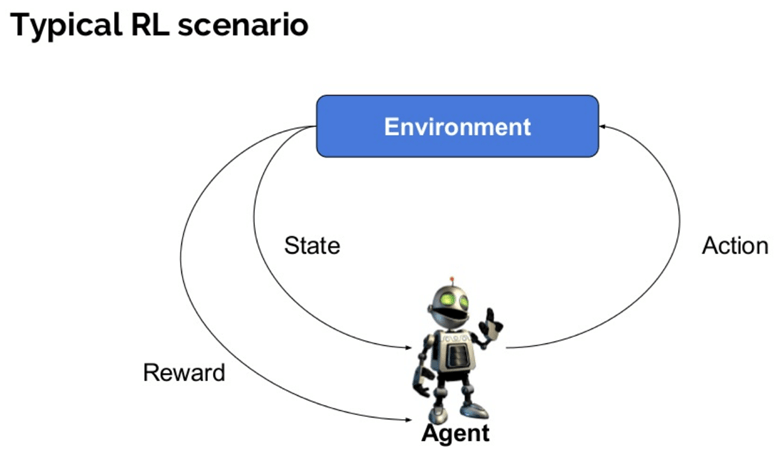
Hier sind einige wichtige Begriffe, die im Reinforcement Learning verwendet werden:
- Agenten: Die Entität, die in einer Umgebung Handlungen ausführt, um eine Belohnung zu erhalten.
- Umgebung (e): Ein Szenario, dem sich ein Agent stellen muss.
- Belohnung (R): Eine sofortige Gegenleistung, die einem Agenten nach Ausführung einer bestimmten Handlung oder Aufgabe zuteilwird.
- Zustände): Der Zustand bezieht sich auf die aktuelle Situation, die von der Umgebung zurückgegeben wird.
- Richtlinie (π): Die Strategie, die der Agent anwendet, um auf Grundlage des aktuellen Zustands die nächste Aktion festzulegen.
- Wert (V): Die erwartete langfristige Rendite mit Abschlag im Vergleich zur kurzfristigen Rendite.
- Wertfunktion: Es legt den Wert eines Zustands fest, also die Gesamtsumme der Belohnung, die ein Agent ausgehend von diesem Zustand erwarten kann.
- Modell der Umgebung: Dadurch wird das Verhalten der Umgebung nachgeahmt. Es ermöglicht Ihnen, Schlussfolgerungen zu ziehen und auch vorherzusagen, wie sich die Umgebung verhalten wird.
- Modellbasierte Methoden: Methoden, die Probleme des bestärkenden Lernens lösen, indem sie zunächst ein Modell der Umgebung lernen oder verwenden und dann dagegen planen.
- Q-Wert oder Aktionswert (Q): Der Q-Wert ist dem Wert sehr ähnlich. Der einzige Unterschied zwischen den beiden besteht darin, dass er einen zusätzlichen Parameter benötigt, die aktuelle Aktion.
Wie funktioniert Reinforcement Learning?
Eine alltägliche Analogie verdeutlicht den Mechanismus, noch bevor irgendeine Notation erscheint.
Stellen Sie sich vor, Sie möchten Ihrer Katze neue Tricks beibringen.
- Da die Katze weder Englisch noch eine andere menschliche Sprache versteht, können wir ihr nicht direkt sagen, was sie tun soll. Stattdessen verfolgen wir eine andere Strategie.
- Wir stellen eine Situation nach, und die Katze versucht, auf verschiedene Weise darauf zu reagieren. Wenn die Reaktion der Katze die gewünschte ist, geben wir ihr Fisch.
- Immer wenn die Katze nun mit der gleichen Situation konfrontiert wird, führt sie eine ähnliche Handlung noch enthusiastischer aus, in der Erwartung, eine größere Belohnung (Futter) zu erhalten.
- Das ist das Lernen, das die Katze aus positiven Erfahrungen darüber gewinnt, „was zu tun ist“.
- Gleichzeitig lernt die Katze aber auch, was sie bei negativen Erfahrungen nicht tun sollte.
Beispiel für Reinforcement Learning
Die untenstehende Abbildung überträgt diese Katzengeschichte auf den formalen Kreislauf, wobei der Haushalt die Umgebung und der Fisch die Belohnung darstellt.
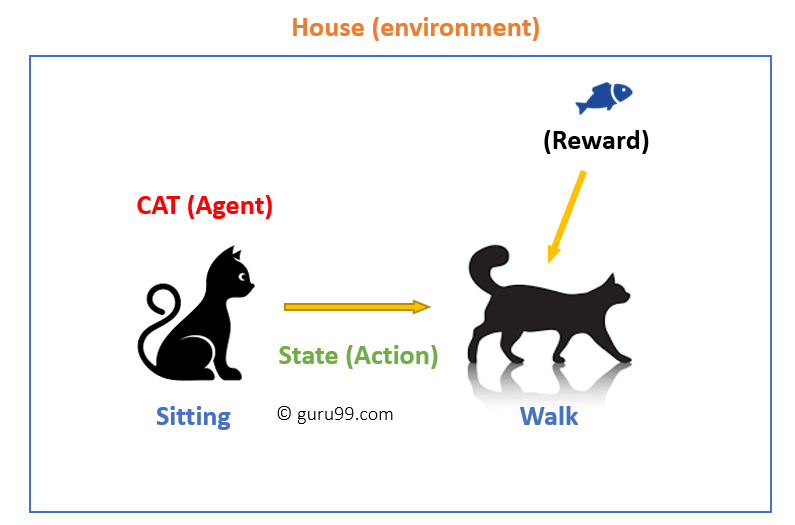
In diesem Fall steht:
- Ihre Katze ist ein Faktor, der mit der Umgebung interagiert. In diesem Fall ist es Ihr Haus. Ein Beispiel für einen solchen Zustand wäre, wenn Ihre Katze sitzt und Sie ein bestimmtes Wort verwenden, um sie zum Laufen zu animieren.
- Unser Agent reagiert, indem er einen Aktionsübergang von einem „Zustand“ in einen anderen „Zustand“ durchführt.
- Beispielsweise wechselt Ihre Katze vom Sitzen zum Gehen.
- Die Reaktion eines Agenten ist eine Aktion, und die Richtlinie ist eine Methode zur Auswahl einer Aktion in einem gegebenen Zustand in Erwartung besserer Ergebnisse.
- Nach dem Übergang kann der Agent im Gegenzug eine Belohnung oder eine Strafe erhalten.
Verstärkung lernen Algorithms
Es gibt drei Ansätze zur Implementierung eines Reinforcement-Learning-Algorithmus, die sich hauptsächlich darin unterscheiden, was der Agent speichert und lernt.
Wertebasiert
Bei einem wertbasierten Reinforcement-Learning-Verfahren wird versucht, eine Wertfunktion V(s) zu maximieren. In diesem Verfahren erwartet der Agent langfristig den Erhalt der aktuellen Zustände gemäß der Strategie π.
Richtlinienbasiert
Bei einer richtlinienbasierten RL-Methode versucht man, eine Strategie zu entwickeln, bei der die in jedem Zustand durchgeführte Aktion dazu beiträgt, in Zukunft die maximale Belohnung zu erzielen.
Es gibt zwei Arten richtlinienbasierter Methoden:
- Deterministisch: Für jeden Zustand wird durch die Politik π die gleiche Aktion erzeugt.
- Stochastisch: Jeder Aktion ist eine bestimmte Wahrscheinlichkeit zugeordnet, die durch die folgende Gleichung gegeben ist.
Stochastische Politik:
π(a|s) = P[At = a | St = s]
Modellbasiert
Bei dieser Methode des bestärkenden Lernens wird für jede Umgebung ein virtuelles Modell erstellt. Der Agent lernt dann, sich in dieser spezifischen Umgebung zu verhalten.
Merkmale des Reinforcement Learning
Hier sind wichtige Merkmale des bestärkenden Lernens:
- Es gibt keinen Vorgesetzten, nur eine echte Zahl oder ein Belohnungssignal
- Sequentielle Entscheidungsfindung
- Zeit spielt bei Verstärkungsproblemen eine entscheidende Rolle
- Das Feedback erfolgt oft verzögert statt unmittelbar.
- Die Aktionen des Agenten bestimmen die nachfolgenden Daten, die er empfängt
Arten von Reinforcement Learning
Der Begriff „Verstärkung“ stammt aus der Verhaltenspsychologie und tritt in zwei Formen auf:
Positiv:
Es handelt sich um ein Ereignis, das aufgrund eines bestimmten Verhaltens eintritt. Es verstärkt und erhöht die Häufigkeit dieses Verhaltens und wirkt sich positiv auf die Handlungen des Akteurs aus.
Diese Art der Verstärkung hilft Ihnen, die Leistung zu maximieren und Veränderungen längerfristig aufrechtzuerhalten. Zu viel Verstärkung kann jedoch zu einer Überoptimierung des Zustands führen, was die Ergebnisse beeinträchtigen kann.
Negativ:
Negative Verstärkung bezeichnet die Verstärkung eines Verhaltens, das aufgrund einer negativen Situation auftritt, die eigentlich hätte verhindert oder vermieden werden sollen. Sie hilft dabei, einen Mindeststandard für Leistung festzulegen. Der Nachteil dieser Methode besteht jedoch darin, dass sie lediglich ausreichend Verstärkung bietet, um dieses Mindestverhalten zu erreichen.
Lernmodelle der Verstärkung
Beim Reinforcement Learning gibt es zwei wichtige Lernmodelle:
- Markov-Entscheidungsprozess
- Q Lernen
Markov-Entscheidungsprozess
Um eine Lösung zu erhalten, werden die folgenden Parameter verwendet:
- Handlungsabfolge – A
- Zustandsmenge – S
- Belohnung – R
- Richtlinie – π
- Wert – V
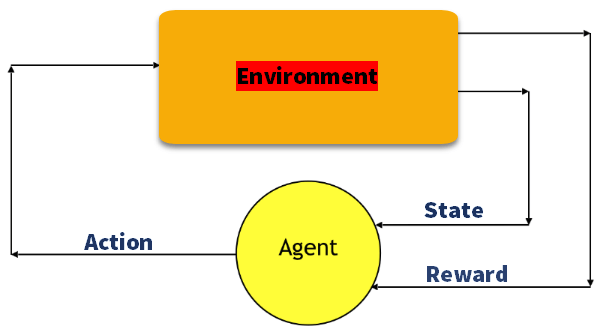
Der mathematische Ansatz für die Karteping Eine Lösung im Reinforcement Learning wird als Markov-Entscheidungsprozess (MDP) formalisiert. Das folgende Schema zeigt, wie diese fünf Parameter in denselben Agenten-Umgebungs-Zyklus eingebunden sind.
Q-Learning
Q-Learning ist eine wertbasierte Methode zur Bereitstellung von Informationen, die einem Agenten mitteilen, welche Aktion er ausführen soll.
Lassen Sie uns diese Methode anhand des folgenden Beispiels verstehen:
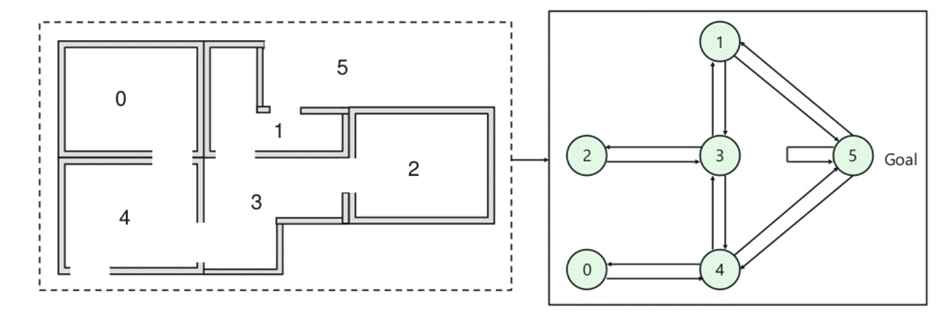
- In einem Gebäude gibt es fünf Räume, die durch Türen miteinander verbunden sind.
- Die Räume sind von 0 bis 4 nummeriert.
- Der Außenbereich des Gebäudes kann als eine große Außenfläche betrachtet werden (5).
- Die Türen Nr. 1 und 4 führen von Raum 5 in das Gebäude
Im untenstehenden Grundriss sind die Räume nummeriert und die Verbindungstüren sind eingezeichnet.
Als Nächstes müssen Sie jeder Tür einen Belohnungswert zuordnen:
- Türen, die direkt zum Ziel führen, haben eine Belohnung von 100
- Türen, die nicht direkt mit dem Zielraum verbunden sind, bringen keine Belohnung.
- Da die Türen in beide Richtungen geöffnet werden können, sind jedem Raum zwei Pfeile zugeordnet.
- Jeder Pfeil im obigen Bild repräsentiert einen sofortigen Belohnungswert.
Erläuterung: In dieser Abbildung repräsentiert jeder Raum einen Zustand, und die Bewegung des Agenten von einem Raum zum anderen stellt eine Handlung dar.
Im folgenden Diagramm ist ein Zustand als Knoten dargestellt, während die Pfeile die verfügbaren Aktionen und die jeweils damit verbundene Belohnung zeigen.

Ein Agent durchläuft beispielsweise die Räume 2 bis 5:
- Ausgangszustand = Zustand 2
- Zustand 2 -> Zustand 3
- Zustand 3 -> Zustand (2,1,4)
- Zustand 4-> Zustand (0,5,3)
- Zustand 1-> Zustand (5,3)
- Zustand 0 -> Zustand 4
Reinforcement Learning vs. Supervised Learning
Am besten lässt sich Reinforcement Learning einordnen, indem man es neben das Paradigma stellt, das den meisten Lesern bereits bekannt ist.
| Kenngrößen | Verstärkung lernen | Überwachtes Lernen |
|---|---|---|
| Entscheidungsstil | Reinforcement Learning hilft Ihnen dabei, Ihre Entscheidungen schrittweise zu treffen. | Bei dieser Methode wird eine Entscheidung anhand der zu Beginn gegebenen Eingaben getroffen. |
| Funktioniert auf | Funktioniert durch Interaktion mit der Umgebung. | Arbeitet anhand von Beispielen oder gegebenen Beispieldaten. |
| Abhängigkeit von der Entscheidung | Bei der RL-Methode hängt jede Lernentscheidung von den vorhergehenden Entscheidungen ab, sodass die gesamte Entscheidungssequenz bewertet wird. | In überwachtes Lernen Die Entscheidungen sind voneinander unabhängig, daher wird jeder Entscheidung ein Etikett zugeordnet. |
| am besten geeignet | Unterstützt und funktioniert besser in KI-Umgebungen, wo menschliche Interaktion vorherrscht. | Die Bedienung erfolgt meist über interaktive Softwaresysteme oder Anwendungen. |
| Beispiel | Schachspiel | Objekterkennung |
Anwendungen des Reinforcement Learning
Hier sind Anwendungen des Reinforcement Learning:
- Robotik für die industrielle Automatisierung.
- Planung der Geschäftsstrategie
- Maschinelles Lernen und Datenverarbeitung
- Es hilft Ihnen dabei, Trainingssysteme zu erstellen, die maßgeschneiderte Anleitungen und Materialien entsprechend den Bedürfnissen der Schüler bereitstellen.
- Flugzeugsteuerung und Roboterbewegungssteuerung
Warum Reinforcement Learning nutzen?
Hier sind die Hauptgründe für den Einsatz von Reinforcement Learning:
- Es hilft Ihnen dabei, herauszufinden, in welcher Situation Handlungsbedarf besteht.
- Hilft Ihnen dabei, herauszufinden, welche Maßnahme langfristig den höchsten Nutzen bringt.
- Reinforcement Learning stellt dem Lernagenten auch eine Belohnungsfunktion zur Verfügung.
- Es ermöglicht dem Agenten außerdem, die beste Methode zur Erzielung hoher Belohnungen zu ermitteln.
Wann sollte Reinforcement Learning nicht eingesetzt werden?
Ein Reinforcement-Learning-Modell lässt sich nicht in jeder Situation anwenden. Hier sind einige Bedingungen, unter denen Sie es nicht verwenden sollten.
- Wenn Sie über genügend gekennzeichnete Daten verfügen, um das Problem mit einer überwachten Lernmethode zu lösen
- Reinforcement Learning ist rechenintensiv und zeitaufwändig, insbesondere wenn der Aktionsraum groß ist.
Herausforderungen des Reinforcement Learning
Hier sind die wichtigsten Herausforderungen, denen Sie beim Reinforcement Learning begegnen werden:
- Feature- und Belohnungsdesign, das sehr aufwändig sein kann
- Parameter können die Lerngeschwindigkeit beeinflussen.
- Realistische Umgebungen können teilweise beobachtbar sein.
- Zu viel Verstärkung kann zu einer Überlastung der Zustände führen, was die Ergebnisse mindern kann.
- Realistische Umgebungen können instationär sein.
