
Adjazenzliste und Matrixdarstellung des Diagramms
 Sarah Chen
⚡ Intelligente Zusammenfassung
Adjazenzlisten und Adjazenzmatrizen speichern Knoten und Kanten im Speicher und ermöglichen so das Durchlaufen von Netzwerken. Adjazenzlisten verwenden verkettete Listen pro Knoten, während Adjazenzmatrizen ein quadratisches zweidimensionales Gitter nutzen.
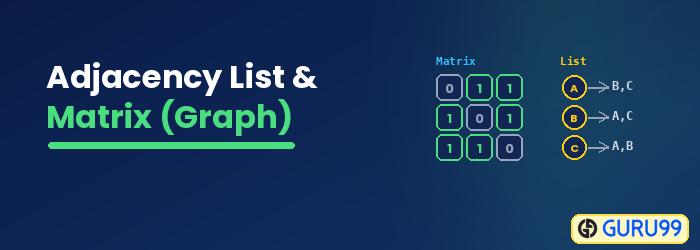
Auch wenn sie alle unterschiedlich aussehen Arten von Diagrammen kann auf ähnliche Weise dargestellt werden. Es gibt im Allgemeinen zwei Arten der grafischen Darstellung:
- Adjazenzmatrix
- Adjazenzliste
Adjazenzliste
Eine Adjazenzliste besteht aus verketteten Listen. Jeder Knoten wird als Array-Index betrachtet, und jedes Element repräsentiert eine verkettete Liste. Diese verketteten Listen enthalten die Knoten, die eine Kante mit dem Indexknoten gemeinsam haben.
Hier ist ein Beispiel für eine Adjazenzliste:

Gegeben sei ein Graph mit V Knoten und E Kanten. Die Speicherkomplexität der Adjazenzliste beträgt O(V + E), das mit der Anzahl der tatsächlichen Kanten skaliert und nicht mit jedem möglichen Paar von Knoten.
Die Speicherkomplexität im ungünstigsten Fall wird O(V²) Wenn der gegebene Graph ein vollständiger Graph ist, dann ist jeder Knoten mit jedem anderen Knoten verbunden.
Adjazenzmatrix
Eine Adjazenzmatrix besteht aus einem zweidimensionalen Array. Für einen Graphen mit V Knoten beträgt die Größe der Matrix V × V.
Sagen matrix[i][j] = 5Das bedeutet, dass es eine Kante zwischen Knoten i und Knoten j gibt, deren Gewicht 5 beträgt.
Betrachten wir den folgenden Graphen und seine Adjazenzmatrix:

Wir haben das gebaut 2D-Array mit diesen Schritten:
Schritt 1) Knoten A hat eine direkte Kante zu B, und das Gewicht beträgt 5. Daher wird die Zelle in Zeile A und Spalte B mit 5 gefüllt. Die restlichen Zellen in Zeile A werden mit Null gefüllt.
Schritt 2) Knoten B hat eine direkte Kante zu C, und die Kante hat das Gewicht 4. Daher wird die Zelle in Zeile B und Spalte C mit 4 gefüllt. Die restlichen Zellen in Zeile B werden mit Null gefüllt, da B keine ausgehende Kante zu einem anderen Knoten hat.
Schritt 3) Knoten C hat keine direkten Kanten zu anderen Knoten. Daher wird Zeile C mit Nullen gefüllt.
Schritt 4) Knoten D besitzt eine gerichtete Kante mit A und C.
- Die Zelle in Zeile D und Spalte A hat den Wert 7. Die Zelle in Zeile D und Spalte C hat den Wert 2.
- Die restlichen Zellen in Zeile D werden mit Nullen gefüllt.
Schritt 5) Knoten E hat eine gerichtete Kante mit B und D. Die Zelle in Zeile E und Spalte B hat den Wert 6. Die Zelle in Zeile E und Spalte D hat den Wert 3. Die restlichen Zellen in Zeile E werden mit Nullen aufgefüllt.
Hier sind einige Punkte, die Sie beachten sollten:
- Der Graph hat keine Selbstschleifen, wenn die Hauptdiagonale der Adjazenzmatrix 0 ist.
- Ein Graph ist gerichtet, wenn die Zellen an den Stellen (a, b) und (b, a) nicht denselben Wert haben. Andernfalls ist der Graph ungerichtet.
- Es handelt sich um einen gewichteten Graphen, wenn der Wert einer beliebigen Zelle größer als 1 ist.
Das Hauptproblem der Adjazenzmatrix besteht darin, dass sie quadratischen Speicherplatz benötigt. Selbst nicht existierende Kanten belegen Speicherzellen.
Wenn wir beispielsweise einen Graphen mit 100 Knoten haben, benötigen wir 10,000 Zellen, um ihn zu speichern. RAMBei weniger Kanten im Graphen kann die Zuweisung so großen Speicherplatzes ineffizient sein. Daher beträgt die Speicherkomplexität unter Verwendung der Adjazenzmatrix O(N²), wobei N die Anzahl der Knoten im Graphen ist.
Adjazenzliste vs. Adjazenzmatrix
Vor der Auswahl einer Darstellungsform ist es hilfreich, beide Modelle anhand der Operationen, die bei realen Graph-Workloads dominieren, direkt miteinander zu vergleichen:
| Produktion | Adjazenzmatrix | Adjazenzliste |
|---|---|---|
| Raumkomplexität | O(V²) | O(V + E) |
| Fügen Sie einen Scheitelpunkt hinzu | O(V²) | O (1) |
| Füge eine Kante hinzu | O (1) | O (1) |
| Eine Kante entfernen | O (1) | O(E) |
| Prüfen Sie, ob die Kante (i, j) existiert | O (1) | O(Grad von i) |
| Iteriere über die Nachbarn von i | O (V) | O(Grad von i) |
| am besten für | Dichte Graphen, häufige Kantenabfragen | Dünnbesetzte Graphen, traversierungsintensive Aufgaben |
Kurz gesagt, die Adjazenzmatrix ist bei Kantenzugriffen mit konstanter Zeit im Vorteil, während die Adjazenzliste bei Speicherbedarf und Nachbariteration punktet. Aus diesem Grund werden Algorithmen wie BFS, DFS und Dijkstra üblicherweise mit Adjazenzlisten kombiniert.
Vor- und Nachteile der Graphdarstellung
Jede Darstellungsform hat ihre Vor- und Nachteile. Kennt man die Stärken und Schwächen beider Modelle, kann man das richtige für das jeweilige Problem auswählen.
Vorteile der Adjazenzmatrix:
- Kantenexistenzabfragen mit konstanter Laufzeit O(1) zwischen beliebigen Knotenpaaren.
- Die feste Indizierung erleichtert die Implementierung matrixbasierter Algorithmen wie Floyd-Warshall und transitiver Hülle.
- Gewichtete Kanten passen natürlich in eine einzelne Matrixzelle.
Nachteile der Adjazenzmatrix:
- Verschwendet O(V²) Speicherplatz, wenn der Graph dünn besetzt ist.
- Das Hinzufügen eines neuen Knotens erfordert eine Größenänderung der gesamten Matrix.
- Das Iterieren über die Nachbarn eines einzelnen Knotens benötigt O(V), selbst wenn der Knoten nur wenige Kanten hat.
Vorteile der Adjazenzliste:
- Benötigt nur O(V + E) Speicherplatz, was nahe an der tatsächlichen Kantenanzahl in dünn besetzten Graphen liegt.
- Das Hinzufügen eines neuen Knotens oder einer neuen Kante ist O(1).
- Traversierungsalgorithmen wie BFS und DFS iterieren Nachbarn in O(Grad), was eine Gesamtlaufzeit von O(V + E) ergibt.
Nachteile der Adjazenzliste:
- Die Überprüfung, ob eine bestimmte Kante existiert, benötigt O(Grad) Zeit anstatt O(1).
- Die Cache-Lokalität ist schwächer, weil verkettete Listen über den gesamten Speicher verteilt sind.
- Gewichtete Kanten benötigen ein Begleitfeld oder eine Liste von Paaren, was die Datenstruktur etwas komplizierter macht.
Wann verwendet man eine Adjazenzliste und wann eine Adjazenzmatrix?
Die Wahl der Darstellungsform hängt von der Dichte des Graphen und den am häufigsten ausgeführten Operationen ab. Nutzen Sie diese Kurzanleitung, um die richtige Struktur auszuwählen:
- Die Adjazenzmatrix ist vorzuziehen. wenn der Graph dicht ist (E ist nahe an V²), wenn sich Kanten selten ändern und wenn Ihr Algorithmus viele Male fragt: „Gibt es eine Kante zwischen i und j?“
- Bevorzugen Sie die Adjazenzliste. wenn der Graph dünn besetzt ist (E ist viel kleiner als V²), wenn die Knoten- oder Kantenmenge während der Ausführung wächst und wenn Sie den Graphen mit BFS, DFS oder durchlaufen Dijkstras Algorithmus für kürzeste Wege.
- Bevorzuge ein gemischtes Modell (Adjazenzliste plus Hash-Set von Kanten), wenn Sie sowohl eine schnelle Nachbariteration als auch O(1) Kantenabfragen benötigen, allerdings auf Kosten von zusätzlichem Speicherplatz.
Moderne Graphbibliotheken wie NetworkX und igraph verwenden standardmäßig Adjazenzlisten, da die meisten realen Graphen – soziale Netzwerke, Straßenkarten, Webseiten, Paketabhängigkeiten – dünn besetzt und traversierungsintensiv sind.
