
So laden Sie NLTK herunter und installieren es
 Redaktion
⚡ Intelligente Zusammenfassung
Laden Sie NLTK herunter und installieren Sie es auf Windows, Mac oder Linux durch Installation Python zuerst, dann das Natürliche hinzufügen Language ToolKit über pip oder Anaconda herunterladen und die Korpusdatensätze herunterladen.
NLTK installieren in Windows
Erfahren Sie, wie Sie NLTK einrichten auf Windows von der Eingabeaufforderung. Die folgenden Anweisungen setzen Folgendes voraus: Python ist noch nicht installiert, daher besteht der erste Schritt darin, es zu installieren. Python.
Montage von Python in Windows
Schritt 1) Öffne den Link https://www.python.org/downloads/, und wählen Sie die neueste Windows freizugeben.
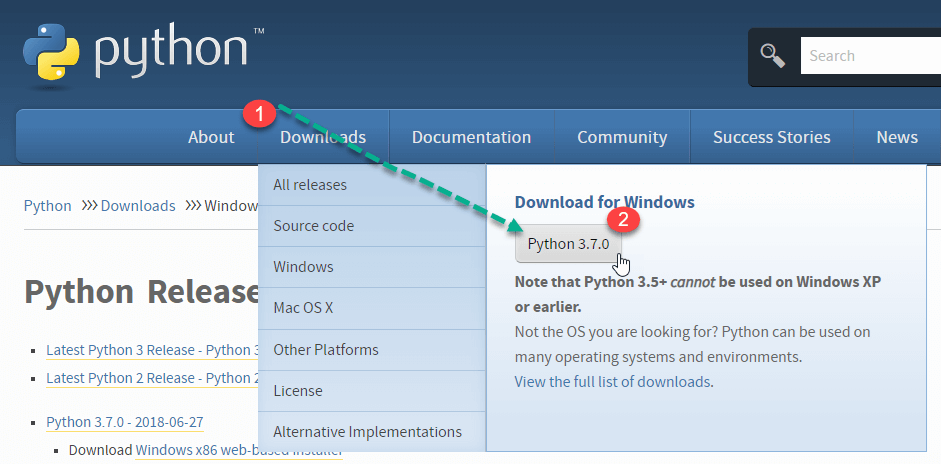
HinweisEine ältere Version finden Sie auf der Registerkarte „Downloads“, wo Sie alle Versionen einsehen können.

Schritt 2) Klicken Sie auf die heruntergeladene Installationsdatei.
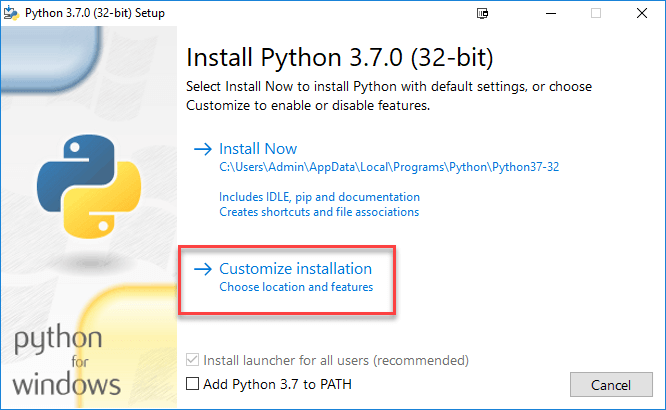
Schritt 3) Wählen Sie „Installation anpassen“.
Schritt 4) Klicken Sie auf WEITER.

Schritt 5) Auf dem nächsten Bildschirm:
- Wählen Sie die erweiterten Optionen.
- Geben Sie einen benutzerdefinierten Installationsort an. In diesem Beispiel wird ein Ordner auf dem Laufwerk C: ausgewählt, um den Zugriff zu vereinfachen.
- Klicken Sie auf Installieren.

Schritt 6) Klicken Sie auf die Schaltfläche „Schließen“, sobald die Installation abgeschlossen ist.

Schritt 7) Kopieren Sie den Pfad Ihres Skriptordners.

Schritt 8) Im Windows Eingabeaufforderung:
- Navigieren Sie zum Speicherort des pip-Ordners.
- Geben Sie den Befehl zum Installieren von NLTK ein:
pip3 install nltk
- Die Installation sollte erfolgreich abgeschlossen werden.

HINWEIS: Zum Python 2. Verwenden Sie den Befehl pip2 install nltk.
Schritt 9) Von dem Windows Startmenü, suchen und öffnen Sie die Python Schale.

Schritt 10) Überprüfen Sie die Funktionsfähigkeit der Installation, indem Sie den folgenden Befehl ausführen:
import nltk

Wenn keine Fehlermeldung erscheint, ist die Installation abgeschlossen.
NLTK unter Mac/Linux installieren
Die Installation von NLTK auf Mac oder Linux erfordert Folgendes: Python Paketmanager pip. Falls pip nicht installiert ist, befolgen Sie die unten stehenden Anweisungen, um den Vorgang abzuschließen.
Schritt 1) Aktualisiere den Paketindex nach typing den folgenden Befehl:
sudo apt update
Schritt 2) Installieren Sie pip für Python 3:
sudo apt install python3-pip
Sie können pip auch über easy_install installieren:
sudo apt-get install python-setuptools python-dev build-essential
Sobald easy_install installiert ist, führen Sie den folgenden Befehl aus, um pip zu installieren:
sudo easy_install pip
Schritt 3) Verwenden Sie den folgenden Befehl, um NLTK zu installieren:
sudo pip install -U nltk
sudo pip3 install -U nltk
NLTK über Anaconda installieren
Schritt 1) Installieren Sie Anaconda, indem Sie die folgende Seite besuchen: https://www.anaconda.com/products/individual und Auswählen der Python Die benötigte Version.

Hinweis: Detaillierte Schritte dazu finden Sie in diesem Tutorial Anaconda installieren.
Schritt 2) In der Anaconda-Eingabeaufforderung:
- Geben Sie den Befehl ein:
conda install -c anaconda nltk
- RevSehen Sie sich die Informationen zu Paketaktualisierung, -downgrade und -installation an und geben Sie dann „ja“ ein.
- NLTK wurde heruntergeladen und installiert.

NLTK-Datensatz
Das NLTK-Modul wird mit vielen Datensätzen ausgeliefert, die Sie vor der Verwendung herunterladen müssen. Technisch gesehen wird jeder Datensatz als Datensatz bezeichnet. KorpusGängige Beispiele sind Stoppwörter, Gutenberg, Framenet_v15, große_grammatiken, braun und Wortnetz.
So laden Sie alle NLTK-Pakete herunter
Schritt 1) Führen Sie die Python Dolmetscher in Windows oder Linux.
Schritt 2)
- Geben Sie die Befehle ein:
import nltk
nltk.download ()
- Das NLTK-Downloadfenster öffnet sich. Klicken Sie auf die Schaltfläche „Herunterladen“, um den Datensatz abzurufen. Dieser Vorgang kann je nach Internetverbindung einige Zeit dauern.

Anmerkungen: Sie können den Download-Speicherort ändern, indem Sie auf Datei > Download-Verzeichnis ändern klicken.

Schritt 3) Um die installierten Daten zu testen, verwenden Sie folgenden Code:
>>> from nltk.corpus import brown
>>>brown.words()
['The', 'Fulton', 'County', 'Grand', 'Jury', 'said', …]

Ausführen des NLP-Skripts
Dieser Abschnitt erklärt, wie ein NLP-Skript auf einem lokalen PC ausgeführt wird. Die Wahl der richtigen Bibliothek hängt von Ihren Anforderungen ab. Siehe die offizielle Liste. NLP-Bibliotheken für Alternativen wie spaCy, gensim und TextBlob.
So führen Sie ein NLTK-Skript aus
Schritt 1) Kopieren Sie den Code in Ihrem bevorzugten Code-Editor und speichern Sie die Datei unter NLTKsample.py:
from nltk.tokenize import RegexpTokenizer
tokenizer = RegexpTokenizer(r'\w+')
filterdText=tokenizer.tokenize('Hello Guru99, You have build a very good site and I love visiting your site.')
print(filterdText)

Code Erläuterung:
- Ziel dieses Programms ist es, jegliche Art von Satzzeichen aus einem gegebenen Text zu entfernen. Wir haben „RegexpTokenizer“, ein Modul von NLTK Dadurch werden beliebige Ausdrücke, Symbole, Zeichen oder numerische Werte entfernt.
- Dem Modul „RegexpTokenizer“ wird ein regulärer Ausdruck übergeben.
- Der Text wird mithilfe der Methode „tokenize“ tokenisiert, und die Ausgabe wird in der Variable „filterdText“ gespeichert.
- Das Ergebnis wird mit „print()“ ausgegeben.
Schritt 2) In der Eingabeaufforderung:
- Navigieren Sie zu dem Speicherort, an dem Sie die Datei gespeichert haben.
- Führen Sie den Befehl aus
python NLTKsample.py.

Die Ausgabe ist:
['Hallo', 'Guru99', 'Du', 'hast', 'baust', 'eine', 'sehr', 'gute', 'Website', 'und', 'ich', 'liebe', 'deine', 'Website' zu besuchen]
