
Aggregatortransformation in Informatica mit Beispiel
 David Carter
⚡ Intelligente Zusammenfassung
Die Aggregator-Transformation in Informatica ist das aktive Objekt, das Berechnungen wie Summe, Durchschnitt und Anzahl über eine Gruppe von Zeilen durchführt und diese Zeilen in einem Aggregat-Cache speichert, bis jede Gruppe abgeschlossen ist.
Was ist Aggregator-Transformation?
Die Aggregator-Transformation ist eine aktive Transformation, die Aggregatberechnungen wie Summe, Durchschnitt und Anzahl durchführt.
Wenn Sie beispielsweise die Summe der Gehälter aller Mitarbeiter abteilungsweise berechnen möchten, können Sie die Aggregator-Transformation verwenden.
Die Aggregatvorgänge werden über eine Gruppe von Zeilen ausgeführt, sodass ein temporärer Platzhalter erforderlich ist, um alle diese Datensätze zu speichern und die Berechnungen durchzuführen.
Hierfür wird der Aggregator-Cache verwendet. Dies ist ein temporärer Hauptspeicher, der der Aggregator-Transformation zur Durchführung solcher Operationen zugewiesen wird und in zwei Teile unterteilt ist: Der Index-Cache speichert die Gruppenwerte, während der Daten-Cache die zu aggregierenden Zeilendaten speichert.
Die Transformation ist aktiv, da sie die Anzahl der Zeilen in der Pipeline ändert. Mehrere tausend Mitarbeiterdatensätze können hineingelangen, und nur eine Zeile pro Abteilung verlässt sie.
Wie man die Aggregator-Transformation in Informatica verwendet
In diesem Beispiel berechnen wir die Summe der Gehälter nach Abteilungen. Dazu benötigen wir eine neue Spalte, um diese Summe zu speichern. Also bereiten wir zunächst eine neue Spalte vor.
Schritt 1) Erstellen Sie mithilfe des unten stehenden Skripts eine neue Datenbankzieltabelle, beispielsweise „sum_sal_deptwise“. Die neue Datenbankzieltabelle wird anschließend unter folgendem Pfad angezeigt: TargetIm nächsten Schritt den Ordner „s“ ansteuern.
Laden Sie die obige Datei Create_table_sal_deptwise.txt herunter
Schritt 2) Erstelle eine neue Karteping “m_sum_sal_deptwise”.
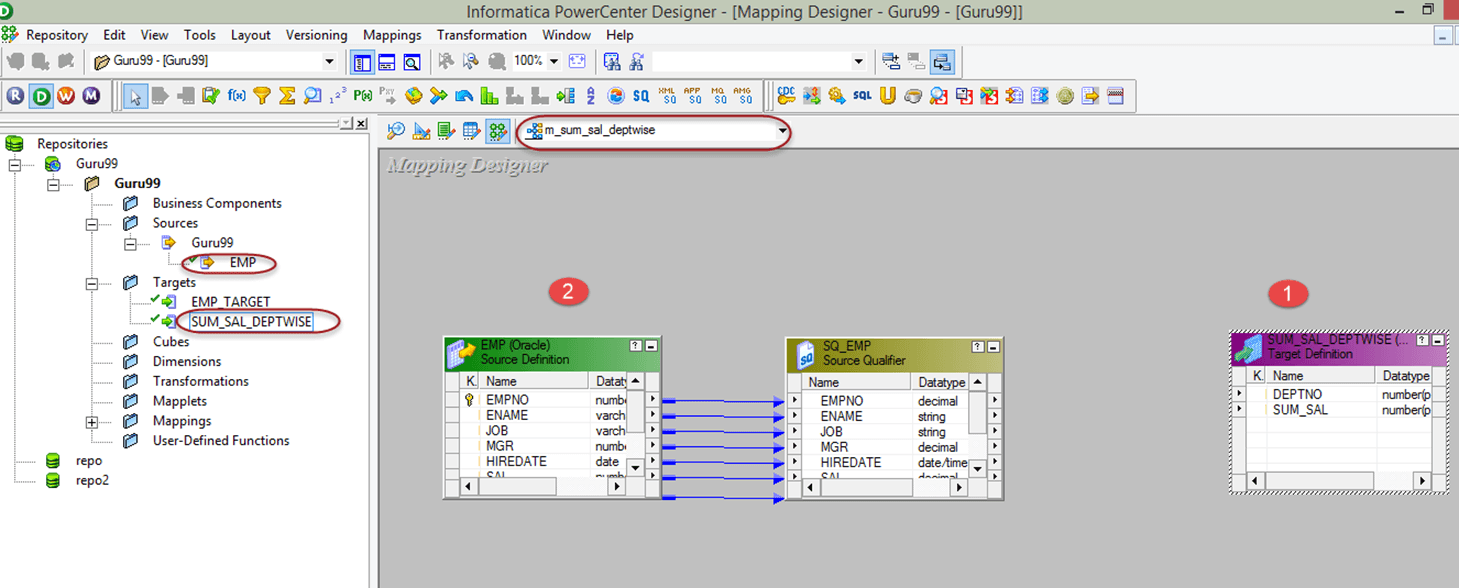
Um die neue Karte zu erstellenpingWir benötigen die Quelltabelle (EMP) und die Zieltabelle (sum_sal_deptwise) in Map.ping Designer, also müssen wir
- Importieren Sie die Zieltabelle „sum_sal_deptwise“ in die Map.ping.
- Importieren Sie die Quelltabelle „emp“.
Beide Definitionen erscheinen nun auf der Leinwand, wie unten dargestellt.
Schritt 3) Auf der Karteping,
- Von dem QuellqualifikatorLöschen Sie die Spalten empno, ename, job, mgr, hiredate und comm, sodass nur die Spalten deptno und sal übrig bleiben.
- Erstellen Sie eine neue Aggregator-Transformation über das Werkzeugmenü, wie im Screenshot gezeigt. Durch Klicken auf das Aggregator-Symbol wird eine neue Aggregator-Transformation erstellt.
Das neue AGGTRANS-Objekt erscheint neben dem gekürzten Source Qualifier.

Schritt 4) Ziehen Sie die Spalten SAL und DEPTNO aus dem Source Qualifier (SQ_EMP) per Drag & Drop in die Aggregator-Transformation. Die beiden Ports sind nun mit AGGTRANS verbunden.

Schritt 5) DoubleKlicken Sie auf die Aggregator-Transformation, um deren Eigenschaften zu öffnen, und dann
- Fügen Sie der Transformation einen neuen Port hinzu
- Benennen Sie den Port in SUM_SAL um.
- Ändern Sie den Datentyp dieses neuen Ports auf double
- Machen Sie diesen Port zu einem Ausgangsport, indem Sie das Kontrollkästchen des Ausgangsports aktivieren.
- Klicken Sie auf die Ausdrucksoption
Auf der Registerkarte „Ports“ werden nun SAL, DEPTNO und der neue Ausgangsport SUM_SAL angezeigt.

Schritt 6) Im Ausdruckseditor-Fenster
- Fügen Sie den Ausdruck sum(SAL) hinzu; Sie müssen diesen Ausdruck selbst schreiben.
- Klicken Sie auf die Schaltfläche OK. Dadurch wird das Fenster „Transformationen bearbeiten“ wieder angezeigt.
Im Ausdruckseditor wird der SUM_SAL zugewiesene Aggregatausdruck angezeigt.

Schritt 7) Im Fenster „Transformationen bearbeiten“ wählen Sie die Option „Gruppieren nach“, indem Sie das Kontrollkästchen neben der Spalte „deptno“ aktivieren, und klicken auf „OK“. Durch die Auswahl von „Gruppieren nach“ für „deptno“ weisen wir Informatica an, die Gehälter nach Abteilungsnummer zu gruppieren.

Schritt 8) Verknüpfen Sie die Spalten „deptno“ und „sum_sal“ aus der Aggregator-Transformation mit der Zieltabelle. Die Zuordnungping ist dann von der Quelle zum Ziel vollständig.

Speichere nun die Karteping und führen Sie es nach dem Erstellen eines neuen Session für diese KartepingDie Zieltabelle würde die Summe der Gehälter nach Abteilungen enthalten. Auf diese Weise können wir die Aggregator-Transformation verwenden, um aggregierte Ergebnisse zu berechnen.
Gruppierung nach Ports in der Aggregator-Transformation
Im vorherigen Schritt wurde ein einzelner Port als „Gruppieren nach“ markiert, wodurch die unternehmensweite Summe in eine Summe pro Abteilung umgewandelt wurde. Jeder Eingangs-, Eingangs-/Ausgangs-, Ausgangs- oder variable Port kann auf dieselbe Weise markiert werden.
Drei Regeln bestimmen das Ergebnis:
- Eine Reihe pro Gruppe. Wenn Werte gruppiert werden, erzeugt der Integrationsdienst für jede eindeutige Kombination der Gruppierungs-Ports eine Zeile.
- Keine Gruppierung, eine Zeile. Wenn kein Port markiert ist, wird die gesamte Eingabe als eine einzige Gruppe behandelt und für alle Eingabezeilen wird eine Zeile zurückgegeben.
- Die letzte Reihe gewinnt. Zusammen mit dem Gesamtergebnis übergibt der Integrationsdienst üblicherweise die letzte empfangene Zeile der Gruppe, es sei denn, eine Funktion wie FIRST gibt eine andere Zeile an.
Wenn mehrere Häfen markiert sind, bestimmt die Reihenfolge der Häfen die Gruppierung.ping Die Reihenfolge ist entscheidend, und die Reihenfolge kann das Ergebnis beeinflussen.ping nach DEPTNO und dann JOB ist nicht dasselbe wie Gruppeping nach JOB und dann DEPTNO, da die Werte in der zweiten Spalte nicht unbedingt eindeutig sind.
Aggregator-Transformationseigenschaften
Im Eigenschaften-Tab des Fensters „Transformationen bearbeiten“ finden Sie die Einstellungen, die festlegen, wo der Cache gespeichert wird und wie groß er ist. Die folgende Tabelle listet diese Einstellungen auf.
| Rahmen | Was es steuert |
|---|---|
| Cache-Verzeichnis | Das lokale Verzeichnis, in dem der Integrationsdienst die Index- und Datencachedateien erstellt. Standardmäßig wird die im Workflow Manager festgelegte Prozessvariable $PMCacheDir verwendet. |
| Tracing Level | Detailgrad der im Sitzungsprotokoll für diese Transformation geschriebenen Informationen. |
| Sortierte Eingabe | Gibt an, dass die eingehenden Daten bereits nach Ports gruppiert und sortiert sind. Wählen Sie diese Option nur aus, wenn die Karteping Liefert tatsächlich sortierte Daten. |
| Größe des Aggregator-Datencaches | Größe des Datencaches. Der Standardwert beträgt 2,000,000 Byte, und die Einstellung „Auto“ überlässt die Größenbestimmung dem Integrationsdienst. |
| Größe des Aggregator-Index-Cache | Größe des Index-Caches. Der Standardwert beträgt 1,000,000 Byte, und die Option „Auto“ überlässt die Größenbestimmung dem Integrationsdienst. |
| Transformationsbereich | Wendet die Logik auf jede Transaktion oder auf alle eingehenden Daten an. Bei „Alle Eingaben“ werden die Grenzen eingehender Transaktionen entfernt. |
Wenn die inkrementelle Aggregation aktiviert ist, schreibt der Integrationsdienst bei jedem Durchlauf eine Sicherungskopie der Cache-Dateien, sodass das Cache-Verzeichnis zwei Sätze von Dateien anstatt nur einen enthalten muss.
Regeln für Aggregatausdrücke und Tipps zur Leistungsoptimierung
Ein Aggregatausdruck kann eine Aggregatfunktion mit bedingten Klauseln und Nicht-Aggregatfunktionen kombinieren, wodurch bedingte Summen und Zählungen innerhalb eines Ports möglich sind. Zwei Regeln schränken die Möglichkeiten ein.
- Eine Verschachtelungsebene. Nur eine Aggregatfunktion darf in einer anderen verschachtelt sein, und der innere Ausdruck wird zuerst ausgewertet.
- Kein Mischen. Eine Transformation kann entweder einstufige oder verschachtelte Funktionen enthalten, niemals beides. Enthält sie beides, markiert der Designer die Zuordnung.ping Ungültig, daher wird die Logik auf zwei Aggregator-Transformationen aufgeteilt.
Was die Klangabstimmung angeht, erledigen drei Einstellungen den größten Teil der Arbeit:
- Sortierte Eingabe. Wenn Zeilen sortiert nach den Gruppierungs-Ports eintreffen, kann jede Gruppe freigegeben werden, sobald ihre letzte Zeile eingetroffen ist. Dadurch werden deutlich weniger Daten zwischengespeichert und die Sitzung wird schneller ausgeführt. Sortierte Eingaben können nicht mit inkrementeller Aggregation kombiniert werden.
- Inkrementelle Aggregation. Neue Quellzeilen werden durch die Map geleitetping und kombiniert mit dem historischen Cache anstatt die Historie neu zu berechnen, was für eine nächtliche Aktualisierung auf eine laufende Summe geeignet ist.
- Frühzeitig filtern. Zeilen, die niemals zu einer Gesamtsumme beitragen, sollten vor dem Aggregator entfernt werden, entweder in der Quellqualifiziererabfrage oder in einem FiltertransformationDenn jede Zeile, die den Aggregator erreicht, benötigt Cache-Speicher. Dies ist eine der Standardprüfungen während des Vorgangs. Leistungsoptimierung.
