
Rang transformatie in Informatica met VOORBEELD
 David Carter
⚡ Slimme samenvatting
Ranktransformatie in Informatica is een actief, verbonden object dat alleen de bovenste of onderste N rijen van elke groep behoudt en elke overgebleven rij een positie toewijst via de automatische RANKINDEX-uitvoerpoort.
Wat is rangtransformatie?
De rangordetransformatie is een actieve en verbonden transformatie die gegevens filtert op basis van groepering en rangorde. Als u bijvoorbeeld de tien records wilt ophalen van werknemers met het hoogste salaris, kan dat soort filtering worden uitgevoerd met behulp van de rangordetransformatie.
Ranktransformatie biedt ook de mogelijkheid om te rangschikken op basis van groepen. Als u bijvoorbeeld de tien bestbetaalde werknemers per afdeling wilt weergeven, dan kunt u die groep gebruiken.ping Dit kan met deze transformatie worden gedaan.
Rangtransformatie is een actieve transformatie, omdat deze het aantal uitvoerrijen beïnvloedt.
De Rank-transformatie heeft een uitvoerpoort waarmee een rangorde aan de rijen wordt toegekend. Deze poort heet RANKINDEX en de Designer maakt deze automatisch aan zodra de transformatie aan de applicatie wordt toegevoegd. kaartping.
Omdat de rangschikking elke rij in een groep moet vergelijken voordat kan worden bepaald welke rijen winnen, cachet de Integration Service de binnenkomende gegevens. Groepswaarden worden in een indexcache geplaatst en de rest van de rijgegevens in een datacache, op dezelfde manier als een gecachede database. Transformatie van schrijnwerkers Het hoofdtransportsysteem bevindt zich in de pijpleiding.
Havens in een rangtransformatie
Voordat we naar het uitgewerkte voorbeeld gaan, is het handig om te weten wat elke poortvlag op het tabblad Poorten precies doet, aangezien twee ervan het eigenlijke werk van deze transformatie uitvoeren.
| Poorttype | Wat het doet |
|---|---|
| Ingang (ik) | Ontvangt een kolom van de upstream-transformatie. Elke kolom die is gekoppeld aan de Rank-transformatie is een invoerpoort. |
| Uitvoer (O) | Geeft een kolom door aan de volgende transformatie of aan het doel. |
| Variabele (V) | Bevat een lokale berekening binnen de transformatie, precies zoals in een Expression-transformatie. |
| Rang (R) | Geeft de kolom aan waarop de rangschikking wordt berekend. Slechts één poort in de transformatie kan deze vlag bevatten. |
| Groeperen op | De rangschikking wordt voor elke afzonderlijke waarde opnieuw gestart, waardoor een filter op de top drie drie rijen per groep retourneert in plaats van drie rijen in totaal. |
| RANKINDEX | Een poort die uitsluitend voor uitvoer is bedoeld en door de ontwerper is aangemaakt. Deze poort slaat de rangpositie van elke rij binnen de groep op en kan ongebruikt blijven. |
Rangschikking kan slechts op basis van één haven worden gedaan, dus bij een vereiste zoals "hoogste salaris, gevolgd door langste diensttijd" moet de doorslaggevende factor stroomopwaarts worden vastgesteld in plaats van in een haven die op de tweede plaats staat.
Hoe gebruik je rangtransformatie in Informatica?
Onze vereiste is om de drie bestbetaalde medewerkers van elke afdeling te laden; we zullen dit implementeren met behulp van een Rank-transformatie. Doorloop de acht stappen hieronder in de Map.ping Ontwerper.
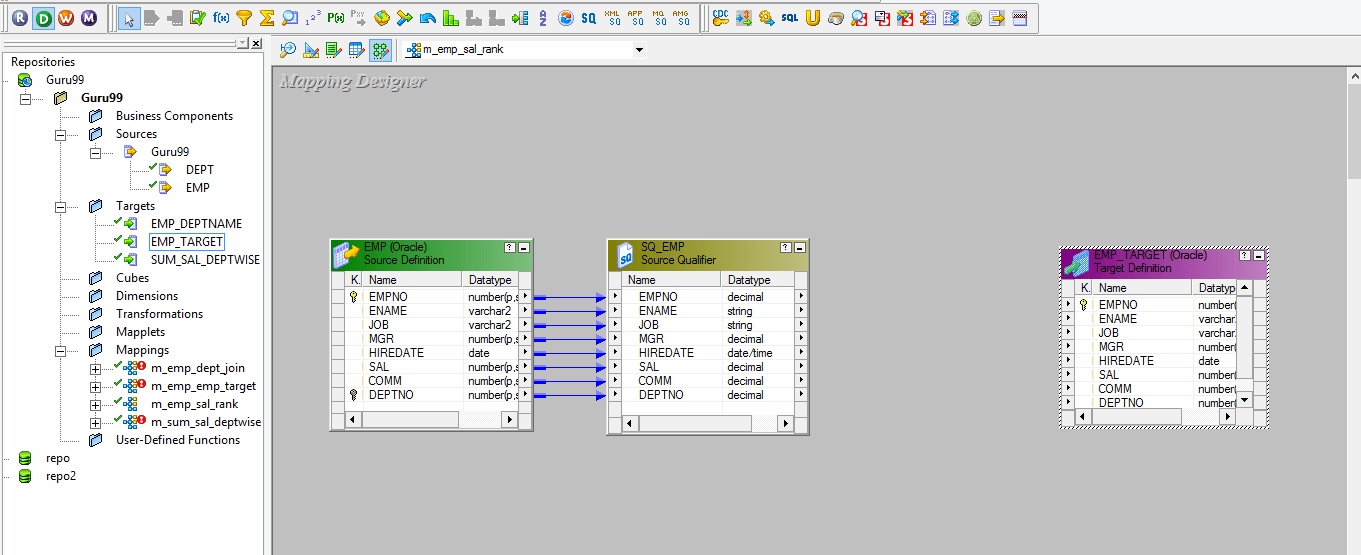
Stap 1) Maak een kaartping met bron EMP en doel EMP_TARGET. Beide definities bevinden zich nu op het canvas, zoals hieronder weergegeven.
Stap 2) Vervolgens op de kaartping
- Selecteer transformatiemenu
- Selecteer optie maken
Het transformatiemenu met de optie 'Maken' wordt hierna weergegeven.

Stap 3) In het transformatievenster maken
- Selecteer rangtransformatie
- Voer de transformatienaam “rnk_salary” in
- Selecteer de knop Maken

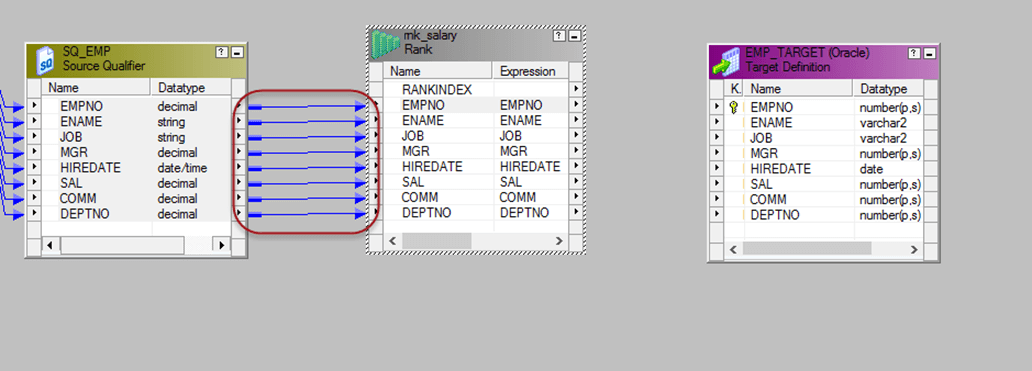
Stap 4) De rangtransformatie wordt in de kaart gecreëerd.pingSelecteer de knop 'Gereed' in het venster. Het lege object rnk_salary verschijnt nu op het canvas.

Stap 5) Sluit alle poorten aan van bronkwalificatie naar de Rank-transformatie, zodat elke werknemerskolom beschikbaar is voor rangschikking.
Stap 6) Double Klik op de Rank-transformatie om het venster "Transformatie bewerken" te openen. In dit venster
- Selecteer het eigenschappenmenu
- Selecteer de optie “Top” in de eigenschap Top/Bottom
- Voer 3 in bij het aantal rangen
Het tabblad Eigenschappen geeft nu 'Top' weer met drie rangen, zoals de schermafbeelding laat zien.

Stap 7) In het venster "transformatie bewerken" opnieuw
- Selecteer het tabblad Poorten
- Selecteer groeperen op optie voor de kolom Afdelingsnummer
- Selecteer Rang in de Salariskolom
- Selecteer de knop OK
Het tabblad Havens toont nu het groepslogo bij het afdelingsnummer en het R-logo bij het salaris.

Stap 8) Verbind de poorten van de Rank-transformatie met de doeltabel. De kaartping Nu loopt het van EMP via rnk_salary naar EMP_TARGET.

Sla de kaart nu op.ping en voer het uit na het maken van een sessie en workflowDe bronkwalificatie haalt alle records op, maar de rangschikkingstransformatie laat alleen records door met drie hoge salarissen per afdeling.
Eigenschappen van rangtransformaties
Het tabblad Eigenschappen dat in stap 6 wordt gebruikt, bevat meer dan de twee instellingen die in het voorbeeld worden gewijzigd. De onderstaande instellingen bepalen hoeveel rijen behouden blijven, hoe tekenreeksen worden vergeleken en waar de cachebestanden worden opgeslagen.
| Eigendom | Wat het controleert |
|---|---|
| Boven / onder | Of de hoogste of de laagste waarden worden behouden voor de gerangschikte kolom. In het voorbeeld wordt 'Top' gebruikt. |
| Aantal rangen | Hoeveel rijen worden er per groep geretourneerd? In het voorbeeld worden er 3 gebruikt, dus elke afdeling retourneert drie medewerkers. |
| Stringvergelijking waarbij rekening wordt gehouden met hoofdletters en kleine letters | Of tekenreeksvergelijkingen rekening houden met hoofdletters en kleine letters bij het rangschikken. Dit is alleen van belang wanneer de rangschikkingspoort tekst bevat. |
| Cachemap | De map waarin de index- en datacachebestanden worden aangemaakt. De standaardlocatie is de procesvariabele $PMCacheDir. |
| Grootte van de rangdatacache | Grootte van de datacache waarin de rijgegevens worden opgeslagen. De standaardwaarde is 'Automatisch', waardoor de Integration Service de grootte hiervan bepaalt. |
| Rang Index Cachegrootte | Grootte van de indexcache die de groepswaarden bevat. De standaardwaarde is Auto. |
| Transformatiebereik | Past de rangschikking toe op elke transactie of op alle binnenkomende gegevens. |
| Tracing Niveau | Hoeveelheid details die in het sessielogboek worden vastgelegd: Beknopt, Normaal, Uitgebreide initialisatie of Uitgebreide gegevens. |
De cachegrootte is een instelling die het overwegen waard is bij grote bronnen. Wanneer de caches te klein zijn, schrijft de Integration Service pagina's naar de schijf, wat een van de eerste dingen is die gecontroleerd wordt tijdens het laden. prestatieafstemming van een kaartping.
Rangtransformatie versus aggregatietransformatie
Beide transformaties zijn actief, beide cachen hun invoer en beide bieden Group By-poorten aan, waardoor het gemakkelijk is om de verkeerde te selecteren. Het verschil zit hem in de output.
| Punt van vergelijking | Rangtransformatie | Aggregator-transformatie |
|---|---|---|
| Doel | Geeft de bovenste of onderste N volledige rijen van elke groep terug. | Geeft berekende waarden terug, zoals SOM. AVG, MAX of MIN per groep |
| Geretourneerde rijen | Tot het aantal rangen per groep, met alle kolommen intact. | Normaal gesproken één samenvattingsregel per groep |
| Extra poort toegevoegd | RANKINDEX, die de positie van elke rij bijhoudt | Geen |
| Gerangschikte of geaggregeerde kolom | Eén poort is gemarkeerd als de rangpoort. | Een willekeurig aantal poorten die aggregatie-uitdrukkingen transporteren |
Simpel gezegd, een Aggregator-transformatie Een rangtransformatie beantwoordt de vraag "wat is het hoogste salaris in deze afdeling?", terwijl een rangtransformatie de vraag beantwoordt "welke werknemers verdienen dat salaris?". Wanneer slechts een subset van rijen moet worden verwijderd op basis van een eenvoudige voorwaarde en er geen sprake is van sortering, dan is een rangtransformatie geschikt. Filtertransformatie is de goedkopere optie, omdat er helemaal geen cache nodig is.
