
Aggregatortransformatie in Informatica met voorbeeld
 Redactie
⚡ Slimme samenvatting
De aggregator-transformatie in Informatica is het actieve object dat berekeningen uitvoert zoals optellen, gemiddelden en tellen over een groep rijen, waarbij die rijen in een aggregatiecache worden bewaard totdat elke groep is voltooid.
Wat is aggregatortransformatie?
Een aggregatietransformatie is een actieve transformatie die aggregatieberekeningen uitvoert, zoals optellen, gemiddelde berekenen en tellen.
Als u bijvoorbeeld de som van de salarissen van alle medewerkers per afdeling wilt berekenen, kunt u de Aggregator-transformatie gebruiken.
De samengevoegde bewerkingen worden uitgevoerd op een groep rijen. Daarom is er een tijdelijke tijdelijke aanduiding nodig om al deze records op te slaan en de berekeningen uit te voeren.
Hiervoor wordt de aggregatorcache gebruikt. Dit is tijdelijk hoofdgeheugen dat is toegewezen aan de Aggregator-transformatie om dergelijke bewerkingen uit te voeren, en het is opgedeeld in twee delen: de indexcache slaat de groepswaarden op, terwijl de datacache de rijgegevens opslaat die worden geaggregeerd.
De transformatie is actief omdat deze het aantal rijen in de pipeline verandert. Er kunnen duizenden werknemersgegevens in de pipeline terechtkomen en er verlaat slechts één rij per afdeling de pipeline.
Hoe gebruik je de Aggregator-transformatie in Informatica?
In dit voorbeeld berekenen we de som van salarissen per afdeling. Hiervoor hebben we een nieuwe kolom nodig om deze som op te slaan. Dus, allereerst bereiden we een nieuwe kolom voor.
Stap 1) Maak een nieuwe doeltabel in de database aan, bijvoorbeeld "sum_sal_deptwise", met behulp van het onderstaande script. Je ziet de nieuwe doeltabel in de database aangemaakt onder de Targets map in de volgende stap.
Download het bovenstaande bestand Create_table_sal_deptwise.txt
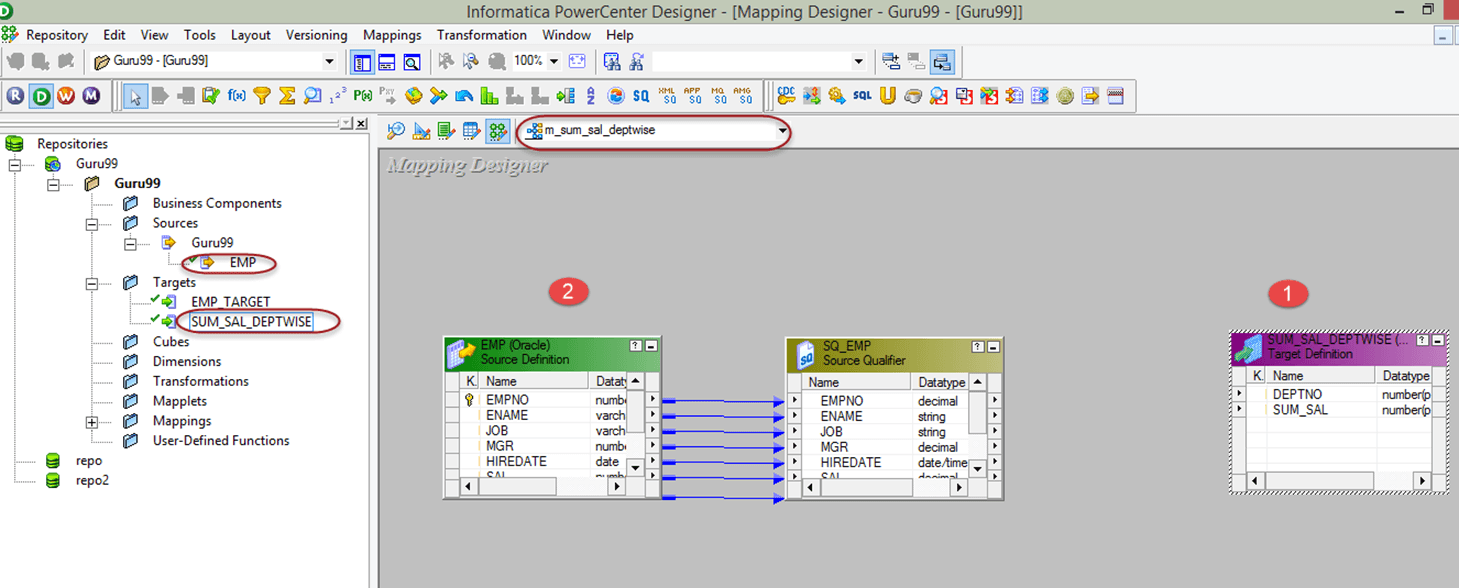
Stap 2) Maak een nieuw kaartping “m_sum_sal_deptwise”.
Om de nieuwe kaart te makenpingWe hebben de brontabel (EMP) en de doeltabel (sum_sal_deptwise) nodig in een Map.ping Ontwerper, dus we moeten
- Importeer de doeltabel “sum_sal_deptwise” in de map.ping.
- Importeer de brontabel “emp”.
Beide definities verschijnen nu op het canvas, zoals hieronder weergegeven.
Stap 3) Op de kaartping,
- Van de BronkwalificatieVerwijder de kolommen empno, ename, job, mgr, hiredate en comm, zodat alleen de kolommen deptno en sal overblijven.
- Maak een nieuwe Aggregator-transformatie aan via het menu van de toolbox, zoals weergegeven in de schermafbeelding. Wanneer u op het aggregator-pictogram klikt, wordt er een nieuwe Aggregator-transformatie aangemaakt.
Het nieuwe AGGTRANS-object verschijnt naast de ingekorte Source Qualifier.

Stap 4) Sleep de kolommen SAL en DEPTNO van de Source Qualifier (SQ_EMP) naar de Aggregator-transformatie. De twee poorten zijn nu gekoppeld in AGGTRANS.

Stap 5) Double-klik op de Aggregator-transformatie om de eigenschappen ervan te openen en vervolgens
- Voeg een nieuwe poort toe aan de transformatie
- Hernoem de poort naar SUM_SAL
- Wijzig het gegevenstype van deze nieuwe poort naar dubbel
- Maak van deze poort een uitvoerpoort door het selectievakje voor de uitvoerpoort aan te vinken.
- Klik op de expressie-optie
Op het tabblad Poorten worden nu SAL, DEPTNO en de nieuwe uitvoerpoort SUM_SAL weergegeven.

Stap 6) In het venster Expressie-editor
- Voeg de expressie sum(SAL) toe; je moet deze expressie zelf schrijven.
- Selecteer de knop OK; hiermee wordt het venster 'Transformaties bewerken' opnieuw geopend.
De expressie-editor toont de aggregatie-expressie die is toegewezen aan SUM_SAL.

Stap 7) In het venster 'Transformaties bewerken' selecteert u de optie 'Groeperen op' door het selectievakje naast de kolom 'deptno' aan te vinken en klikt u op OK. Door 'Groeperen op' te selecteren voor 'deptno' geven we Informatica de opdracht om salarissen te groeperen op afdelingsnummer.

Stap 8) Koppel de kolommen deptno en sum_sal uit de Aggregator-transformatie aan de doeltabel. De mapping is dan van bron tot doel voltooid.

Sla de kaart nu op.ping en voer het uit na het aanmaken van een nieuwe sessie voor deze kaartpingDe doeltabel zou de som van de salarissen per afdeling bevatten. Op deze manier kunnen we de Aggregator-transformatie gebruiken om geaggregeerde resultaten te berekenen.
Groeperen op havens in aggregator-transformatie
In de bovenstaande stap werd één poort gemarkeerd als 'Groeperen op', waardoor een totaalbedrag voor het hele bedrijf werd omgezet in één totaalbedrag per afdeling. Elke invoer-, invoer/uitvoer-, uitvoer- of variabele poort kan op dezelfde manier worden gemarkeerd.
De resultatenreeks is gebaseerd op drie regels:
- Eén rij per groep. Wanneer waarden worden gegroepeerd, genereert de Integratieservice één rij voor elke unieke combinatie van de poorten waarop de groepering is gebaseerd.
- Geen groepering op, één rij. Als er geen poort is gemarkeerd, wordt de gehele invoer als één groep beschouwd en wordt er één rij geretourneerd voor alle invoerrijen.
- De laatste rij wint. Naast het geaggregeerde resultaat geeft de integratieservice doorgaans de laatst ontvangen rij in de groep door, tenzij een functie zoals FIRST een andere rij noemt.
Wanneer meerdere havens zijn aangegeven, bepaalt de volgorde van de havens de groepering.ping volgorde, en de volgorde kan het resultaat veranderen. Groepping door DEPTNO en vervolgens JOB is niet hetzelfde als groepping eerst op JOB en vervolgens op DEPTNO, omdat de waarden in de tweede kolom niet per se uniek hoeven te zijn.
Eigenschappen van aggregatortransformaties
Het tabblad Eigenschappen van het venster Transformaties bewerken bevat de instellingen die bepalen waar de cache zich bevindt en hoeveel ervan wordt gebruikt. De onderstaande tabel geeft een overzicht van deze instellingen.
| omgeving | Wat het controleert |
|---|---|
| Cachemap | De lokale map waarin de Integration Service de index- en datacachebestanden aanmaakt. De standaardlocatie is de procesvariabele $PMCacheDir die is ingesteld in Workflow Manager. |
| Tracing Niveau | De hoeveelheid details die voor deze transformatie in het sessielogboek is vastgelegd. |
| Gesorteerde invoer | Geeft aan dat de binnenkomende gegevens al gesorteerd zijn op basis van de groepering per poort. Selecteer deze alleen wanneer de kaartping Het levert daadwerkelijk gesorteerde gegevens op. |
| Grootte van de aggregator-datacache | Grootte van de datacache. De standaardwaarde is 2,000,000 bytes, en 'Auto' laat de Integration Service de grootte bepalen. |
| Grootte van de aggregatorindexcache | Grootte van de indexcache. De standaardwaarde is 1,000,000 bytes, en 'Auto' laat de Integration Service de grootte bepalen. |
| Transformatiebereik | Past de logica toe op elke transactie, of op alle binnenkomende gegevens. Alle invoer verwijdert de grenzen van de binnenkomende transacties. |
Wanneer incrementele aggregatie is ingeschakeld, schrijft de Integration Service bij elke uitvoering een back-up van de cachebestanden, waardoor de cachemap twee sets bestanden moet bevatten in plaats van één.
Aggregatie-expressieregels en prestatietips
Een aggregatie-uitdrukking kan een aggregatiefunctie combineren met voorwaardelijke clausules en niet-aggregatiefuncties, waardoor voorwaardelijke sommen en tellingen binnen één poort mogelijk zijn. Twee regels beperken wat er geschreven kan worden.
- Eén niveau van nesting. Slechts één aggregatiefunctie mag in een andere genest zijn, en de binnenste expressie wordt eerst geëvalueerd.
- Geen vermenging. Een transformatie kan functies op één niveau of geneste functies bevatten, nooit beide. Als een transformatie beide bevat, markeert de ontwerper de afbeelding.ping Ongeldig, dus verdeel de logica over twee Aggregator-transformaties.
Wat de afstemming betreft, doen drie instellingen het meeste werk:
- Gesorteerde invoer. Wanneer rijen gesorteerd binnenkomen op basis van de groepering per poort, kan elke groep worden vrijgegeven zodra de laatste rij binnenkomt. Hierdoor wordt er veel minder data in de cache opgeslagen en verloopt de sessie sneller. Gesorteerde invoer kan niet worden gecombineerd met incrementele aggregatie.
- Incrementele aggregatie. Nieuwe bronrijen worden door de map verwerkt.ping En in combinatie met de historische cache in plaats van de geschiedenis opnieuw te berekenen, wat geschikt is voor een nachtelijke laadbeurt die een doorlopend totaal bijhoudt.
- Filter vroegtijdig. Rijen die nooit zullen bijdragen aan een totaal, moeten vóór de Aggregator worden verwijderd, hetzij in de Source Qualifier-query, hetzij in een FiltertransformatieOmdat elke rij die de Aggregator bereikt cachegeheugen in beslag neemt. Dit is een van de standaardcontroles tijdens het proces. prestatieafstemming.
