
Joiner-transformatie in Informatica met VOORBEELD
 Redactie
⚡ Slimme samenvatting
De Joiner-transformatie in Informatica is het actieve, verbonden object dat twee heterogene bronnen samenvoegt op basis van een overeenkomende voorwaarde. Hierbij wordt de hoofdpipeline in het geheugen opgeslagen, terwijl de detailpipeline erdoorheen stroomt.
Wat is Joiner-transformatie?
De Joiner-transformatie is een actieve en verbonden transformatie waarmee u joins kunt maken in Informatica. De joins die met de Joiner-transformatie worden gemaakt, zijn vergelijkbaar met joins in databases. Het voordeel van de Joiner-transformatie is dat joins kunnen worden gemaakt voor heterogene systemen (verschillende databases).
Bij de Joiner-transformatie gebruiken we twee bronnen voor de joins. Deze twee bronnen heten:
- Hoofdbron
- Gedetailleerde bron
In de eigenschappen van de Joiner-transformatie kunt u selecteren welke gegevensbron de hoofdbron en welke de detailbron is.
Tijdens de uitvoering wordt de hoofdbron in het geheugen opgeslagen voor het samenvoegen van gegevens. Het is daarom aan te raden de bron met de minste records als hoofdbron te selecteren. De hoofdpipeline wordt in twee caches bewaard: een indexcache voor de waarden die in de samenvoegingsvoorwaarde worden gebruikt en een datacache voor de overige rijgegevens.
Soorten joins in Joiner-transformatie
De eigenschap 'Join Type' op het tabblad 'Properties' bepaalt wat er gebeurt met rijen die geen overeenkomst vinden. De volgende joins kunnen worden gemaakt met behulp van de Joiner-transformatie.
- Master buitenverbinding Bij een master outer join worden alle records uit de detailbron geretourneerd en worden alleen overeenkomende rijen uit de masterbron geretourneerd.
- Detail buitenvoeg Bij een detail outer join worden alleen overeenkomende rijen uit de detailbron geretourneerd, en alle rijen uit de masterbron.
- Volledige outer join Bij een volledige outer join worden alle records uit beide bronnen geretourneerd.
- Normaal meedoen – Bij een normale join worden alleen overeenkomende rijen uit beide bronnen geretourneerd.
Hoofd-buitenverbindingen en detail-buitenverbindingen zijn gelijk aan linker-buitenverbindingen in SQLElk type behoudt alle rijen van de ene bron en alleen de overeenkomsten uit de andere bron. De onderstaande tabel zet de vier typen naast hun SQL-equivalenten.
| Deelnemen aan type | Rijen behouden van master | Rijen die buiten detail zijn gehouden | SQL-equivalent |
|---|---|---|---|
| Normaal meedoen | Alleen overeenkomende opties | Alleen overeenkomende opties | Innerlijke join |
| Master buitenverbinding | Alleen overeenkomende opties | Alle rijen | Linker buitenste verbinding op de detailbron |
| Detail buitenvoeg | Alle rijen | Alleen overeenkomende opties | Linker buitenste join op de hoofdbron |
| Volledige outer join | Alle rijen | Alle rijen | Volledige outer join |
Het type koppeling is een eigenschap, geen structurele keuze, dus het kan later worden gewijzigd zonder de kaart opnieuw op te bouwen.ping of het opnieuw verbinden van poorten.
Hoe gebruik je de Joiner-transformatie in Informatica?
In dit voorbeeld voegen we de tabellen emp en dept samen met behulp van de Joiner-transformatie. Doorloop de acht onderstaande stappen in de Map.ping Ontwerper.
Stap 1) Maak met behulp van het onderstaande script een nieuwe doeltabel EMP_DEPTNAME aan in de database en importeer deze tabel in Informatica Targets.
Download het bovenstaande emp_deptname.sql-bestand
Stap 2) Maak een nieuw kaartping Importeer de brontabellen "EMP" en "DEPT" en de doeltabel die we in de vorige stap hebben gemaakt. Alle drie de definities staan nu op het canvas, zoals hieronder weergegeven.

Stap 3) Selecteer in het menu Transformatie de optie Maken. Open vervolgens het venster Transformatie maken (zie hieronder).
- Selecteer joiner-transformatie
- Voer de transformatienaam “jnr_emp_dept” in
- Selecteer optie maken

Stap 4) Sleep alle kolommen van zowel de Bronkwalificaties naar de Joiner-transformatie. Beide pipelines zijn nu gekoppeld aan jnr_emp_dept, zoals de schermafbeelding laat zien.

Stap 5) Double Klik op de Joiner-transformatie en vervolgens in het venster Transformaties bewerken.
- Selecteer het tabblad Conditie
- Klik op het pictogram voor het toevoegen van een nieuwe voorwaarde
- Selecteer deptno in de lijst met hoofd- en detailkolommen
Het tabblad 'Conditie' bevat nu de enige koppelingsvoorwaarde op afdelingsnummer.

Stap 6) Dan in hetzelfde venster
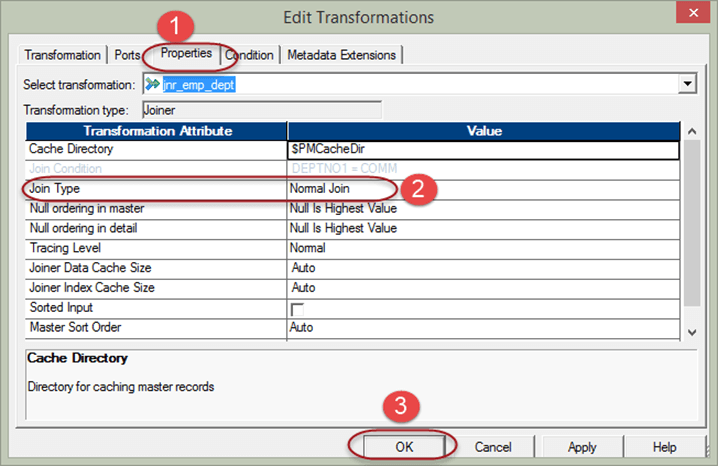
- Selecteer het tabblad Eigenschappen
- Selecteer Normale koppeling als koppelingstype.
- Selecteer de OK-knop.
Het tabblad Eigenschappen met het ingestelde verbindingstype wordt hierna weergegeven.
Voor prestatieoptimalisatie wijzen we de hoofdbron toe aan de brontabel-pipeline met de minste records. Om dit te doen:
Stap 7) Double Klik op de Joiner-transformatie om het venster 'Transformaties bewerken' te openen en vervolgens
- Selecteer het tabblad Poorten
- Selecteer een kolom van een bepaalde bron waarvan u een master wilt maken
- Klik op OK
Op het tabblad Poorten wordt de gekozen pijplijn als master gemarkeerd, zoals hieronder weergegeven.

Stap 8) Koppel de relevante kolommen van de Joiner-transformatie aan de doeltabel. De kaartping Nu worden de gegevens uit beide bronnen via de join in EMP_DEPTNAME verwerkt.
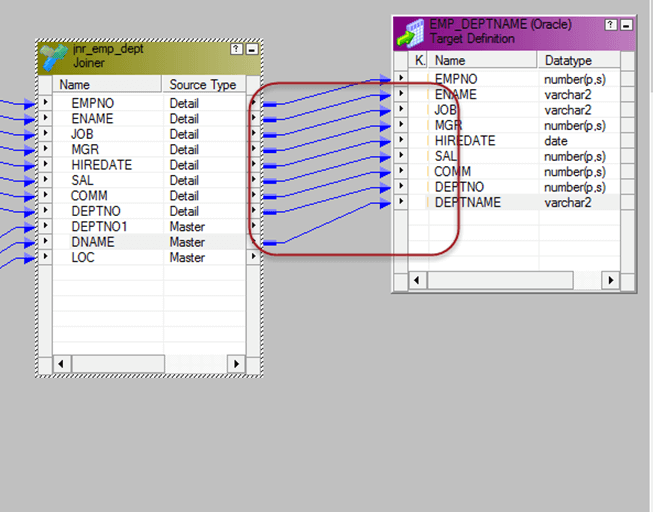
Sla de kaart nu op.ping en voer het uit na het maken van een sessie en workflow daarvoor. De koppeling wordt gemaakt met behulp van de Informatica Joiner en de relevante gegevens worden uit beide tabellen opgehaald.
Eigenschappen van de Joiner-transformatie
Het tabblad Eigenschappen bevat meer dan alleen het type join. De onderstaande instellingen bepalen hoeveel geheugen de join gebruikt en waar de cachebestanden worden opgeslagen.
| omgeving | Wat het controleert |
|---|---|
| Deelnametype | Normaal, Hoofdbuitenrand, Detailbuitenrand of Volledige buitenrand. Bepaalt welke niet-overeenkomende rijen behouden blijven. |
| Toetredingsvoorwaarde | De lijst met master-to-detail poortparen wordt vergeleken met de gelijkheidsoperator. Verschillende voorwaarden worden gecombineerd met AND. |
| Gesorteerde invoer | Geeft aan dat beide pipelines al gesorteerd aankomen op basis van de conditiepoorten, waardoor de integratieservice de schijfinvoer en -uitvoer kan minimaliseren. |
| Hoofdsorteervolgorde | De sorteervolgorde van de brongegevens, die samen met de gesorteerde invoer wordt gebruikt. |
| Cachemap | De map waarin de index- en datacachebestanden worden aangemaakt. De standaardlocatie is de procesvariabele $PMCacheDir. |
| Grootte van de Joiner-gegevenscache | Grootte van de datacache met de hoofdrijgegevens. De standaardwaarde is 'Automatisch', waardoor de Integration Service de grootte hiervan bepaalt. |
| Grootte van de Joiner-indexcache | Grootte van de indexcache die de hoofdconditiewaarden bevat. De standaardwaarde is Auto. |
| Transformatiebereik | Past de join toe op elke transactie, op alle binnenkomende gegevens of op een rijniveau. |
Gesorteerde invoer is de instelling die het meest geschikt is om als eerste te gebruiken. Wanneer beide pipelines in de juiste volgorde aankomen, gesorteerd op basis van de conditiepoorten, hoeft de Integration Service niet de volledige masterbron vast te houden voordat het matchen begint. Dit is hetzelfde principe dat wordt toegepast tijdens... prestatieafstemming van andere in de cache opgeslagen transformaties.
Regels en beperkingen voor Joiner-transformatie
Sommige beperkingen komen pas aan het licht wanneer de kaartping is gevalideerd, dus het is goedkoper om ze te kennen voordat de poorten worden gekoppeld.
- Alleen gelijkheid. Een joinvoorwaarde vergelijkt poorten met de gelijkheidsoperator. Vergelijkingsoperatoren zoals groter dan, kleiner dan of niet gelijk aan worden niet geaccepteerd in de voorwaarde.
- Overeenkomende gegevenstypen. Beide poorten in een voorwaarde moeten hetzelfde gegevenstype hebben. De Designer valideert dit, dus kolommen met een verschillend gegevenstype moeten eerst worden geconverteerd, meestal in een Expression-transformatie.
- Geen update-strategie stroomopwaarts. Een Joiner-transformatie kan niet worden gebruikt wanneer een van de invoerpijplijnen een Update Strategy-transformatie bevat.
- Geen volgorde Generator vlak ervoor. Een reeks verbinden Generator Transformaties direct vóór de Joiner worden niet ondersteund.
- Caching kan niet worden uitgeschakeld. De hoofdpipeline wordt altijd in de cache opgeslagen, daarom hoort de kleinere bron aan de hoofdkant thuis en is de cachegrootte belangrijk bij grote joins.
Het samenvoegen van drie bronnen vereist twee aan elkaar gekoppelde Joiner-transformaties, omdat elke transformatie precies één master- en één detail-pipeline accepteert. Wanneer de tweede bron een kleine referentietabel is die rij voor rij wordt ingelezen, is een Lookup-transformatie Het eenvoudigere ontwerp is vaak de beste optie.
