
Apache Solr-zelfstudie: Wat is Solr? Architectuur
 David Carter
⚡ Slimme samenvatting
Apache Solr is een open-source, JavaEen op Apache Lucene gebaseerde zoekserver. Deze indexeert grote hoeveelheden tekstgerichte data en levert relevante resultaten via REST API's. De server biedt full-text zoeken, facetten, schaalbaarheid en zowel standalone als SolrCloud-implementatiemodi.
Wat is Apache Solr?
Apache Solr is een open-source zoekserverplatform waarin is geschreven Java taal door Apache software foundation. Het is zeer schaalbaar en klaar om te implementeren zoekmachine om een groot volume aan tekstgerichte data te verwerken. Het doel van het gebruik van Apache Solr is om grote hoeveelheden webcontent te indexeren en te doorzoeken en relevante content te geven op basis van de zoekopdracht.
Apache Solr is een REST-API gebaseerde HTTP wrapper rond de full-text zoekmachine genaamd Apache Lucene. Een inverted index is een lijst met woorden waarbij elke woordvermelding linkt naar de documenten waarin het is opgeslagen. Op die manier worden alle documenten voor de zoekopdracht "guru99" opgehaald met een eenvoudige 'get'-bewerking.
Geschiedenis van Apache Solr
- 1999: Doug Cutting publiceerde Lucene
- 2004: Solr werd bij CNET ontwikkeld door Yonik Seeley als een intern bedrijfsproject
- 2006: CNET publiceert de broncode door deze te doneren aan de Apache-software Foundation
- 2008: Solr 1.3 werd uitgebracht met verbeterde zoekmogelijkheden en prestatieverbeteringen
- 2010: Fusie van Lucene en Solr
- 2012: Solr versie 4.0 werd uitgebracht, met nieuwe Solr Cloud-functie
- 2016: Solr 6.0 werd uitgebracht en biedt ondersteuning voor de uitvoering van parallelle SQL-query's
- 2017: Solr 7.0 werd uitgebracht, met een framework voor automatisch schalen en de JSON Facet API.
- 2019: Solr 8.0 werd uitgebracht met ondersteuning voor geneste documenten en verbeterde streaming-expressies.
- 2021: Lucene en Solr gingen opnieuw uit elkaar en Solr werd een onafhankelijk Apache-topniveauproject.
- 2022: Solr 9.0 werd uitgebracht als de eerste versie die onafhankelijk was van Lucene, met toevoeging van vector search en Kubernetes-ondersteuning.
- 2026: Solr 10.0 werd uitgebracht als de nieuwste belangrijke versie.
Kenmerken van Apache Solr
Hier zijn belangrijke kenmerken van Apache Solr:
- Automatische taakverdeling
- Op standaarden gebaseerde open interfaces – XML, JSON en HTTP
- Aanbevelingen en spellingsuggesties worden ondersteund
- Ondersteuning voor automatisch aanvullen en georuimtelijk zoeken
- Ingebouwde beveiliging voor authenticatie en autorisatie
- Hiermee kunt u een meertalige zoekopdracht op trefwoorden uitvoeren
- Automatisch aanvullen/type-ahead-voorspelling
- Batch- en streamingverwerking
- Het bouwen van machine-learning-modellen is eenvoudig
- Speciaal geoptimaliseerd voor groot volume webverkeer
- Uitgebreide HTML-bewonderingsinterfaces
- Ondersteunt zowel schema- als schemaloze configuratie
- Gefacetteerd zoeken en filteren
- Centrale configuratie voor geheel Cluster
Belangrijkste termen die worden gebruikt in Apache Solr
In deze Solr-zoekmachine-tutorial leren we nu over de belangrijkste termen die in Apache Solr worden gebruikt:
| Belangrijke term | Beschrijving |
|---|---|
| Solr Kern | Een Solr Core kan worden gedefinieerd als een index van teksten en velden die zijn afgeleid van alle documenten. Eén Solr-instantie kan één of meerdere Solr Cores bevatten. Core = een instantie van Lucene Index + Solr-configuratie |
| Solr-instantie | Solr Instance is een instance waarin Solr draait in de Java Virtuele machine (JVM). In de standalone-modus biedt het slechts één exemplaar, terwijl u in de cloudmodus één of meer exemplaren kunt hebben. |
| Indexeren | Indexeren is een methode voor het toevoegen van de inhoud van documenten aan Solr Index. Apache Solr maakt gebruik van de Apache Lucene Inverted Index-techniek. |
| Document | Het is een groep velden en hun waarden. Een document is een basiseenheid van gegevens die zijn opgeslagen in Apache Core. Eén Apache-kern kan een of meer documenten bevatten. |
| Veld | Een veld is een sleutel-waardepaar dat de daadwerkelijke gegevens in een document opslaat. De sleutel specificeert de veldnaam en de waarde bevat de gegevens van dat veld. Een document kan één of meerdere velden bevatten. Apache Solr gebruikt het veld om de inhoud van het document te indexeren. |
| Rustgevende API's | Om met Solr te communiceren is het niet nodig om gebruik te hebben gemaakt van Java programmeren. In plaats daarvan biedt Apache Solr rustgevende diensten om ermee te communiceren. U kunt documenten verzenden en resultaten ontvangen in verschillende bestandsformaten, zoals JSON, XML en CSV. |
| Zoek volledige text | Solr biedt functies voor zoeken in volledige tekst, zoals tokens, zinsdelen, spellingcontrole, automatisch aanvullen, jokertekens, enz. |
| Beheerdersinterface | Solr biedt een eenvoudig te gebruiken, gebruiksvriendelijke, functionele gebruikersinterface. Met behulp van de interface kunt u taken uitvoeren zoals het beheren van logboeken, het toevoegen, verwijderen, bijwerken en zoeken van documenten. |
| Tekstgericht en gesorteerd op relevantie | Apache Solr wordt gebruikt om tekstdocumenten te doorzoeken en de resultaten worden geleverd op basis van de zoekopdracht van de gebruiker. |
| Knooppunt | In de Solr-cloud staat elke afzonderlijke instantie bekend als een knooppunt. |
| Cluster | Een cluster is een verzameling knooppunten. |
| Collectie | Een cluster heeft een logische index, die ook wel een verzameling wordt genoemd. |
| scherf | Het is een klein deel van de collectie dat enkele of meerdere replica's van de index biedt. |
| Replica | Een replica is een kopie van Shard die in een knooppunt wordt uitgevoerd. |
| Leider | Het is een replica van de scherf, die de verzoeken van de Solr Cloud voor de rest van de replica's verzendt. |
Apache Solr Architectuur
Laten we nu in deze Solr-zoektutorial meer leren over Apache Solr Archistructuur:

Apache Solr compromitteert de volgende componenten
Vraag
De queryparser analyseert de query's die u aan Solr wilt doorgeven. Hij controleert uw query op syntactische fouten. Na het analyseren van de query's vertaalt hij deze naar een formaat dat Lucene herkent.
Verzoek behandelaar
Verzoeken die naar Apache Solr worden verzonden, worden verwerkt door de verzoekafhandelaar. Het verzoek kan een queryverzoek of een verzoek om een index bij te werken zijn. U moet de verzoekafhandelaar selecteren op basis van uw vereisten. Om een verzoek naar Solr door te sturen, moet u de afhandelaar koppelen aan een specifieke functie. URL eindpunt.
antwoord Writer
Een antwoordschrijver genereert opgemaakte uitvoer voor invoerquery's. Het ondersteunt verschillende formaten zoals XML, JSON, CSV.etc. Mogelijk hebt u verschillende antwoordschrijvers voor verschillende soorten verzoeken.
Behandelaar bijwerken
Wanneer je een updateverzoek naar Apache Solr stuurt, wordt dit verwerkt door een reeks plugins, handtekeningen, logging en indexering. Dit proces staat bekend als de updateverzoekprocessor. De updatehandler is ook verantwoordelijk voor wijzigingen zoals het toevoegen of verwijderen van gegevens.ping ingediend, enz.
Apache Solr-applicaties
| Toepassing | Gebruik |
|---|---|
| Intranetportaal |
|
| Federatieve klant |
|
| Instrumentgegevenssets |
|
| Wettelijke documenten |
|
| Ingebed in PLM-applicatie |
|
Hoe installeer ik Apache Solr?
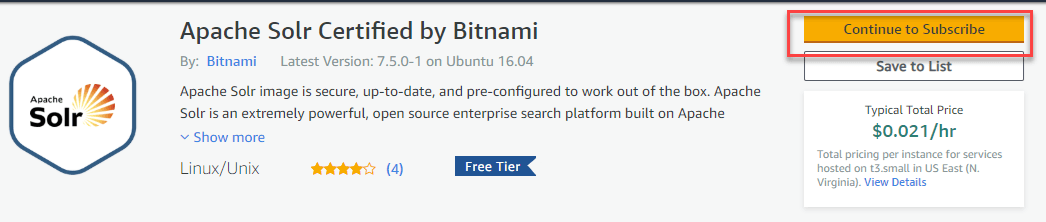
Stap 1) Website openen en doorgaan met abonneren
Ga hier naartoe link, Klik op 'Doorgaan met abonneren'.
Stap 2) Klik op Voorwaarden accepteren
Op de volgende pagina klikt u op Voorwaarden accepteren.

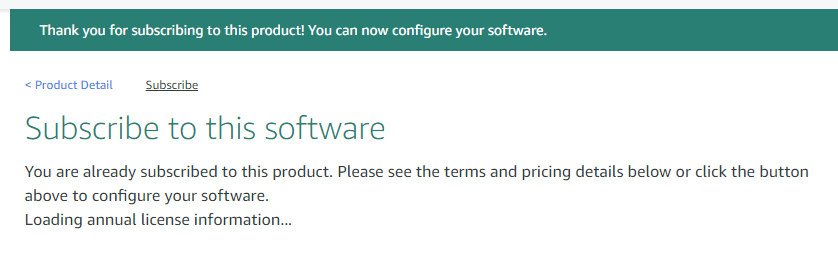
Stap 3) Wacht even
Wacht vervolgens enige tijd en vervolgens wordt het verzoek na enige tijd geaccepteerd.
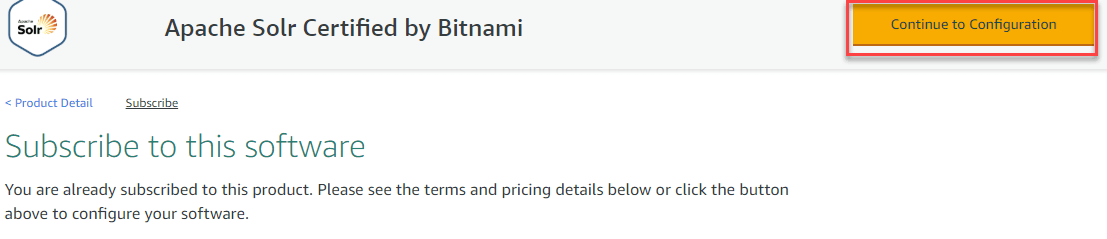
Stap 4) Doorgaan naar Configuratie
Ververs de pagina en klik op “Doorgaan naar configuratie”
Stap 5) Doorgaan met starten
Houd de standaardinstellingen en klik op 'Doorgaan met starten'.

Stap 6) Houd de instellingen standaard
Op de volgende pagina: Houd de instellingen standaard
- Zorg ervoor dat u het pem-bestand van de sleutel hebt
- Klik op “Starten”

U zult dit succesbericht zien

Stap 7) Let op de openbare DNS
Noteer in de EC2-console de openbare DNS van uw exemplaar

Stap 8) Open hieronder URL
Om toegang te krijgen tot Solr, gebruikt u eenvoudigweg de URL
http://publicdns:8983
in ons geval wordt het
http://ec2-18-221-175-53.us-east-2.compute.amazonaws.com:8983
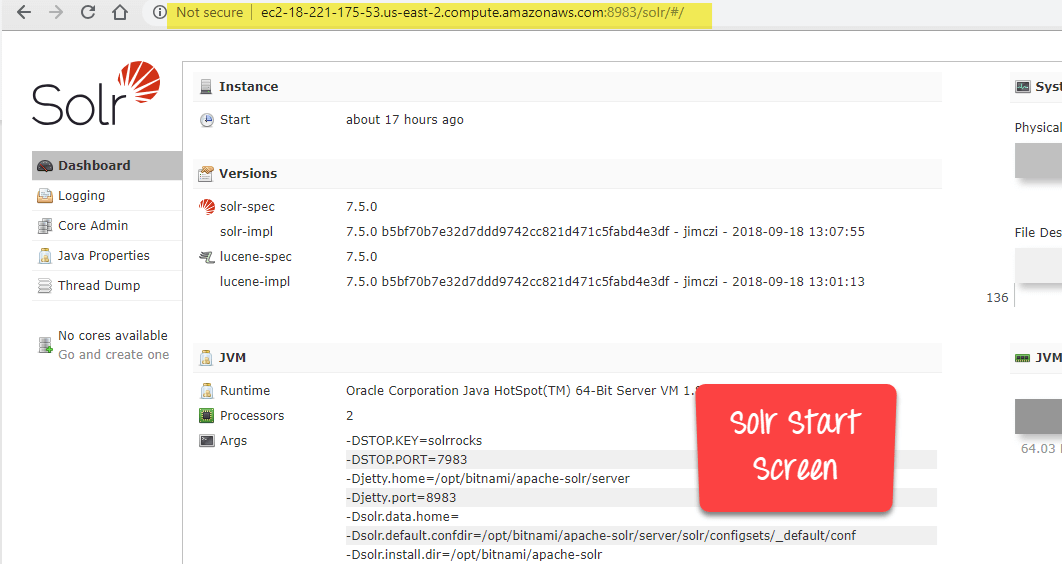
Opmerking: als u problemen ondervindt bij de toegang tot de instantie, wijzigt u de regels voor inkomende en uitgaande verbindingen in uw instantie om al het verkeer toe te staan, zoals weergegeven in het onderstaande Solr-queryvoorbeeld:

Elasticsearch versus. Apache Solr
| Kenmerken | Apache Solr | Elastisch zoeken |
|---|---|---|
| Natuur en wandelen | Het is een open source-project. | Geen opensourceproject. |
| Statische status | Statisch in shema.xml | Statisch in elasticsearch.yml |
| Formaat | XML, CSV, JSON | Alleen JSON |
| Index | Kan tijdens runtime opnieuw worden geladen met collection/core reload | Gedefinieerd tijdens het maken van index/type met een REST-aanroep |
| Documentatie | Het is goed gedocumenteerd. | Het is slecht gedocumenteerd. |
| Scherven splitsen | Mogelijk | Niet mogelijk |
Voordelen van Apache Solr
- Helpt u de hoeveelheid tijd te verminderen die nodig is om informatie te vinden
- Het is een snelle, eenvoudige, krachtige en flexibele zoekmachine.
- Helpt u om uw producten en diensten toegankelijker te maken
- Verhoog de klantuitgaven aan een webapplicatie
- Helpt u de gebruikerservaring op de webapplicatie te verbeteren om de omzet en winst te verhogen
- Uitgebreide op HTML gebaseerde beheerinterface
- Flexibel en aanpasbaar met XML-configuratie
- Uitbreidbare plug-in Architectuur
- Zeer schaalbare, robuuste, fouttolerante zoekmachine
- Ondersteunt gedistribueerd, schaduw, replicatie, Clustering en Multi-Node Architectuur
Nadelen van Apache Solr
- Het is geen ACID-compatibele gegevensopslag
- Het is niet nuttig als primaire gegevensopslag. Alleen nuttig als secundaire gegevensopslag
- Biedt geen ondersteuning voor transacties en gedistribueerde transacties
- Geen ondersteuning voor joins en complexe query's
- Niet optimaal voor genormaliseerde gegevens
