
Datawarehouse Archistructuur, componenten en diagram Concepts
 David Carter
⚡ Slimme samenvatting
Datawarehouse ArchiDe structuur definieert hoe historische en cumulatieve gegevens uit vele bronnen worden georganiseerd in gelaagde structuren en verbonden componenten, waardoor betrouwbare rapportage, analyse en een eenduidige bron van waarheid mogelijk worden voor besluitvorming en prognoses binnen een organisatie.
Datawarehouse Concepts
A datawarehouse Het doel ervan is om een bedrijf één betrouwbare bron van informatie te bieden voor besluitvorming en prognoses. Het is een informatiesysteem dat historische en cumulatieve gegevens bevat, afkomstig uit één of meerdere bronnen.
Door die gegevens te organiseren voor analyse in plaats van voor transacties, vereenvoudigt een datawarehouse het rapportage- en analysewerk van een hele organisatie.
Kenmerken van datawarehouse
Een datawarehouse heeft vier bepalende kenmerken die het onderscheiden van een gewone operationele database:
- Onderwerpgericht
- geïntegreerde
- Tijd variant
- Niet-vluchtig
Onderwerpgericht
Een datawarehouse is themagericht omdat het informatie levert over een specifiek thema in plaats van over de lopende activiteiten van een bedrijf. Typische thema's zijn bijvoorbeeld verkoop, marketing en distributie.
In plaats van de dagelijkse verwerking legt het datawarehouse de nadruk op modellering en analyse ter ondersteuning van besluitvorming. Het biedt een eenvoudig en beknopt overzicht van elk onderwerp en laat gegevens weg die het besluitvormingsproces niet ondersteunen.
geïntegreerde
Integratie is nauw verbonden met onderwerporiëntatie. In een datawarehouse betekent integratie het vaststellen van een gemeenschappelijke meeteenheid voor alle vergelijkbare gegevens uit verschillende databases, en het opslaan van die gegevens op een gemeenschappelijke, universeel aanvaardbare manier.
Een datawarehouse wordt opgebouwd door gegevens uit diverse bronnen te integreren, zoals een mainframe, relationele databases en platte bestanden. Het moet bovendien consistente naamgevingsconventies, formaten en codering hanteren.
Deze consistentie in naamgeving, attribuutmetingen en coderingsstructuur maakt effectieve analyse mogelijk. Neem bijvoorbeeld het volgende:
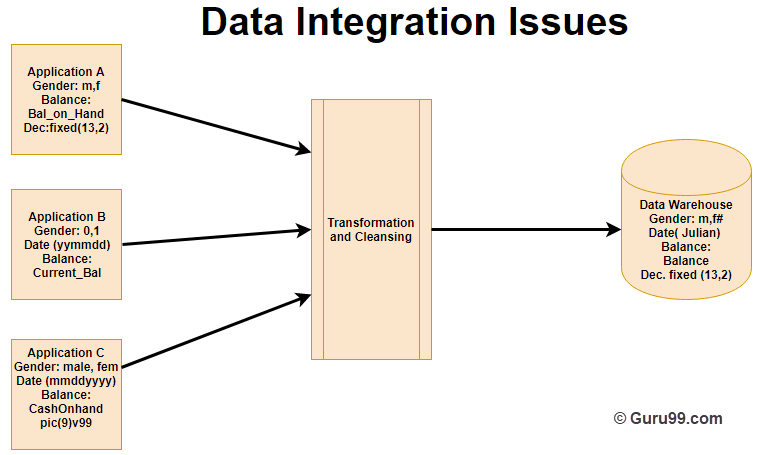
In het bovenstaande voorbeeld slaan drie applicaties, aangeduid met A, B en C, elk gegevens op over geslacht, datum en saldo, maar elke applicatie doet dit op een andere manier:
- Applicatie A slaat het veld 'geslacht' op als logische waarden zoals M of F.
- Applicatie B slaat het veld 'geslacht' op als een numerieke waarde.
- Applicatie C slaat het veld 'geslacht' op als een tekenreeks.
- Dezelfde variatie geldt voor de velden Datum en Saldo.
Na het transformatie- en opschoningsproces worden al deze gegevens in een gemeenschappelijk formaat opgeslagen in het datawarehouse.
Tijd variant
De tijdshorizon van een datawarehouse is veel breder dan die van een operationeel systeem. De data wordt gekoppeld aan een specifieke periode en biedt een historisch perspectief, waardoor er altijd een tijdsaspect in terugkomt, expliciet of impliciet.
Een van de plaatsen waar deze tijdsvariatie zich voordoet, is in de structuur van de recordsleutel. Elke primaire sleutel in het datawarehouse moet een tijdselement bevatten, zoals de dag, week of maand.
Een ander aspect van tijdsvariatie is dat gegevens, zodra ze in het datawarehouse zijn ingevoerd, niet meer kunnen worden bijgewerkt of gewijzigd.
Niet-vluchtig
Een datawarehouse is ook niet-vluchtig, wat betekent dat eerdere gegevens niet worden gewist wanneer er nieuwe gegevens binnenkomen. De gegevens zijn alleen-lezen en worden periodiek vernieuwd, waardoor analisten historische gegevens kunnen bestuderen en begrijpen wat er is gebeurd en wanneer.
Omdat een datawarehouse geen transactieverwerking, herstel of gelijktijdigheidscontrole nodig heeft, worden de verwijderings-, update- en invoegactiviteiten die gangbaar zijn in een operationele applicatie, weggelaten. In een datawarehouse worden slechts twee data-bewerkingen uitgevoerd:
- Gegevens laden
- Toegang tot data
De onderstaande tabel laat enkele belangrijke verschillen zien tussen een operationele applicatie en een datawarehouse:
| Operationele toepassing | Datawarehouse |
|---|---|
| Complexe programma's moeten worden gecodeerd om ervoor te zorgen dat de gegevensupgradeprocessen de hoge integriteit van het eindproduct behouden. | Dit soort problemen doet zich niet voor omdat er geen gegevensupdate wordt uitgevoerd. |
| Gegevens worden in een genormaliseerde vorm geplaatst om minimale redundantie te garanderen. | Gegevens worden niet in genormaliseerde vorm opgeslagen. |
| De technologie die nodig is om problemen met transacties, gegevensherstel, terugdraaien en het oplossen van impassen op te lossen, is behoorlijk complex. | Het biedt relatieve eenvoud in technologie. |
Datawarehouse Architectuur
Datawarehouse ArchiDe structuur is complex omdat het systeem historische en cumulatieve gegevens uit meerdere bronnen opslaat. Er zijn drie benaderingen voor het opbouwen van de datawarehouse-lagen: eenlaags, tweelaags en drielaags.
Enkellaagsarchitectuur Het doel is om de hoeveelheid opgeslagen data te minimaliseren door redundantie te verwijderen. In de praktijk wordt het zelden gebruikt.
Tweelaagse architectuur Het scheidt de fysiek beschikbare bronnen van het datawarehouse. Het is niet gemakkelijk uitbreidbaar, ondersteunt minder eindgebruikers en kan verbindingsproblemen ondervinden vanwege netwerkbeperkingen.
Architectuur op drie niveaus is het meest gebruikte ontwerp voor een datawarehouse.
Het bestaat uit de bovenste, middelste en onderste lagen:
- Onderste niveau: De database van het datawarehouse vormt de onderste laag. Dit is doorgaans een relationeel databasesysteem, waarin de gegevens worden opgeschoond, getransformeerd en geladen met behulp van back-endtools.
- Middle-tier: De middelste laag is een OLAP-server die is geïmplementeerd met behulp van het ROLAP- of MOLAP-model. Deze presenteert een abstracHet systeem biedt een overzicht van de database en fungeert als intermediair tussen de eindgebruiker en de database.
- Bovenste laag: De bovenste laag is een front-end clientlaag. Deze bevat de tools en API's die worden gebruikt om verbinding te maken met het datawarehouse en er gegevens uit op te halen, zoals querytools, rapportagetools, beheerde querytools, analysetools en data mining-tools.
Datawarehouse-componenten
De componenten en de algehele architectuur van een datawarehouse werken samen zoals weergegeven in het onderstaande diagram.
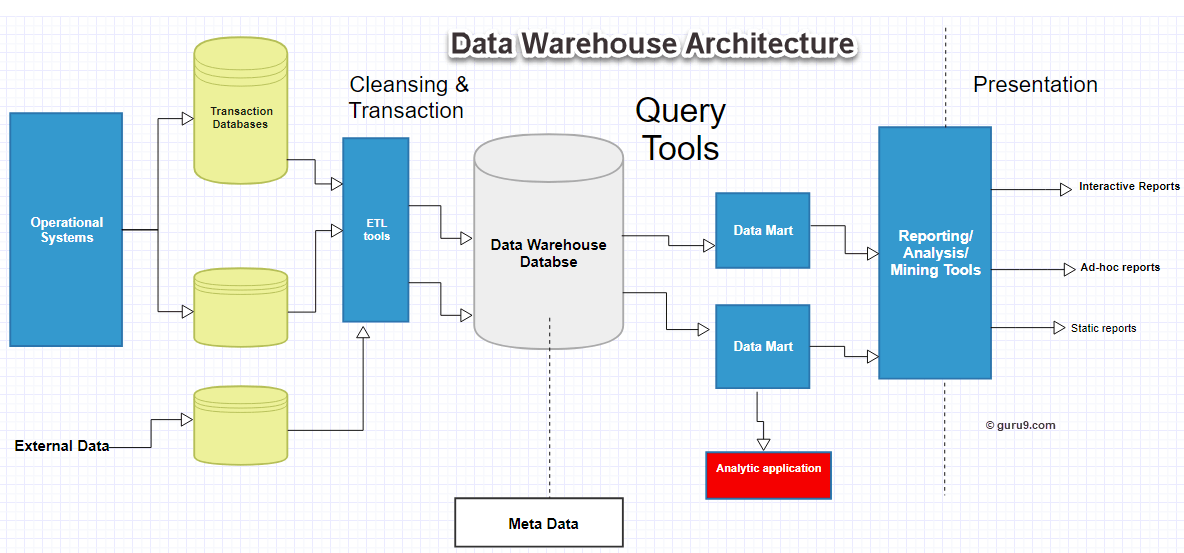
Het datawarehouse is gebaseerd op een RDBMS-server, een centrale informatieopslagplaats omgeven door belangrijke componenten die de gehele omgeving functioneel, beheersbaar en toegankelijk houden.
Een datawarehouse bestaat uit vijf hoofdonderdelen, die hieronder worden beschreven.
Data Warehouse-database
De centrale database vormt de basis van de datawarehouse-omgeving en is geïmplementeerd op RDBMS technologie. Omdat een traditioneel RDBMS is afgestemd op transactieverwerking in plaats van dataopslag, kunnen resource-intensieve bewerkingen zoals ad-hocquery's, joins tussen meerdere tabellen en aggregaties het systeem vertragen.
Om die reden worden alternatieve databasebenaderingen gebruikt:
- Relationele databases worden parallel ingezet om schaalbaarheid mogelijk te maken, waarbij gebruik wordt gemaakt van shared-memory- of shared-nothing-modellen op diverse multiprocessor- of massively parallel-configuraties.
- Er worden nieuwe indexstructuren gebruikt om het scannen van relationele tabellen te omzeilen en de snelheid te verbeteren.
- Multidimensionale databases (MDDB's) worden gebruikt om de beperkingen van relationele datawarehousemodellen te overkomen. Een voorbeeld hiervan is Essbase. Oracle.
Tools voor sourcing, acquisitie, opschoning en transformatie (ETL)
De tools voor data-acquisitie, -transformatie en -migratie voeren alle conversies, samenvattingen en wijzigingen uit die nodig zijn om data om te zetten naar een uniform datawarehouse-formaat. Ze worden ook wel Ex genoemd.tract, Transform, and Load (ETL) tools.
Hun functionaliteit omvat het volgende:
- Anonimiseer gegevens volgens wettelijke bepalingen.
- Verwijder ongewenste gegevens uit operationele databases voordat ze in het magazijn worden geladen.
- Zoek en vervang algemene namen en definities voor gegevens die uit verschillende bronnen komen.
- Bereken samenvattingen en afgeleide gegevens.
- Vul ontbrekende gegevens aan met standaardwaarden.
- Verwijder dubbele gegevens afkomstig van meerdere bronnen.
Deze ETL-tools Kan cronjobs, achtergrondtaken, Cobol-programma's en shellscripts genereren die het datawarehouse regelmatig vernieuwen en helpen bij het onderhouden van de metadata.
Omdat ETL-tools gebruikmaken van gegevens uit veel verschillende systemen, moeten ze ook omgaan met heterogeniteit in databases en data.
Metadata
Metadata klinkt misschien geavanceerd, maar het is simpelweg data over data die het datawarehouse definieert. Het wordt gebruikt om het datawarehouse te bouwen, te onderhouden en te beheren.
Binnen de architectuur specificeert metadata de bron, het gebruik, de waarden en de kenmerken van de data en definieert hoe de data kan worden gewijzigd en verwerkt, zodat deze nauw verbonden blijft met het datawarehouse.
Een regel in een verkoopdatabase kan bijvoorbeeld het volgende bevatten:
4030 KJ732 299.90
Dit is betekenisloos totdat de metadata uitlegt dat het een modelnummer van 4030, een verkoopagent-ID van KJ732 en een totaal verkoopbedrag van $299.90 vertegenwoordigt.
Metadata is daarom een essentieel ingrediënt om data om te zetten in kennis, en het helpt bij het beantwoorden van vragen zoals:
- Welke tabellen, attributen en sleutels bevat het datawarehouse?
- Waar kwamen de gegevens vandaan?
- Hoe vaak worden de gegevens opnieuw geladen?
- Welke transformaties en reinigingen werden toegepast?
Metadata valt in twee categorieën uiteen:
- Technische metagegevens: Dit beschrijft het datawarehouse voor de ontwerpers en beheerders die het bouwen en beheren.
- Zakelijke metagegevens: Dit biedt eindgebruikers een eenvoudige manier om de in het datawarehouse opgeslagen informatie te begrijpen.
Queryhulpmiddelen
Een belangrijk doel van datawarehousing is om bedrijven de informatie te verschaffen die ze nodig hebben om strategische beslissingen te nemen, en querytools zijn de manier waarop gebruikers met het systeem interageren.
Deze hulpmiddelen vallen in vier categorieën:
- Query- en rapportagetools
- Hulpprogramma's voor applicatie-ontwikkeling
- Tools voor datamining
- OLAP-hulpmiddelen
Query- en rapportagehulpmiddelen
Query- en rapportagetools kunnen worden onderverdeeld in twee groepen: rapportagetools en beheerde querytools.
Rapportagetools verder onderverdeeld in tools voor productierapportage en desktoprapportageprogramma's:
- Rapportschrijvers: Deze zijn ontworpen voor eindgebruikers die hun eigen analyses samenstellen.
- Productierapportage: Deze tools stellen organisaties in staat om regelmatig operationele rapporten te genereren en ondersteunen batchtaken met een hoog volume, zoals printen en berekenen. Populaire voorbeelden zijn Brio en Business Objects. Oracle, PowerSoft en SAS Institute.
Beheerde queryhulpmiddelen Het helpt eindgebruikers door een meta-laag tussen de gebruiker en de database te plaatsen, die de complexiteit van SQL en de databasestructuur verbergt.
Hulpmiddelen voor applicatieontwikkeling
Wanneer de ingebouwde grafische en analytische tools niet voldoen aan de analytische behoeften van een organisatie, worden aangepaste rapporten gemaakt met behulp van tools voor applicatieontwikkeling.
Hulpmiddelen voor datamining
Datamining ontdekt betekenisvolle nieuwe correlaties, patronen en trends in grote hoeveelheden data, en dataminingtools automatiseren die ontdekking.
OLAP-tools
OLAP De tools zijn gebouwd op een multidimensionale database en stellen gebruikers in staat gegevens te analyseren via uitgebreide, multidimensionale weergaven.
Data Warehouse Bus Architectuur
De datawarehousebus bepaalt hoe gegevens door het datawarehouse stromen. Die stroom kan worden onderverdeeld in inkomende, opwaartse, neerwaartse, uitgaande en meta-stromen.
Bij het ontwerpen van de bus moet rekening worden gehouden met de gedeelde dimensies en feiten die in verschillende data marts voorkomen.
Datamarts
A data mart Een datamart is een toegangslayer die wordt gebruikt om data aan gebruikers te leveren. Het is geschikt voor grote datawarehouses omdat de bouw ervan minder tijd en geld kost, hoewel er geen eenduidige definitie van een datamart bestaat.
Simpel gezegd is een datamart een onderdeel van een datawarehouse. Het verdeelt gegevens voor een specifieke groep gebruikers en kan zich in dezelfde database als het datawarehouse bevinden of in een fysiek aparte database.
Datawarehouse Archibeste praktijken
Om een degelijke datawarehouse-architectuur te ontwerpen, volg je de onderstaande best practices:
- Gebruik datawarehousemodellen die geoptimaliseerd zijn voor het ophalen van informatie, ongeacht of het gaat om een dimensionale, gedenormaliseerde of hybride aanpak.
- Kies een geschikte ontwerpbenadering, ofwel top-down of bottom-up.
- Zorg ervoor dat gegevens snel en nauwkeurig worden verwerkt en samengevoegd tot één betrouwbare versie van de informatie.
- Ontwerp het data-acquisitie- en opschoningsproces voor het datawarehouse zorgvuldig.
- Ontwerp een metadata-architectuur die het mogelijk maakt om metadata te delen tussen de componenten van het datawarehouse.
- Overweeg een OperaHet nationale dataopslagmodel (ODS) wordt gebruikt wanneer de ophaalbehoeften zich bijna onderaan de data-abs bevinden.traceen piramide van operationele bronnen of wanneer er toegang nodig is tot meerdere operationele bronnen.
- Zorg ervoor dat het datamodel geïntegreerd is in plaats van slechts geconsolideerd; gebruik in dat geval een 3NF-datamodel, wat ook ideaal is bij de aanschaf van ETL- en dataopschoningstools.
