
SAP HANA Architecture: Databaseoverzicht
 Redactie
⚡ Slimme samenvatting
SAP HANA ArchiStructuur, Landschap en Grootte vormen de basis van een in-memory dataplatform gebouwd op SUSE Linux. C++Dit artikel beschrijft de indexserver, opslagengines, rij- en kolomopslag, delta-merge en methoden voor het bepalen van de hardwareconfiguratie.
Wat is SAP HANA-database?
SAP HANA is een datamanagementplatform dat voornamelijk in het hoofdgeheugen is opgeslagen. De database draait op SUSE Linux Enterprise Server (SLES) en Red Hat Enterprise Linux (RHEL) en is geschreven in C++Het kan worden opgeschaald over meerdere machines voor zeer grote werklasten.
Belangrijkste voordelen van: SAP HANA:
- Extreem snelle queryprestaties doordat alle gegevens in het geheugen worden geladen, waardoor trage schijf-I/O niet langer een cruciale rol speelt.
- Een combinatie van OLAP (Online Analytical Processing) en OLTP (Online Transaction Processing) in dezelfde database, wat het datalandschap vereenvoudigt.
SAP De HANA-database is opgebouwd uit een set in-memory verwerkingsengines. De Calculation Engine is de belangrijkste en communiceert met andere engines, zoals de Relational Engine (rij- en kolomopslag), de OLAP Engine, de Text Engine en de Graph Engine. Een relationele tabel bevindt zich in de rijopslag of de kolomopslag, en extra engines verwerken tekst- en grafiekgegevens zolang er geheugen beschikbaar is.
SAP HANA Architectuur
De gegevens in de kolomopslag worden gecomprimeerd met behulp van technieken zoals dictionary encoding, run-length encoding, sparse encoding, cluster encoding en indirect encoding. Wanneer de limiet van het hoofdgeheugen is bereikt, worden databaseobjecten die niet in gebruik zijn (tabellen, views, enz.) automatisch naar de schijf weggeschreven en opnieuw geladen wanneer ze opnieuw worden opgevraagd.
Beheerders kunnen een individuele tabel ook handmatig laden of ontladen door met de rechtermuisknop op de tabel te klikken. SAP HANA Studio en kiezen Lossen or Laden.
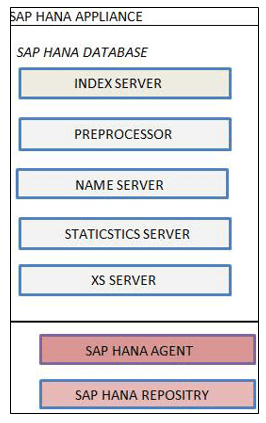
SAP De HANA-server bestaat uit:
- Indexserver
- Preprocessor-server
- Name Server
- Statistiekenserver
- XS-motor
1. SAP HANA-indexserver
De indexserver is de belangrijkste SAP HANA-databasecomponent:
- Het is het hart van de SAP HANA-database-engine.
- Het bevat de daadwerkelijke gegevensopslag en de systemen die de gegevens verwerken.
- Het voert binnenkomende SQL- en MDX-instructies uit.
De architectuur van de indexserver wordt hieronder weergegeven.

SAP HANA Index Server-overzicht
- Sessie- en transactiebeheerder: De sessiecomponent beheert verbindingen en sessies voor de database. De transactiemanager coördineert en controleert alle transacties.
- SQL- en MDX-processor: De SQL-processor stuurt query's naar de juiste engine (SQL / SQL-script / R / rekenengine). De MDX-processor verwerkt multidimensionale query's (bijvoorbeeld op een analytische weergave).
- SQL / SQL-script / R / Calc-engine: Voert SQL, SQL-scripts, R en rekenmodellen uit op de gegevens.
- repository: Onderhoudt versiebeheer voor SAP HANA-metadataobjecten zoals attribuutweergaven, analytische weergaven en opgeslagen procedures.
- Persistentielaag: Biedt ingebouwde mogelijkheden voor noodherstel door savepoints en logboeken naar het gegevensvolume op de schijf te schrijven.
2. Preprocessor-server
De preprocessor-server wordt gebruikt door tekstanalyse. Deze wordt gebruikt voor...tracts bereidt gegevens voor uit tekstuele inhoud wanneer de zoekfunctie wordt aangeroepen.
3. Naamserver
De naamserver bevat informatie over het gehele systeemlandschap. In een gedistribueerde implementatie is deze tracks registreert elk actief component en de locatie van gegevens op alle knooppunten, zodat query's naar de juiste server kunnen worden doorgestuurd.
4. Statistiekenserver
De statistiekenserver verzamelt status-, resourceallocatie-, verbruiks- en prestatiegegevens voor de SAP HANA-systeem. Opmerking: in HANA SPS 7 en later draait de ingebouwde statistiekenservice binnen de indexserver in plaats van als een zelfstandig proces.
5. XS-server
De XS Server host de XS Engine, waarmee externe applicaties en ontwikkelaars de XS Engine kunnen gebruiken. SAP HANA-database via HTTP. De XS Engine zelf fungeert als een lichtgewicht HTTP-server, waardoor browsergebaseerde en REST-clients rechtstreeks met HANA kunnen communiceren.
SAP HANA-landschap
“HANA” staat voor Hoogwaardig analytisch apparaat en wordt geleverd als een gecombineerd hardware- en softwareplatform.
- Moderne hardware biedt veel meer CPU-cores, RAM en opslagbandbreedte dan waarvoor traditionele databaseservers ontworpen waren.
- SAP HANA maakt hier gebruik van door keeping Alle werkgegevens bevinden zich in het hoofdgeheugen, waardoor het knelpunt van de schijf-I/O, dat traditionele databases beperkt, wordt geëlimineerd.
Onderstaand diagram geeft een samenvatting van de SAP HANA hardware- en software-innovaties.

SAP HANA ondersteunt twee relationele datastore-typen: Rij winkel en Kolomwinkel.
Rij winkel
Row Store gedraagt zich als een traditionele database (Oracle(SQL Server). Het belangrijkste verschil is dat alle rijen zich in het hoofdgeheugen bevinden in SAP HANA bewaart ze, terwijl een traditionele database ze voornamelijk op schijf opslaat.
Kolomwinkel
Column Store bewaart gegevens in kolomvorm in het geheugen. Kolomtabellen worden hier opgeslagen en de engine zorgt voor een goede balans tussen schrijfprestaties en geoptimaliseerde leesprestaties. Het onderstaande diagram toont de twee structuren die deze balans bereiken.

Hoofd opslag
Het hoofdgeheugen bevat het grootste deel van de gegevens. Compressiemethoden zoals dictionary encoding, cluster encoding, sparse encoding en run-length encoding worden toegepast om geheugen te besparen en zoekopdrachten te versnellen.
- Het rechtstreeks wijzigen van gecomprimeerde gegevens in het hoofdgeheugen is kostbaar, daarom zijn schrijfbewerkingen niet gericht op het hoofdgeheugen.
- In plaats daarvan wordt elke wijziging naar een apart gebied geschreven, genaamd Delta Opslag. Leesbewerkingen kunnen zowel het hoofdgeheugen als het delta-geheugen bereiken.
Gegevens kunnen handmatig worden geladen of ontladen met behulp van de In het geheugen laden en Ontladen uit het geheugen De onderstaande opties worden weergegeven.

Delta Opslag
Delta De opslag is geoptimaliseerd voor schrijfbewerkingen en maakt gebruik van lichtere compressie. Alle niet-opgeslagen wijzigingen in een kolomtabel worden hier bewaard. Wanneer wijzigingen moeten worden samengevoegd met de hoofdopslag, voert u de volgende stappen uit: Delta gaan operatie vanaf SAP HANA Studio.

- De delta-merge verplaatst de wijzigingen die in de delta-opslag zijn opgeslagen naar de hoofdopslag.
- Na de samenvoeging wordt de nieuwe hoofdinhoud van het geheugen op de schijf opgeslagen en wordt de compressie opnieuw berekend.
Hoe data zich verplaatst van Delta naar hoofdopslag

Een rijgeorganiseerde buffer genaamd L1-Delta Het bevindt zich vóór elke kolomtabel, waardoor een kolomtabel schrijfbewerkingen met een hoge doorvoer kan verwerken.
- De gebruiker voert een UPDATE- of INSERT-bewerking uit op de tabel.
- Gegevens komen eerst terecht in L1-Delta (niet-vastgelegde gegevens).
- Zodra de gegevens zijn vastgelegd, worden ze verplaatst naar de kolomgeoriënteerde L2-laag.Delta buffer.
- Wanneer L2-Delta Als het geheugen vol is of als de samenvoeging wordt uitgevoerd, worden de gegevens naar het hoofdgeheugen geschreven.
Kolomopslag is daarom zowel schrijfgeoptimaliseerd (via L1- en L2-delta) als leesgeoptimaliseerd (via het hoofdgeheugen). Na verwerking worden de gegevens door de persistentielaag naar de schijf opgeslagen.
Voorbeeld van een rijgebaseerde tabel:

Dezelfde logische tabel wordt op verschillende manieren op de schijf opgeslagen, afhankelijk van het opslagtype. In een rijenopslag worden rijen aaneengesloten weggeschreven:

In Column Store worden waarden uit dezelfde kolom bij elkaar opgeslagen:

Omdat kolomwaarden hetzelfde gegevenstype delen en vaak herhaald worden, comprimeert de kolomindeling extreem goed — wat het belangrijkste geheugenvoordeel is van de kolomopslag.

SAP HANA-maatvoering
Sizing is het proces waarbij de benodigde hardwarebronnen – RAM, schijf en CPU – voor een systeem worden vastgesteld. SAP HANA-systeem. Geheugen is de belangrijkste factor, de CPU komt op de tweede plaats en de schijfruimte is daarvan afgeleid.
In een SAP Bij de implementatie van HANA is het kiezen van de juiste servergrootte voor de bedrijfsworkload een van de meest cruciale taken. In vergelijking met een traditioneel DBMS verschilt de dimensionering van HANA op drie gebieden:
- Hoofdgeheugen: Dit wordt bepaald door metadata plus de hoeveelheid transactionele en analytische gegevens die in het geheugen zijn opgeslagen.
- CPU: Geschat in plaats van gemeten, gebaseerd op prognoses en belastingpatronen.
- Schijf: Gedimensioneerd voor gegevenspersistentie en logvolumes, niet voor online querygegevens.
De CPU en het geheugen van de applicatieserver blijven ongewijzigd ten opzichte van de vorige database, omdat HANA alleen de databaselaag vervangt.
SAP biedt verschillende methoden om de juiste maat te berekenen:
- Dimensionering met behulp van een ABAP-rapport (transactiecode) ST03 gegevens en rapport /SDF/HDB_SIZING).
- Dimensionering met behulp van een databasescript voor niet-ABAP-systemen.
- Maatvoering met behulp van de SAP Snel op maat gemaakt tool op de SAP Dienst Marktplaats.
Wanneer de Quick Sizer-tool wordt gebruikt, wordt de vereiste in onderstaand formaat weergegeven.

