
SAP DS (gegevensservices) in HANA
 Mason Garcia
⚡ Slimme samenvatting
SAP Data Services is het ETL-platform voor bedrijven dat gegevens uit heterogene bronnen verplaatst en opschoont. SAP HANA. Designer, Job Server, Engine, Repository en Access Server werken samen om dataflows te bouwen, in te plannen en uit te voeren.
Wat is SAP Gegevensdiensten?
SAP Data Services is een ETL-tool die een totaaloplossing op bedrijfsniveau biedt voor data-integratie, -transformatie, datakwaliteit, dataprofielering en tekstverwerking vanuit een heterogene bron naar een doeldatabase of datawarehouse.
Applicaties, ook wel taken genoemd, worden aangemaakt in de Designer, waar gegevens worden gekoppeld.ping en transformatie worden gedefinieerd. Het product wordt ook wel aangeduid als SAP BusinessObjects Data Services, afgekort tot SAP BODS, en beide namen beschrijven hetzelfde gereedschap. SAP Data Services 4.3 is de huidige release; versie 4.2 heeft op 31 mei 2023 het einde van de reguliere ondersteuning bereikt, dus nieuwe implementaties moeten beginnen met versie 4.3.
Binnen een SAP HANA-landschap, SAP Data Services is de optie die wordt gekozen wanneer gegevens tijdens de invoer moeten worden herschikt in plaats van ongewijzigd te worden gekopieerd. De onderstaande secties beschrijven wat de tool biedt, hoe de verschillende onderdelen samenwerken en een complete workload van een SAP ECC-tabel in SAP HANA.
Kenmerken van SAP Gegevensdiensten
De onderstaande mogelijkheden leggen uit waarom SAP Data Services is gepositioneerd als een platform van enterprise-niveau, en niet als een simpel kopieerprogramma.
- Het biedt hoogwaardige parallelle transformaties.
- Het beschikt over uitgebreide beheertools en een rapportagetool.
- Het ondersteunt meerdere gebruikers.
- SAP BODEN is zeer flexibel met op webservices gebaseerde applicaties.
- Het biedt de mogelijkheid voor een scripttaal met een uitgebreide set functies.
- SAP Data Services kunnen worden geïntegreerd met SAP LT-replicatieserver (SLT) Met behulp van triggergebaseerde technologie voegt SLT deltafunctionaliteit toe aan elk onderdeel. SAP of niet-SAP brontabel, waarmee wijzigingen in gegevens kunnen worden vastgelegd en delta-gegevens vanuit de brontabel kunnen worden overgedragen.
- Gegevensvalidatie met dashboards en procesauditing.
- Een beheertool met planningsmogelijkheden en monitoringdashboards.
- Foutopsporing, ingebouwde profilering en gegevensweergave.
- SAP Data Services ondersteunt een breed scala aan bronnen en doelen:
- Elke applicatie, bijvoorbeeld SAP.
- Elke database, met bulkladen en wijzigingsregistratie.
- Bestanden: vaste breedte, door komma's gescheiden, COBOL, XML en Excel.
Deze functionaliteiten worden geleverd door een kleine set installeerbare componenten, elk met een eigen functie.
Onderdelen van SAP Gegevensdiensten
SAP Data Services bestaat uit de onderstaande componenten.
- Designer – Het is een ontwikkeltool waarmee we een taak kunnen maken, testen en uitvoeren die een datawarehouse vult. Het stelt de ontwikkelaar in staat objecten te creëren en te configureren door een pictogram te selecteren in een stroomdiagram van bron naar doel. Het kan worden gebruikt om een applicatie te maken door workflows en gegevensstromen te specificeren. Om Data Services Designer te openen, gaat u naar Startmenu -> Alle programma's -> SAP Gegevensservices -> Ontwerper van gegevensservices.

- Jobserver Het is een applicatie die de Data Services-verwerkingsengine start en fungeert als interface naar de engine en de Data Services-suite.
- Motor De Data Services-engine voert de individuele taken uit die in de applicatie zijn gedefinieerd.
- bewaarplaats – De repository is een database die door Designer vooraf gedefinieerde objecten en door de gebruiker gedefinieerde objecten (bron- en doelmetadata, transformatieregels) opslaat. Er zijn twee soorten repositories:
- Lokale opslagplaats (gebruikt door Designer en Job Server).
- Centrale opslagplaats (gebruikt voor het delen van objecten en versiebeheer).
- Toegang tot server De toegangsserver verstuurt berichten tussen webapplicaties, de dataservices-jobserver en de engines.
- Beheerder – De webbeheerder biedt browsergebaseerd beheer van de resources van Data Services, zoals hieronder beschreven:
- Configureren, starten en stoppenping realtime diensten.
- Het plannen, bewaken en uitvoeren van batchtaken.
- Het configureren van de Job Server, Access Server en het gebruik van de repository.
- Gebruikers beheren.
- Het publiceren van batchtaken en realtime services via webservices.
- Adapters configureren en beheren.
Weten wat elk onderdeel doet, is slechts de helft van het verhaal. De onderstaande architectuur laat zien hoe ze met elkaar communiceren tijdens een belasting.
SAP Gegevensdiensten Architectuur
De Data Services-architectuur bestaat uit de volgende componenten:
- Centrale repository – deze wordt gebruikt voor repositoryconfiguraties naar jobservers, beveiligingsbeheer, versiebeheer en het delen van objecten.
- Designer – gebruikt om een project, taak, workflow en dataflow te creëren en uit te voeren.
- Lokale repository – hier kunt u taken, workflows en dataflows aanmaken, wijzigen en starten.
- Jobserver en -engine – deze beheert de taken.
- Access Server – deze wordt gebruikt om de realtime taken uit te voeren die door ontwikkelaars in de repositories zijn aangemaakt.
In de onderstaande afbeelding worden Data Services en de relaties tussen de componenten ervan weergegeven.

SAP BODEN Architectuur
Ontwerper raamdetail
De Designer is het onderdeel waar een ontwikkelaar de meeste tijd in doorbrengt, dus het is de moeite waard om de lay-out ervan als eerste te leren kennen. De details van elk onderdeel van de Data Services Designer worden hieronder beschreven:
- Werkbalk (gebruikt voor Openen, Opslaan, Terug, Valideren, Uitvoeren, enz.).
- Projectgebied (Bevat het huidige project, inclusief taken, workflows en gegevensstromen. In Data Services zijn alle entiteiten objecten.)
- Werkruimte (het toepassingsvenster waarin we objecten definiëren, weergeven en wijzigen).
- Lokale objectbibliotheek (Het bevat lokale repository-objecten, zoals transformaties, taken, workflows, gegevensstromen, enz.).
- Gereedschapspalet (Met de knoppen op het gereedschapspalet kunt u nieuwe objecten aan de werkruimte toevoegen.)

Objecthiërarchie
Het onderstaande diagram toont de hiërarchische relaties voor de belangrijkste objecttypen binnen Data Services.

Let op: De legenda hieronder geeft de optionele elementen in de hiërarchie weer.

Werkstromen en voorwaarden zijn optioneel.
De objecten die gebruikt worden in SAP De gegevensdiensten worden hieronder nader toegelicht.
| Objecten | Beschrijving |
|---|---|
| Project | Een project is het object op het hoogste niveau in het ontwerpvenster. Projecten bieden u een manier om de andere objecten die u in Data Services maakt te organiseren. Er is slechts één project tegelijk geopend, waarbij "open" betekent "zichtbaar in het projectgebied". |
| Job | Een "taak" is de kleinste werkeenheid die je onafhankelijk kunt inplannen voor uitvoering. |
| Scripts | Een subset van regels in een procedure. |
| Workflow | Een workflow is de integratie van verschillende datastromen in een samenhangend werkproces voor een complete taak. Een workflow is optioneel. Een workflow is een procedure die het volgende kan doen:
|
| Informatiestroom | Een 'dataflow' is het proces waarbij brongegevens worden omgezet in doelgegevens. Een dataflow is een herbruikbaar object. Het wordt altijd aangeroepen vanuit een workflow of een taak. Het wordt gebruikt om:
|
| DataStore | Een logisch kanaal dat gegevensservices verbindt met bron- en doeldatabases. Datastores:
|
| Target | De tabel of het bestand waarin Data Services gegevens vanuit de bron laadt. |
SAP Data Services versus SLT versus DXC
SAP Data Services is een van de vele gegevensvoorziening opties voor SAP HANA, en de keuze voor de verkeerde methode brengt extra kosten met zich mee die door geen enkele optimalisatie terug te verdienen zijn. De onderstaande tabel vergelijkt de drie server-side methoden.
| criteria | SAP Gegevensdiensten | SLT | DXC |
|---|---|---|---|
| Wachttijd | In batch of gepland | Real time | Batch, gepland door DataSource |
| Transformatie | Volledige ETL, opschoning en profilering | Eenvoudige filter- en veldregels | Niets meer dan extractor logica |
| Bronbereik | SAP en niet-SAP, bestanden, applicaties | SAP en niet-SAP databanken | SAP Alleen Business Suite |
| Extra server vereist | Ja, Job Server | Meestal wel | Nee |
| Het meest geschikt voor: | Datakwaliteit en consolidatie van meerdere bronnen | Operanationale rapportage over live data | Hergebruik van bestaande zakelijke content, bijvoorbeeldtracverdraaid |
Kortom, kies SAP Data Services is handig wanneer gegevens moeten worden opgeschoond, samengevoegd of gestandaardiseerd voordat ze worden verwerkt. Kies SLT wanneer het rapport de transactie moet weergeven zoals deze plaatsvindt. DXC wanneer een bewezen expert in zakelijke contenttracTor produceert al de semantiek die je nodig hebt. Voor een eenmalige dataset zonder herhalingsschema, een platte bestandsupload is sneller dan het configureren van elk van de drie.
Hoe laad ik gegevens vanuit een SAP Brontabel gebruiken SAP Gegevensdiensten
In Data Services is alles een object. Voor elke bron- en doeldatabase is een aparte datastore nodig.
De volledige procedure voor het laden van gegevens vanuit een SAP De brontabel staat hieronder. Elke stap wordt vervolgens in detail beschreven.
- Maak een datastore aan tussen de bron en BODS.
- Importeer de metadata (structuren) in BODS.
- Configureer de importserver
- Importeer de metadata in het HANA-systeem.
- Maak een datastore aan tussen BODS en HANA.
- Maak een project
- Een taak aanmaken (batch of realtime)
- Maak een werkstroom
- Creëer een gegevensstroom
- Voeg objecten toe aan de gegevensstroom.
- Voer de taak uit
- Bekijk de gegevenspreview in HANA.
Stap 1) Maak een datastore aan tussen de SAP bron en BODS.
- Om gegevens te laden vanuit een SAP bron in SAP HANA door SAP Voor BODS is een datastore vereist. We maken daarom eerst een datastore aan, zoals hieronder weergegeven: Project -> Nieuw -> Datastore

- Er verschijnt een pop-upvenster voor het aanmaken van een nieuwe datastore. Voer de onderstaande gegevens in:
- Voer de datastore-naam "ds_ecc" in.
- Selecteer de naam van het gegevensopslagtype als “SAP toepassingen".
- Voer de naam van de databaseserver in.
- Voer de gebruikersnaam en het wachtwoord in.
- Klik op de knop "Toepassen".
- Klik op de knop "OK".

- De datastore wordt aangemaakt. Bekijk de aangemaakte datastore zoals hieronder.
- Ga naar de lokale objectbibliotheek.
- Selecteer het tabblad Gegevensopslag.
- De datastore “ds_ecc” wordt weergegeven.

Stap 2) Importeer metadata (structuur) in de BODS-server.
We hebben een datastore aangemaakt voor ECC naar BODS; nu importeren we metadata van ECC naar BODS. Volg de onderstaande stappen om te importeren.
- Selecteer het datastore "ds_ecc" en klik met de rechtermuisknop.
- Selecteer de optie 'Importeren op naam'.

Er verschijnt een pop-upvenster voor importeren op naam. Voer de gegevens als volgt in:
- Selecteer Type als tabel.
- Voer de naam in van de tabel die u wilt importeren. In dit geval importeren we de tabel KNA1.
- Klik op de knop 'Importeren'. De KNA1-tabel verschijnt onder het knooppunt 'Tabel' van de gegevensbron 'ds_ecc'.

De tabelmetadata wordt als volgt in de datastore ds_ecc geïmporteerd.

Stap 3) Configureer de importserver.
Tot nu toe hebben we een tabel geïmporteerd in de datastore "ds_ecc" die is aangemaakt voor de ECC. SAP BODS-verbinding. Om gegevens te importeren in SAP HANAWe moeten de importserver configureren.
- Ga hiervoor naar Snel overzicht -> Importserver configureren zoals hieronder.

- Er verschijnt een pop-upvenster met de vraag 'Systeem selecteren'. Selecteer het systeem. SAP HANA-systeem (hier HDB) zoals hieronder weergegeven.

- Klik op de knop 'Volgende'. Er verschijnt een nieuw pop-upvenster voor de inloggegevens van Data Services. Voer de volgende gegevens in:
- SAP BODS-serveradres (hier BODS:6400).
- SAP Naam van de BODS-repository (naam van de HANAUSER-repository).
- ODBC-gegevensbron (ZTDS_DS).
- Standaardpoort voor de SAP BODS-server (8080).

Klik op de knop "Voltooien".
Stap 4) Importeer de metadata in het HANA-systeem.
De importserver is nu geconfigureerd, waardoor metadata kan worden geïmporteerd. SAP BODS-server.
- Klik op de optie 'Importeren' in het sneloverzicht.
- Er verschijnt een pop-upvenster met importopties. Selecteer de optie 'Selectieve import van metadata'.

Klik op de knop "Volgende".
Er verschijnt een pop-upvenster voor 'Selectieve import van metadata', waarin we het doelsysteem selecteren.
- Selecteer het SAP HANA-systeem (HDB in dit geval).

Klik op de knop "Volgende".
Stap 5) Maak een datastore aan tussen BODS en HANA.
In BODS is een aparte datastore nodig voor de bron en het doel. De brondatastore bestaat al, dus wordt er vervolgens een doeldatastore tussen BODS en HANA aangemaakt met de naam "DS_BODS_HANA".
- Ga naar Project -> Nieuw -> Datastore.
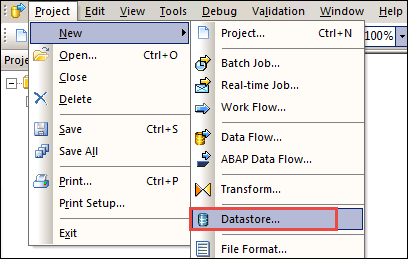
- Er verschijnt een scherm voor het aanmaken van een nieuwe datastore, zoals hieronder weergegeven.
- Voer de datastore-naam in (DS_BODS_HANA).
- Voer bij gegevensopslag 'Database' in.
- Voer het databasetype in als SAP HANA.
- Selecteer de databaseversie.
- Voer de SAP Naam van de HANA-databaseserver.
- Voer de poortnaam in voor de SAP HANA-database.
- Voer de gebruikersnaam en het wachtwoord in.
- Vink "Automatische gegevensoverdracht inschakelen" aan.

Klik op 'Toepassen' en vervolgens op de knop 'OK'.
De datastore “DS_BODS_HANA” wordt weergegeven onder het tabblad Datastore van de Lokale objectbibliotheek, zoals hieronder.

- Nu importeren we een tabel in de datastore “DS_BODS_HANA”.
- Selecteer het datastore “DS_BODS_HANA” en klik met de rechtermuisknop.
- Selecteer 'Importeren op naam'.

- Er verschijnt een pop-upvenster voor importeren op naam, zoals hieronder weergegeven.
- Selecteer Type als tabel.
- Voer de naam in als KNA1.
- Eigenaar wordt weergegeven als Hanauser.
- Klik op de knop 'Importeren'.

De tabel wordt geïmporteerd in de datastore “DS_BODS_HANA”. Volg de onderstaande stappen om de gegevens in de tabel te bekijken.
- Klik op de tabel “KNA1” in de datastore “DS_BODS_HANA”.
- De gegevens worden in tabelvorm weergegeven.

Stap 6) Definieer het project. Een project groepeert en organiseert gerelateerde objecten. Een project kan een willekeurig aantal taken, workflows en gegevensstromen bevatten.
- Ga naar het menu 'Ontwerpproject'.
- Selecteer de optie Nieuw.
- Selecteer de optie 'Project'.

Er verschijnt een pop-upvenster voor het aanmaken van een nieuw project, zoals hieronder weergegeven. Voer de projectnaam in en klik op de knop 'Aanmaken'. Er wordt een projectmap aangemaakt, in ons geval BODS_DHK.

Stap 7) Definieer de functie. Een taak is een herbruikbaar object. Het bevat workflows en gegevensstromen. Taken kunnen handmatig of volgens een schema worden uitgevoerd. Om een BODS-proces uit te voeren, moet een taak worden gedefinieerd.
We maken een taak aan met de naam JOB_Customer.
- Selecteer het project (BODS_DHK) dat in de vorige stap is aangemaakt, klik met de rechtermuisknop en selecteer 'Nieuwe batchtaak'.
- Hernoem het naar “JOB_Customer”.

Stap 8) Definieer de workflow.
- Selecteer de taak “JOB_Customer” in het projectgebied.
- Klik op de workflowknop in het gereedschapspalet. Klik op het lege werkgebied. Er verschijnt een workflowpictogram in het werkgebied.
- Wijzig de naam van de workflow in “WF_Customer”.

Klik op de naam van de workflow en er verschijnt een lege weergave voor de workflow in de werkruimte.

Stap 9) Definieer de gegevensstroom.
- Klik op de workflow “WF_Customer”.
- Klik op de knop 'Gegevensstroom' in het gereedschapspalet. Klik op het lege werkgebied. Er verschijnt een pictogram voor gegevensstroom in het werkgebied.
- Wijzig de naam van de gegevensstroom naar “DF_Customer”.
- De gegevensstroom wordt ook weergegeven in het projectgedeelte aan de linkerkant, onder de taaknaam.

Stap 10) Voeg objecten toe aan de gegevensstroom.
Binnen de dataflow geven we instructies om de brongegevens om te zetten naar de gewenste vorm voor de doeltabel.
Er worden drie objecten gebruikt:
- Een object voor de bron.
- Een object voor de doeltabel.
- Een object voor de Query-transformatie, die de kolommen van de bron naar het doel omzet.
Klik op de gegevensstroom DF_Customer. Er verschijnt een lege werkruimte zoals hieronder.
- Specificeer het object voor de bron. – Ga naar de datastore “ds_ecc”, selecteer de tabel KNA1 en sleep deze naar het lege dataflow-scherm.
- Specificeer het object voor het doel. – Selecteer de datastore “DS_BODS_HANA” in de repository en selecteer de tabel KNA1.
- Sleep het naar de werkruimte en selecteer 'Maken'. Target” optie. Er zullen nu twee tabellen zijn, een brontabel en een doeltabel.

- Querytransformatie Dit is een tool die wordt gebruikt om gegevens op te halen op basis van het invoerschema voor een gebruikersspecifieke voorwaarde, en om gegevens van de bron naar het doel te transporteren.
- Selecteer het pictogram 'Query Transform' in het gereedschapspalet en sleep het tussen het bron- en doelobject in de werkruimte.
- Koppel het Query-object aan de bron.
- Koppel het queryobject aan de doeltabel.

Double- Klik op het query-pictogram om kolommen van het invoerschema naar het uitvoerschema te koppelen. Een koppelingping Er verschijnt een venster waarin we het volgende doen:
- Brontabel KNA1 is geselecteerd.
- Selecteer alle kolommen uit de brontabel, klik met de rechtermuisknop en selecteer 'Toewijzen aan uitvoer'.
- De gewenste uitvoer wordt geselecteerd als 'Query' en de kolommen worden toegewezen.

Sla het project op en valideer het. Klik op het pictogram 'Valideren'. Er verschijnt een pop-upvenster ter bevestiging dat de validatie is geslaagd.

Stap 11) Voer de taak uit. Volg onderstaand pad om de taak uit te voeren.
- Selecteer het projectgebiedpictogram om het project te openen en selecteer vervolgens het aangemaakte project.
- Selecteer de taak en klik met de rechtermuisknop.
- Selecteer de optie 'Uitvoeren' om de taak uit te voeren.
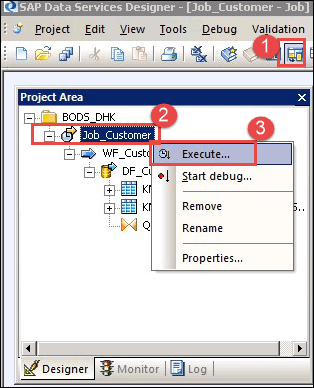
Na het uitvoeren van de taak wordt een taaklogboekvenster weergegeven, waarin alle berichten met betrekking tot de taak verschijnen. Het laatste bericht zal "Taak" zijn. is succesvol afgerond.

Stap 12) Valideer en controleer de gegevens in de SAP HANA-database.
- Meld u aan bij de SAP HANA-database door SAP HANA Studioen selecteer het HANAUSER-schema.
- Selecteer de tabel KNA1 in het knooppunt Tabel.
- Klik met de rechtermuisknop op tabel KNA1 en selecteer 'Gegevensvoorbeeld openen'.
- De KNA1-gegevens die door het BODS-proces zijn geladen, worden weergegeven in het gegevensvoorbeeldscherm.

Een overeenkomend aantal rijen tussen de brontabel en deze preview bevestigt dat het laden correct is voltooid. De taak kan vervolgens vanuit de beheerder worden ingepland voor herhaalde uitvoeringen.
