
Top 25 vragen en antwoorden over ETL-testinterviews voor 2026
 David Carter
ETL-testsollicitatievragen voor eerstejaarsstudenten
1) Wat is ETL?
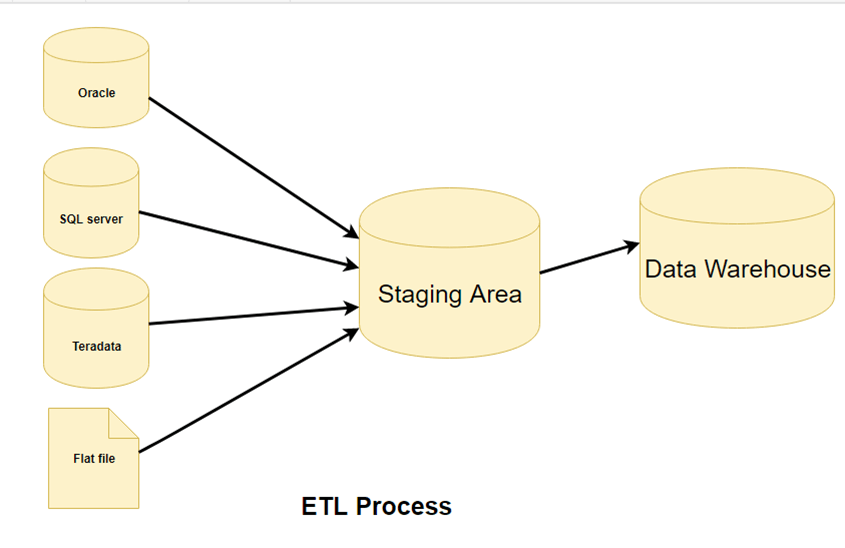
In datawarehousingarchitectuur is ETL een belangrijk onderdeel dat de gegevens voor elk bedrijfsproces beheert. ETL staat voor Extract, Transform en Laden. Extrac`t` voert het proces uit van het lezen van gegevens uit een database. `transform` zet de gegevens om in een formaat dat geschikt is voor rapportage en analyse. `load` daarentegen schrijft de gegevens naar de doeldatabase.
👉 Gratis pdf-download: vragen en antwoorden over ETL-testinterviews
2) Leg uit wat de ETL-testactiviteiten inhouden.
ETL-testen omvatten:
- Controleer of de gegevens correct worden getransformeerd volgens de zakelijke vereisten
- Controleer of de geprojecteerde gegevens in het datawarehouse worden geladen zonder enige afkapping en gegevensverlies
- Zorg ervoor dat de ETL-applicatie ongeldige gegevens rapporteert en vervangt door standaardwaarden
- Zorg ervoor dat gegevens binnen het verwachte tijdsbestek worden geladen om de schaalbaarheid en prestaties te verbeteren
3) Vermeld wat de soorten datawarehouse-applicaties zijn en wat is het verschil tussen datamining en datawarehousing?
De soorten datawarehouse-applicaties zijn
- Infoverwerking
- Analytische verwerking
- Data Mining
data mining kan worden gedefinieerd als het proces van extracHet opsporen van verborgen voorspellende informatie uit grote databases en het interpreteren van de gegevens, terwijl data warehousing gebruik kan maken van een data mining voor een snellere analytische verwerking van de gegevens. Data opslagplaats is het proces waarbij gegevens uit meerdere bronnen worden samengevoegd in één gemeenschappelijke opslagplaats
4) Wat zijn de verschillende tools die in ETL worden gebruikt?
- Cognos Decision Stream
- Oracle Magazijnbouwer
- Bedrijfsobjecten XI
- SAS bedrijfsmagazijn
- SAS Enterprise ETL-server
5) Wat is een feit? Wat zijn de soorten feiten?
Het is een centraal onderdeel van een multidimensionaal model dat de te analyseren maatregelen bevat. Feiten hebben betrekking op dimensies.
Soorten feiten zijn
- Additieve feiten
- Semi-additieve feiten
- Niet-additieve feiten
6) Leg uit wat kubussen en OLAP-kubussen zijn?
Kubussen zijn gegevensverwerkingseenheden die bestaan uit feitentabellen en dimensies uit het datawarehouse. Het biedt multidimensionale analyses.
OLAP staat voor Online Analytics Processing, en OLAP-kubus slaat grote gegevens op in multidimensionale vorm voor rapportagedoeleinden. Het bestaat uit feiten die metingen worden genoemd, gecategoriseerd op basis van dimensies.
7) Leg uit wat er is tracWat is het niveau en welke typen zijn er?
TracHet logniveau geeft de hoeveelheid gegevens aan die in de logbestanden is opgeslagen. TracHet taalniveau kan worden onderverdeeld in twee categorieën: Normaal en Uitgebreid. Het normale niveau legt uit... tracop een gedetailleerd niveau, terwijl een uitgebreide uitleg de tracing niveaus op elke rij.
8) Leg uit wat Grain of Fact is?
Graanfeit kan worden gedefinieerd als het niveau waarop de feitinformatie wordt opgeslagen. Het wordt ook wel Fact Granularity genoemd
9) Leg uit wat een feitloos feitenschema is en wat Maatstaven zijn?
Een feitentabel zonder metingen staat bekend als Feitenloze feitentabel. Het kan het aantal voorkomende gebeurtenissen bekijken. Het wordt bijvoorbeeld gebruikt om een gebeurtenis vast te leggen, zoals het aantal werknemers in een bedrijf.
De numerieke gegevens op basis van kolommen in een feitentabel worden metingen genoemd
10) Leg uit wat transformatie is?
Een transformatie is een repositoryobject dat gegevens genereert, wijzigt of doorgeeft. Er zijn twee soorten transformatie: Actief en Passief
Interviewvragen en antwoorden voor ETL-ontwikkelaars voor ervaren
11) Leg het gebruik van Lookup Transformation uit?
De opzoektransformatie is nuttig voor
- Een gerelateerde waarde uit een tabel halen met behulp van een kolomwaarde
- Update langzaam veranderende dimensietabel
- Controleer of er al records in de tabel bestaan
12) Leg uit wat partitionering, hash-partitionering en round-robin-partitionering is?
Om de prestaties te verbeteren, worden transacties onderverdeeld, dit wordt Partitionering genoemd. Partitionering maakt dit mogelijk Informatica Server voor het creëren van meerdere verbindingen met verschillende bronnen
De soorten partities zijn
Round-Robin-partitionering:
- Door informatica worden gegevens gelijkmatig over alle partities verdeeld
- In elke partitie waar het aantal te verwerken rijen ongeveer hetzelfde is, is deze partitionering van toepassing
Hash-partitionering:
- Voor het verdelen van sleutels om gegevens tussen partities te groeperen, past de Informatica-server een hash-functie toe
- Het wordt gebruikt om ervoor te zorgen dat de procesgroepen van rijen met dezelfde partitiesleutel in dezelfde partitie verzekerd moeten zijn
13) Noem wat het voordeel is van het gebruik van DataReader Destination Adapter?
Het voordeel van het gebruik van de DataReader Destination Adapter is dat deze een ADO-recordset (bestaat uit records en kolommen) in het geheugen en stelt de gegevens van de DataFlow-taak beschikbaar door de DataReader-interface te implementeren, zodat andere toepassingen de gegevens kunnen gebruiken.
14) Wat zijn de mogelijke manieren om de tabel bij te werken met behulp van SSIS (SQL Server Integration Service)?
Om de tabel bij te werken met SSIS zijn de mogelijke manieren:
- Gebruik een SQL commando
- Gebruik een faseringstabel
- Cache gebruiken
- Gebruik de scripttaak
- Gebruik de volledige databasenaam voor het bijwerken als MSSQL wordt gebruikt
15) Wat zou u doen als u een niet-OLEDB-bron (Object Linking and Embedding Database) heeft voor de zoekopdracht?
Als u een niet-OLEBD-bron voor de zoekopdracht heeft, moet u Cache gebruiken om gegevens te laden en deze als bron te gebruiken
16) In welk geval gebruikt u dynamische cache en statische cache in verbonden en niet-verbonden transformaties?
- Dynamische cache wordt gebruikt wanneer u de hoofdtabel en langzaam veranderende dimensies (SCD) type 1 moet bijwerken
- Voor platte bestanden wordt statische cache gebruikt
17) Leg uit wat de verschillen zijn tussen niet-verbonden en verbonden zoekopdrachten?
| Verbonden opzoeken | Niet-verbonden opzoeken |
|---|---|
| Verbonden opzoeken neemt deel aan de kaartping | Het wordt gebruikt wanneer een opzoekfunctie wordt gebruikt in plaats van een expressietransformatie tijdens het mappen.ping |
| Er kunnen meerdere waarden worden geretourneerd | Geeft slechts één uitgangspoort terug |
| Het kan worden verbonden met andere transformaties en retourneert een waarde | Een andere transformatie kan niet met elkaar in verband worden gebracht |
| Statische of dynamische cache kan worden gebruikt voor verbonden opzoeken | Niet verbonden omdat het alleen statische cache is |
| Verbonden opzoeken ondersteunt door de gebruiker gedefinieerde standaardwaarden | Niet-verbonden opzoeken ondersteunt geen door de gebruiker gedefinieerde standaardwaarden |
| In Connected Lookup kunnen meerdere kolommen uit dezelfde rij worden geretourneerd of in de dynamische opzoekcache worden ingevoegd | Niet-verbonden zoekopdrachten wijzen één retourpoort aan en retourneren één kolom uit elke rij |
18) Leg uit wat de gegevensbronweergave is?
Een gegevensbronweergave maakt het mogelijk om het relationele schema te definiëren dat zal worden gebruikt in de databases van analyseservices. In plaats van rechtstreeks op basis van gegevensbronobjecten worden dimensies en kubussen gemaakt op basis van gegevensbronweergaven.
19) Leg uit wat het verschil is tussen OLAP-tools en ETL-tools?
Het verschil tussen ETL- en OLAP-tool is dat
ETL-tool is bedoeld voor de extracHet overzetten van gegevens uit de oude systemen naar een specifieke database, waarbij de gegevens eerst worden opgeschoond.
Voorbeeld: Datafase, Informatica etc.
Terwijl OLAP bedoeld is voor rapportagedoeleinden in OLAP-gegevens die beschikbaar zijn in een multidirectioneel model.
Voorbeeld: Bedrijfsobjecten, Cognos enz.
20) Hoe je kunt uitleggentract SAP gegevens met behulp van Informatica?
- Met de optie voor stroomaansluiting kunt utract SAP gegevens met behulp van informatica
- Installeer en configureer de PowerConnect-tool
- Importeer de bron in de Source Analyzer. Tussen Informatica en SAP Powerconnect fungeert als gateway. De volgende stap is het genereren van de ABAP-code voor de mapping.ping Dan kan alleen Informatica gegevens ophalen van SAP
- Voor het aansluiten en importeren van bronnen uit externe systemen wordt Power Connect gebruikt
21) Noem wat het verschil is tussen Power Mart en Power Center?
| Krachtcentrum | Macht Mart |
|---|---|
| Stel dat u een enorme hoeveelheid gegevens verwerkt | Stel dat u een laag gegevensvolume verwerkt |
| Het ondersteunt ERP-bronnen zoals SAP, mensen zacht enz. | Het ondersteunt geen ERP-bronnen |
| Het ondersteunt lokale en mondiale repository | Het ondersteunt lokale opslagplaatsen |
| Het converteert lokale naar mondiale repository | Het heeft geen specificatie om een lokale naar een globale repository te converteren |
22) Leg uit wat een verzamelplaats is en wat het doel is van een verzamelplaats?
Data staging is een gebied waar u de data tijdelijk op een datawarehouse-server bewaart. Data staging omvat de volgende stappen
- Brongegevens bijvoorbeeldtracen datatransformatie (herstructurering)
- Datatransformatie (dataopschoning, waardetransformatie)
- Surrogaatsleuteltoewijzingen
23) Wat is busschema?
Om de verschillende bedrijfsprocessen te identificeren om de gemeenschappelijke dimensies te identificeren, wordt het BUS-schema gebruikt. Het wordt geleverd met conforme afmetingen en een gestandaardiseerde definitie van informatie
24) Leg uit wat het opschonen van gegevens is?
Het opschonen van gegevens is een proces waarbij gegevens uit het datawarehouse worden verwijderd. Het verwijdert ongewenste gegevens zoals rijen met nulwaarden of extra spaties.
25) Leg uit wat schemaobjecten zijn?
Schema-objecten zijn de logische structuur die direct verwijst naar de databasegegevens. Schema-objecten omvatten tabellen, weergaven, sequentiesynoniemen, indexen, clusters, functiepakketten en databasekoppelingen.
26) Leg deze termen uit Sessie, Worklet, Mapplet en Workflow?
- Mapplet: Het regelt of creëert sets van transformatie
- Werkje: Het vertegenwoordigt een specifieke reeks gegeven taken
- Workflow: Het is een reeks instructies die de server vertellen hoe taken moeten worden uitgevoerd
- Sessie: Het is een reeks parameters die de server vertellen hoe gegevens van bron naar doel moeten worden verplaatst
Deze interviewvragen zullen ook helpen bij je viva (oralen)
