
Transformacja agregatora w informatyce z przykładem
 Zespół redakcyjny
⚡ Inteligentne podsumowanie
Transformacja agregatora w Informatica to aktywny obiekt wykonujący obliczenia, takie jak sumowanie, średnia i liczenie w grupie wierszy, przechowujący te wiersze w pamięci podręcznej agregatu do momentu ukończenia każdej grupy.
Co to jest transformacja agregatora?
Transformacja agregatorowa to aktywna transformacja, która wykonuje obliczenia agregacyjne, takie jak suma, średnia i liczenie.
Na przykład, jeśli chcesz obliczyć sumę pensji wszystkich pracowników w podziale na działy, możesz skorzystać z transformacji Aggregator.
Operacje agregacji są wykonywane na grupie wierszy, więc do przechowywania wszystkich tych rekordów i wykonywania obliczeń wymagany jest tymczasowy symbol zastępczy.
W tym celu wykorzystywana jest pamięć podręczna agregatora. Jest to tymczasowa pamięć główna przydzielona transformacji agregatora do wykonywania takich operacji i składa się z dwóch części: pamięci podręcznej indeksów, która przechowuje wartości grup, oraz pamięci podręcznej danych, która przechowuje dane wierszy podlegające agregacji.
Transformacja jest aktywna, ponieważ zmienia liczbę wierszy w kanale. Może on zawierać kilka tysięcy rekordów pracowników, a opuszcza go tylko jeden wiersz na dział.
Jak korzystać z transformacji agregatora w Informatica
W tym przykładzie obliczymy sumę wynagrodzeń według działów. W tym celu potrzebujemy nowej kolumny do przechowywania tej sumy. Więc najpierw przygotujemy nową kolumnę.
Krok 1) Utwórz nową tabelę docelową bazy danych, na przykład „sum_sal_deptwise”, korzystając z poniższego skryptu. Zobaczysz nową tabelę docelową bazy danych utworzoną pod Targets folder w następnym kroku.
Pobierz powyższy plik Create_table_sal_deptwise.txt
Krok 2) Stwórz nowy mapaping “m_sum_sal_deptwise”.
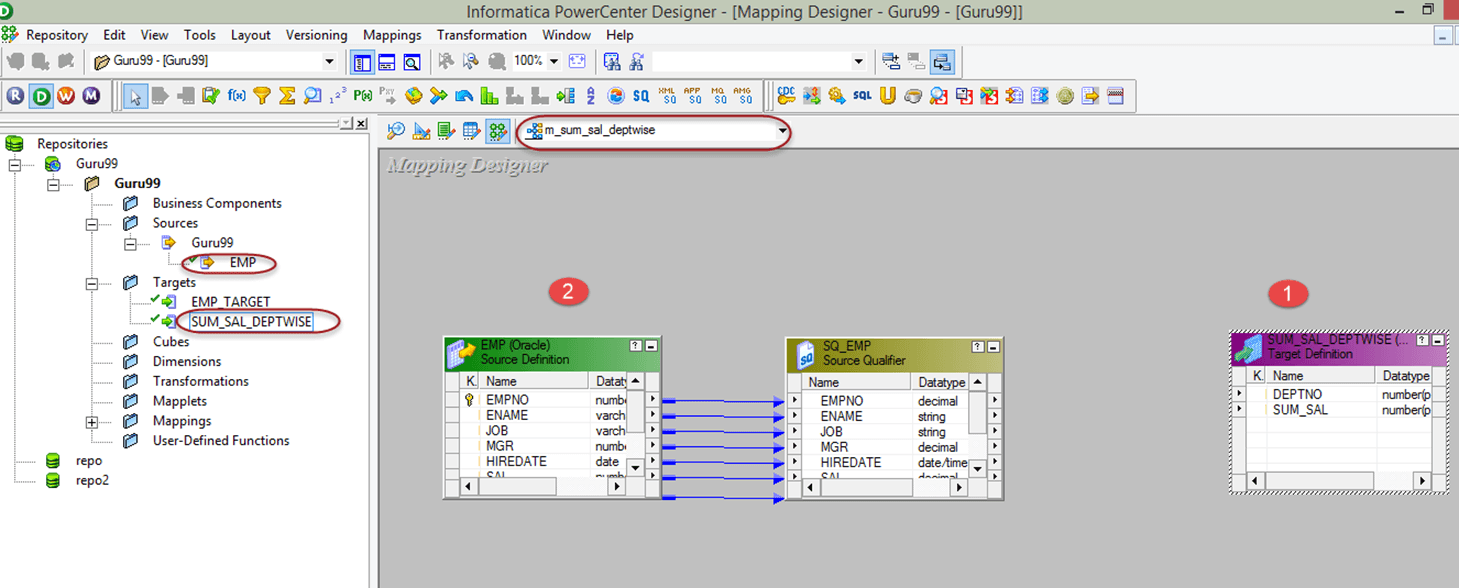
Aby utworzyć nową mapęping, potrzebujemy tabeli źródłowej (EMP) i tabeli docelowej (sum_sal_deptwise) w Mapieping Projektant, więc musimy
- Zaimportuj tabelę docelową „sum_sal_deptwise” na mapieping.
- Zaimportuj tabelę źródłową „emp”.
Obie definicje są teraz widoczne na płótnie, jak pokazano poniżej.
Krok 3) Na mapieping,
- Z Kwalifikator źródła, usuń kolumny empno, ename, job, mgr, hiredate i comm, pozostawiając jedynie kolumny deptno i sal.
- Utwórz nową transformację agregatora za pomocą menu skrzynki narzędziowej, jak pokazano na zrzucie ekranu. Po kliknięciu ikony agregatora zostanie utworzona nowa transformacja agregatora.
Nowy obiekt AGGTRANS pojawi się obok przyciętego kwalifikatora źródłowego.

Krok 4) Przeciągnij i upuść kolumny SAL i DEPTNO z kwalifikatora źródłowego (SQ_EMP) do transformacji agregatora. Te dwa porty są teraz połączone w AGGTRANS.

Krok 5) Double-kliknij transformację agregatora, aby otworzyć jej właściwości, a następnie
- Dodaj nowy port w transformacji
- Zmień nazwę portu na SUM_SAL
- Zmień typ danych tego nowego portu na podwójny
- Aby uczynić ten port portem wyjściowym, zaznacz pole wyboru portu wyjściowego
- Kliknij opcję wyrażenia
Karta Porty zawiera teraz listę SAL, DEPTNO i nowy port wyjściowy SUM_SAL.

Krok 6) W oknie Edytora wyrażeń
- Dodaj wyrażenie sum(SAL); musisz napisać to wyrażenie samodzielnie.
- Kliknij przycisk OK, co spowoduje powrót do okna Edytuj transformacje.
Edytor wyrażeń pokazuje wyrażenie zbiorcze przypisane do SUM_SAL.

Krok 7) W oknie Edycja transformacji wybierz opcję „Grupuj według”, zaznaczając pole wyboru przy kolumnie deptno i kliknij OK. Wybierając opcję „Grupuj według” dla deptno, instruujemy Informaticę, aby grupowała wynagrodzenia według deptno.

Krok 8) Połącz kolumny deptno i sum_sal z transformacji agregatora z tabelą docelową. Mapaping zostaje wówczas ukończona od źródła do celu.

Teraz zapisz mapęping i wykonaj go po utworzeniu nowego Sesja dla tej mapypingTabela docelowa zawierałaby sumę wynagrodzeń według działów. W ten sposób możemy użyć transformacji Agregatora do obliczenia wyników zagregowanych.
Grupuj według portów w transformacji agregatora
W powyższym kroku oznaczono pojedynczy port jako Grupuj według, co przekształciło sumę dla całej firmy w jedną sumę dla każdego działu. W ten sam sposób można oznaczyć dowolny port wejściowy, wejściowy/wyjściowy, wyjściowy lub zmienny.
Zestawem wyników rządzą trzy zasady:
- Jeden rząd na grupę. Po zgrupowaniu wartości usługa integracji generuje jeden wiersz dla każdej unikatowej kombinacji grupowania według portów.
- Brak grupowania, jeden wiersz. Jeśli nie zaznaczono żadnego portu, całe dane wejściowe są traktowane jako pojedyncza grupa i dla wszystkich wierszy wejściowych zwracany jest jeden wiersz.
- Ostatni rząd wygrywa. Oprócz wyniku zbiorczego usługa integracji zwykle przekazuje ostatni wiersz otrzymany w grupie, chyba że funkcja taka jak FIRST zwróci nazwę innego wiersza.
W przypadku oznaczenia kilku portów, kolejność portów decyduje o grupieping zamówienie, a zamówienie może zmienić wynik. Grupaping przez DEPTNO i wtedy JOB nie jest tym samym co grupaping według JOB i następnie DEPTNO, ponieważ wartości drugiej kolumny nie muszą być unikalne.
Właściwości transformacji agregatora
Karta Właściwości w oknie Edycja transformacji zawiera ustawienia decydujące o miejscu przechowywania pamięci podręcznej i jej wykorzystaniu. Poniższa tabela zawiera ich listę.
| Oprawa | Co kontroluje |
|---|---|
| Katalog pamięci podręcznej | Katalog lokalny, w którym usługa integracji tworzy pliki indeksów i pamięci podręcznej danych. Domyślnie jest to zmienna procesu $PMCacheDir ustawiona w Menedżerze przepływów pracy. |
| TracPoziom wejściowy | Ilość szczegółów zapisanych w dzienniku sesji dla tej transformacji. |
| Posortowane dane wejściowe | Deklaruje, że dane przychodzące są już posortowane według grupy według portów. Wybierz tę opcję tylko wtedy, gdy mapaping naprawdę dostarcza posortowane dane. |
| Rozmiar pamięci podręcznej danych agregatora | Rozmiar pamięci podręcznej danych. Wartość domyślna to 2 000 000 bajtów, a opcja Auto pozwala usłudze integracji na ustalenie rozmiaru. |
| Rozmiar pamięci podręcznej indeksu agregatora | Rozmiar pamięci podręcznej indeksów. Domyślnie wynosi 1 000 000 bajtów, a opcja Auto pozwala usłudze integracji na ustalenie rozmiaru. |
| Zakres transformacji | Stosuje logikę do każdej transakcji lub do wszystkich danych przychodzących. Opcja „Wszystkie dane wejściowe” pomija granice transakcji przychodzących. |
Gdy włączona jest agregacja przyrostowa, usługa integracji zapisuje kopię zapasową plików pamięci podręcznej przy każdym uruchomieniu, więc katalog pamięci podręcznej musi zawierać dwa zestawy plików, a nie jeden.
Reguły wyrażeń agregowanych i wskazówki dotyczące wydajności
Wyrażenie agregujące może łączyć funkcję agregującą z klauzulami warunkowymi i funkcjami nieagregującymi, co umożliwia sumowanie i zliczanie warunkowe w ramach jednego portu. Dwie reguły ograniczają to, co można zapisać.
- Jeden poziom zagnieżdżenia. Tylko jedna funkcja agregująca może być zagnieżdżona w innej, a wyrażenie wewnętrzne jest oceniane jako pierwsze.
- Bez mieszania. Transformacja może zawierać funkcje jednopoziomowe lub zagnieżdżone, nigdy obie. Jeśli zawiera obie, Projektant zaznacza mapę.ping jest nieprawidłowy, więc podziel logikę na dwie transformacje agregatora.
Jeśli chodzi o strojenie, największą część pracy wykonują trzy ustawienia:
- Posortowane dane wejściowe. Gdy wiersze napływają posortowane według grup i portów, każda grupa może zostać zwolniona zaraz po nadejściu ostatniego wiersza, co pozwala na buforowanie mniejszej ilości danych i szybsze działanie sesji. Posortowanych danych wejściowych nie można łączyć z agregacją przyrostową.
- Agregacja przyrostowa. Nowe wiersze źródłowe są przesyłane przez mapęping i połączyć z historyczną pamięcią podręczną zamiast przeliczać historię, co pasuje do nocnego obciążenia bieżącej sumy.
- Filtruj wcześnie. Wiersze, które nigdy nie będą przyczyniać się do sumy, należy usunąć przed agregatorem, albo w zapytaniu kwalifikatora źródła, albo w Transformacja filtra, ponieważ każdy wiersz docierający do agregatora kosztuje pamięć podręczną. Jest to jedno ze standardowych sprawdzeń podczas dostrajanie wydajności.
