
PyTorsamouczek ch
 Evelyn Clarke
⚡ Inteligentne podsumowanie
PyTorch to otwartoźródłowy framework do głębokiego uczenia maszynowego firmy Meta, który w 2026 roku będzie stanowił podstawę 85 procent prac badawczych na temat sztucznej inteligencji. LessObejmuje instalację, podstawy frameworka, prostą regresję, klasyfikację obrazów i wdrożenie AWS SageMaker.
Co to jest PyTorH?
PyTorch jest open-source TorBiblioteka uczenia maszynowego oparta na ch do przetwarzania języka naturalnego przy użyciu PythonJest podobny do NumPy, ale z wydajnym wsparciem GPU. Oferuje dynamiczne grafy obliczeniowe, które można modyfikować na bieżąco za pomocą autogradu. PyTorch jest również szybszy niż niektóre inne frameworki. Został opracowany w 2016 roku przez grupę badawczą ds. sztucznej inteligencji Facebooka.
Wiedza o tym, co PyTorrozdział ten przedstawia zrównoważony pogląd na jego mocne i słabe strony.
PyTorch Zalety i wady
Poniżej przedstawiono zalety i wady języka PyTorch:
Zalety PyTorch
- Prosta biblioteka
PyTorKod ch jest prosty. Jest łatwy do zrozumienia, a biblioteka działa od razu. Na przykład, spójrz na poniższy fragment kodu:
class Net(torch.nn.Module):
   def __init__(self):
       super(Net, self).__init__()
       self.layer = torch.nn.Linear(1, 1)

   def forward(self, x):
       x = self.layer(x)
       return x
Jak wspomniano powyżej, możesz łatwo zdefiniować model sieci i szybko zrozumieć kod, bez większego szkolenia.
- Dynamiczny wykres obliczeniowy

Źródło obrazu: Eksploracja głębokiego uczenia się za pomocą języka PyTorch
PyTorch oferuje Dynamiczny Graf Obliczeniowy (DAG). Grafy obliczeniowe to sposób wyrażania wyrażeń matematycznych w modelach lub teoriach grafów, takich jak węzły i krawędzie. Węzeł wykonuje operację matematyczną, a krawędź jest tensorem, który jest przekazywany do węzłów i przenosi dane wyjściowe węzła w tensorze.
DAG to graf, który przyjmuje dowolny kształt i może wykonywać operacje między różnymi grafami wejściowymi. Każda iteracja tworzy nowy graf. Tak więc możliwe jest posiadanie tej samej struktury grafu lub utworzenie nowego grafu z inną operacją, lub możemy nazwać go grafem dynamicznym.
- Lepsza wydajność
Społeczności i badacze dokonują testów porównawczych i porównują platformy, aby zobaczyć, która z nich jest szybsza. Repozytorium GitHub Test porównawczy platform głębokiego uczenia się i procesorów graficznych poinformował, że PyTorch jest szybszy niż inne frameworki pod względem ilości obrazów przetwarzanych na sekundę.
Jak widać poniżej, wykresy porównawcze z vgg16 i resnet152


- Tubylec Python
PyTorch jest bardziej oparty na Pythonie. Na przykład, jeśli chcesz trenować model, możesz użyć natywnego przepływu sterowania, takiego jak loo.ping i rekursje bez konieczności dodawania dodatkowych zmiennych specjalnych lub sesji, aby móc je uruchomić. Jest to bardzo pomocne w procesie szkolenia.
PyTorch implementuje również programowanie imperatywne, co jest zdecydowanie bardziej elastyczne. Dzięki temu możliwe jest wydrukowanie wartości tensora w trakcie procesu obliczeniowego.
Wady PyTorch
PyTorch wymaga aplikacji firm trzecich do wizualizacji. Wymaga również serwera API do produkcji.
Następny w tym PyTorW tym samouczku poznamy różnice między PyTorch i TensorFlow.
PyTorch kontra TensorFlow
| Parametr | PyTorch | TensorFlow |
|---|---|---|
| Definicja modelu | Model jest zdefiniowany w podklasie i oferuje łatwy w użyciu pakiet | Model jest zdefiniowany na wiele sposobów i musisz zrozumieć składnię |
| Obsługa GPU | Tak | Tak |
| Typ wykresu | Dynamiczny | Statyczny |
| Narzędzia | Brak narzędzia do wizualizacji | Możesz użyć narzędzia do wizualizacji Tensorboard |
| Społeczność | Społeczność wciąż rośnie | Duże aktywne społeczności |
Mając na uwadze porównanie, następnym krokiem jest uzyskanie PyTorch działający lokalnie lub w chmurze.
Instalowanie PyTorch
Linux
Instalacja w systemie Linux jest prosta. Możesz wybrać środowisko wirtualne lub zainstalować je bezpośrednio z uprawnieniami roota. Wpisz to polecenie w terminalu
pip3 install --upgrade torch torchvision
AWS Sagemaker
Sagemaker to jedna z platform w Amazon Serwis internetowy który oferuje potężny silnik uczenia maszynowego z preinstalowanymi konfiguracjami głębokiego uczenia dla analityków danych i programistów w celu tworzenia, trenowania i wdrażania modeli w dowolnej skali.
Najpierw otwórz Amazon Strzelec konsoli i kliknij Utwórz instancję notatnika, a następnie wprowadź wszystkie szczegóły dotyczące notatnika.

Następny krok: Kliknij Otwórz, aby uruchomić instancję notatnika.

Wreszcie w JupyterKliknij Nowy i wybierz conda_pytorch_p36, a będziesz gotowy do użycia swojej instancji notatnika z PyTorch zainstalowany.
Następny w tym PyTorw samouczku ch poznamy PyTorPodstawy frameworka ch.
Kolejnym krokiem po zainstalowaniu interfejsu API jest jego instalacja.
PyTorPodstawy frameworka ch
Poznajmy podstawowe koncepcje języka PyTorch zanim zagłębimy się w temat. PyTorch używa tensora dla każdej zmiennej, podobnie jak ndarray numpy, ale z obsługą obliczeń GPU. Tutaj wyjaśnimy model sieci, funkcję straty, Backprop i optymalizator.
Model sieciowy
Sieć można zbudować poprzez podklasę torch.nn. Istnieją 2 główne części,
- Pierwsza część polega na zdefiniowaniu parametrów i warstw, których będziesz używać
- Druga część to główne zadanie zwane procesem forward, które pobiera dane wejściowe i przewiduje wynik.
Import torch
import torch.nn as nn
import torch.nn.functional as F

class Model(nn.Module):
 def __init__(self):
        super(Model, self).__init__()
        self.conv1 = nn.Conv2d(3, 20, 5)
        self.conv2 = nn.Conv2d(20, 40, 5)
self.fc1 = nn.Linear(320, 10)

def forward(self, x):
       x = F.relu(self.conv1(x))
       x = F.relu(self.conv2(x))
       x = x.view(-1, 320)
       x = F.relu(self.fc1(x))
       return F.log_softmax(x)

net = Model()
Jak widać powyżej, tworzysz klasę nn.Module o nazwie Model. Zawiera 2 warstwy Conv2d i warstwę Linear. Pierwsza warstwa conv2d przyjmuje dane wejściowe o wartości 3 i kształt wyjściowy o wartości 20. Druga warstwa przyjmuje dane wejściowe o wartości 20 i generuje kształt wyjściowy o wartości 40. Ostatnia warstwa jest w pełni połączoną warstwą w kształcie 320 i generuje wynik 10.
Proces forward pobierze dane wejściowe X i przekaże je do warstwy conv1 i wykona funkcję ReLU,
Podobnie będzie również zasilać warstwę conv2. Następnie x zostanie przekształcone w (-1, 320) i wprowadzone do końcowej warstwy FC. Zanim wyślesz dane wyjściowe, skorzystasz z funkcji aktywacji softmax.
Proces wsteczny jest automatycznie definiowany przez autograd, więc wystarczy zdefiniować proces do przodu.
Funkcja straty
Funkcja straty służy do pomiaru, jak dobrze model predykcyjny jest w stanie przewidzieć oczekiwane wyniki.Torch zawiera już wiele standardowych funkcji strat w module torch.nn. Na przykład, można użyć funkcji Cross-Entropy Loss do rozwiązania wieloklasowego równania Py.TorProblem klasyfikacji ch. Łatwo zdefiniować funkcję straty i obliczyć straty:
loss_fn = nn.CrossEntropyLoss()

#training process
loss = loss_fn(out, target)
Łatwo jest użyć własnego obliczenia funkcji straty w PyTorch.
Podpórka
Aby wykonać propagację wsteczną, wystarczy wywołać funkcję los.backward(). Błąd zostanie obliczony, ale pamiętaj, aby wyczyścić istniejący gradient za pomocą funkcji zero_grad()
net.zero_grad() # to clear the existing gradient
loss.backward() # to perform backpropragation
Optimizer
Torch.optim zapewnia typowe algorytmy optymalizacji. Możesz zdefiniować optymalizator za pomocą prostego kroku:
optimizer = torch.optim.SGD(net.parameters(), lr = 0.01, momentum=0.9)
Musisz przekazać parametry modelu sieci i szybkość uczenia się, aby przy każdej iteracji parametry były aktualizowane po procesie backprop.
Najprostszym sposobem nauki API jest zapoznanie się z małym, kompleksowym przykładem.
Prosta regresja z PyTorch
Nauczmy się prostej regresji za pomocą PyTorprzykłady rozdziałów:
Krok 1) Stworzenie naszego modelu sieci
Nasz model sieci to prosta warstwa liniowa z wejściem i wyjściem o kształcie 1.
from __future__ import print_function

import torch
import torch.nn as nn
import torch.nn.functional as F
from torch.autograd import Variable

class Net(nn.Module):
   def __init__(self):
       super(Net, self).__init__()
       self.layer = torch.nn.Linear(1, 1)

   def forward(self, x):
       x = self.layer(x)
       return x

net = Net()
print(net)
A wyjście sieciowe powinno być takie
Net(
  (hidden): Linear(in_features=1, out_features=1, bias=True)
)
Krok 2) Dane testowe
Zanim rozpoczniesz proces szkolenia, musisz poznać nasze dane. Tworzysz losową funkcję, aby przetestować nasz model. Y = x3 grzech(x)+ 3x+0.8 rand(100)
# Visualize our data
import matplotlib.pyplot as plt
import numpy as np

x = np.random.rand(100)
y = np.sin(x) * np.power(x,3) + 3*x + np.random.rand(100)*0.8

plt.scatter(x, y)
plt.show()
Oto wykres rozrzutu naszej funkcji:

Przed rozpoczęciem procesu szkolenia należy przekonwertować tablicę numpy na zmienne obsługiwane przez Torch i autograd, jak pokazano poniżej w PyTorprzykład regresji ch.
# convert numpy array to tensor in shape of input size
x = torch.from_numpy(x.reshape(-1,1)).float()
y = torch.from_numpy(y.reshape(-1,1)).float()
print(x, y)
Krok 3) Optymalizator i strata
Następnie należy zdefiniować Optymalizator i Funkcję Straty dla naszego procesu uczenia.
# Define Optimizer and Loss Function
optimizer = torch.optim.SGD(net.parameters(), lr=0.2)
loss_func = torch.nn.MSELoss()
Krok 4) Szkolenie
Teraz rozpocznijmy nasz proces szkoleniowy. W epoce 250 będziesz iterować nasze dane, aby znaleźć najlepszą wartość naszych hiperparametrów.
inputs = Variable(x)
outputs = Variable(y)
for i in range(250):
   prediction = net(inputs)
   loss = loss_func(prediction, outputs)
   optimizer.zero_grad()
   loss.backward()
   optimizer.step()

   if i % 10 == 0:
       # plot and show learning process
       plt.cla()
       plt.scatter(x.data.numpy(), y.data.numpy())
       plt.plot(x.data.numpy(), prediction.data.numpy(), 'r-', lw=2)
       plt.text(0.5, 0, 'Loss=%.4f' % loss.data.numpy(), fontdict={'size': 10, 'color':  'red'})
       plt.pause(0.1)

plt.show()
Krok 5) Wynik
Jak widać poniżej, udało Ci się pomyślnie wykonać polecenie PyTorRegresja ch z siecią neuronową. W rzeczywistości, w każdej iteracji, czerwona linia na wykresie będzie się aktualizować i zmieniać swoje położenie, dopasowując się do danych. Jednak na tym rysunku pokazuje on tylko wynik końcowy, jak pokazano poniżej w Py.Torprzykład ch:

Regresja to rozgrzewka; klasyfikacja obrazów ćwiczy głębokie uczenie się języka PyTorch.
Przykład klasyfikacji obrazu z użyciem języka PyTorch
Jedna z popularnych metod nauki podstaw głęboka nauka jest z zestawem danych MNIST. Jest to „Hello World” w głębokim uczeniu. Zestaw danych zawiera ręcznie pisane liczby od 0 do 9 z całkowitą liczbą 60,000 10,000 próbek szkoleniowych i 28 28 próbek testowych, które są już oznaczone rozmiarem XNUMX×XNUMX pikseli.

Krok 1) Wstępnie przetwórz dane
W pierwszym kroku tego PyTorPrzykład klasyfikacji ch. Załadujesz zbiór danych za pomocą modułu torchvision.
Zanim rozpoczniesz proces szkolenia, musisz zrozumieć dane. Torchvision załaduje zbiór danych i przekształci obrazy zgodnie z odpowiednimi wymaganiami sieci, takimi jak kształt i normalizacja obrazów.
import torch
import torchvision
import numpy as np
from torchvision import datasets, models, transforms

# This is used to transform the images to Tensor and normalize it
transform = transforms.Compose(
   [transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))])

training = torchvision.datasets.MNIST(root='./data', train=True,
                                       download=True, transform=transform)
train_loader = torch.utils.data.DataLoader(training, batch_size=4,
                                         shuffle=True, num_workers=2)

testing = torchvision.datasets.MNIST(root='./data', train=False,
                                      download=True, transform=transform)
test_loader = torch.utils.data.DataLoader(testing, batch_size=4,
                                        shuffle=False, num_workers=2)

classes = ('0', '1', '2', '3',
          '4', '5', '6', '7', '8', '9')

import matplotlib.pyplot as plt
import numpy as np

#create an iterator for train_loader
# get random training images
data_iterator = iter(train_loader)
images, labels = data_iterator.next()

#plot 4 images to visualize the data
rows = 2
columns = 2
fig=plt.figure()
for i in range(4):
   fig.add_subplot(rows, columns, i+1)
   plt.title(classes[labels[i]])
   img = images[i] / 2 + 0.5     # this is for unnormalize the image
   img = torchvision.transforms.ToPILImage()(img)
   plt.imshow(img)
plt.show()
Funkcja transformacji konwertuje obrazy na tensor i normalizuje wartość. Funkcja torchvision.transforms.MNIST, pobierze zbiór danych (jeśli nie jest dostępny) do katalogu, w razie potrzeby ustawi zbiór danych do uczenia i wykona proces transformacji.
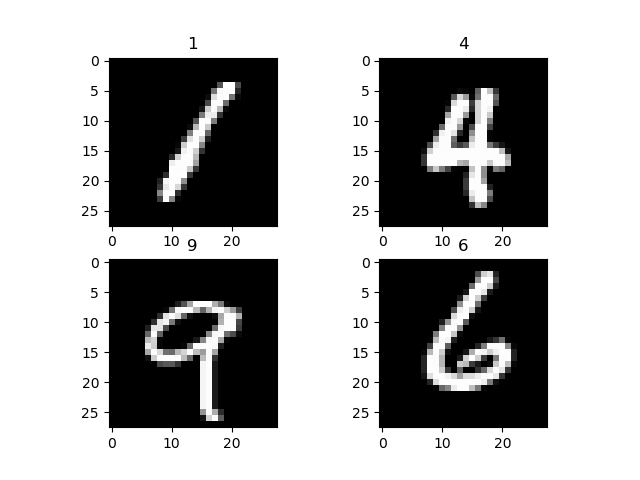
Aby zwizualizować zbiór danych, użyj data_iterator, aby uzyskać kolejną partię obrazów i etykiet. Do wykreślenia tych obrazów i odpowiedniej etykiety używasz narzędzia Matplot. Jak widać poniżej nasze obrazy i ich etykiety.
Krok 2) Konfiguracja modelu sieci
Teraz w tym PyTorNa przykład stworzysz prostą sieć neuronową dla języka PyTorklasyfikacja obrazu ch.
Tutaj przedstawiamy inny sposób tworzenia modelu sieciowego w PyTorrozdz. Użyjemy nn.Sequential do utworzenia modelu sekwencji zamiast tworzenia podklasy nn.Module.
import torch.nn as nn

# flatten the tensor into
class Flatten(nn.Module):
   def forward(self, input):
       return input.view(input.size(0), -1)

#sequential based model
seq_model = nn.Sequential(
           nn.Conv2d(1, 10, kernel_size=5),
           nn.MaxPool2d(2),
           nn.ReLU(),
           nn.Dropout2d(),
           nn.Conv2d(10, 20, kernel_size=5),
           nn.MaxPool2d(2),
           nn.ReLU(),
           Flatten(),
           nn.Linear(320, 50),
           nn.ReLU(),
           nn.Linear(50, 10),
           nn.Softmax(),
         )

net = seq_model
print(net)
Oto wynik naszego modelu sieci
Sequential(
  (0): Conv2d(1, 10, kernel_size=(5, 5), stride=(1, 1))
  (1): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (2): ReLU()
  (3): Dropout2d(p=0.5)
  (4): Conv2d(10, 20, kernel_size=(5, 5), stride=(1, 1))
  (5): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (6): ReLU()
  (7): Flatten()
  (8): Linear(in_features=320, out_features=50, bias=True)
  (9): ReLU()
  (10): Linear(in_features=50, out_features=10, bias=True)
  (11): Softmax()
)
Wyjaśnienie sieci
- Sekwencja jest taka, że pierwsza warstwa to warstwa Conv2D z kształtem wejściowym 1 i kształtem wyjściowym 10 z rozmiarem jądra 5
- Następnie masz warstwę MaxPool2D
- Funkcja aktywacji ReLU
- warstwę rezygnacji, aby usunąć wartości o niskim prawdopodobieństwie.
- Następnie drugi Conv2d z kształtem wejściowym 10 z ostatniej warstwy i kształtem wyjściowym 20 z rozmiarem jądra 5
- Następnie warstwa MaxPool2d
- Funkcja aktywacji ReLU.
- Następnie spłaszczysz tensor przed wprowadzeniem go do warstwy Linear
- Warstwa liniowa odwzoruje nasze wyjście na drugą warstwę liniową z funkcją aktywacji softmax
Krok 3) Wytrenuj model
Przed rozpoczęciem procesu uczenia należy ustawić funkcję kryterium i optymalizatora.
Jako kryterium użyjesz CrossEntropyLoss. W przypadku optymalizatora użyjesz SGD ze współczynnikiem uczenia 0.001 i pędem 0.9, jak pokazano poniżej na wykresie Py.Torprzykład ch.
import torch.optim as optim

criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(net.parameters(), lr=0.001, momentum=0.9)
Proces forward przyjmie kształt wejściowy i przekaże go do pierwszej warstwy conv2d. Następnie zostanie on wprowadzony do maxpool2d i ostatecznie wprowadzony do funkcji aktywacji ReLU. Ten sam proces będzie miał miejsce w drugiej warstwie conv2d. Następnie dane wejściowe zostaną przekształcone w (-1,320) i wprowadzone do warstwy fc w celu przewidzenia wyniku.
Teraz rozpoczniesz proces szkolenia. Będziesz iterować po naszym zestawie danych 2 razy lub z epoką 2 i drukować bieżącą stratę w każdej partii 2000.
for epoch in range(2):

#set the running loss at each epoch to zero
   running_loss = 0.0
# we will enumerate the train loader with starting index of 0
# for each iteration (i) and the data (tuple of input and labels)
   for i, data in enumerate(train_loader, 0):
       inputs, labels = data

# clear the gradient
       optimizer.zero_grad()

#feed the input and acquire the output from network
       outputs = net(inputs)

#calculating the predicted and the expected loss
       loss = criterion(outputs, labels)

#compute the gradient
       loss.backward()

#update the parameters
       optimizer.step()

       # print statistics
       running_loss += loss.item()
       if i % 1000 == 0:
           print('[%d, %5d] loss: %.3f' %
                 (epoch + 1, i + 1, running_loss / 1000))
           running_loss = 0.0
W każdej epoce moduł wyliczający otrzyma następną krotkę danych wejściowych i odpowiadające im etykiety. Zanim wprowadzimy dane wejściowe do naszego modelu sieci, musimy wyczyścić poprzedni gradient. Jest to wymagane, ponieważ po procesie wstecznym (procesie propagacji wstecznej) gradient zostanie kumulowany, a nie zastępowany. Następnie obliczymy straty na podstawie przewidywanej produkcji na podstawie oczekiwanej produkcji. Następnie wykonamy propagację wsteczną, aby obliczyć gradient, a na koniec zaktualizujemy parametry.
Oto wynik procesu szkoleniowego
[1, 	1] loss: 0.002
[1,  1001] loss: 2.302
[1,  2001] loss: 2.295
[1,  3001] loss: 2.204
[1,  4001] loss: 1.930
[1,  5001] loss: 1.791
[1,  6001] loss: 1.756
[1,  7001] loss: 1.744
[1,  8001] loss: 1.696
[1,  9001] loss: 1.650
[1, 10001] loss: 1.640
[1, 11001] loss: 1.631
[1, 12001] loss: 1.631
[1, 13001] loss: 1.624
[1, 14001] loss: 1.616
[2, 	1] loss: 0.001
[2,  1001] loss: 1.604
[2,  2001] loss: 1.607
[2,  3001] loss: 1.602
[2,  4001] loss: 1.596
[2,  5001] loss: 1.608
[2,  6001] loss: 1.589
[2,  7001] loss: 1.610
[2,  8001] loss: 1.596
[2,  9001] loss: 1.598
[2, 10001] loss: 1.603
[2, 11001] loss: 1.596
[2, 12001] loss: 1.587
[2, 13001] loss: 1.596
[2, 14001] loss: 1.603
Krok 4) Przetestuj model
Po wytrenowaniu naszego modelu należy przetestować lub ocenić go z innymi zestawami obrazów.
Użyjemy iteratora dla test_loader, który wygeneruje partię obrazów i etykiet, które zostaną przekazane do wytrenowanego modelu. Przewidywany wynik zostanie wyświetlony i porównany z oczekiwanym wynikiem.
#make an iterator from test_loader
#Get a batch of training images
test_iterator = iter(test_loader)
images, labels = test_iterator.next()

results = net(images)
_, predicted = torch.max(results, 1)

print('Predicted: ', ' '.join('%5s' % classes[predicted[j]] for j in range(4)))

fig2 = plt.figure()
for i in range(4):
   fig2.add_subplot(rows, columns, i+1)
   plt.title('truth ' + classes[labels[i]] + ': predict ' + classes[predicted[i]])
   img = images[i] / 2 + 0.5     # this is to unnormalize the image
   img = torchvision.transforms.ToPILImage()(img)
   plt.imshow(img)
plt.show()

