
Begeleid machinaal leren: Algorithms, Typen & Voorbeelden
 Redactie
⚡ Slimme samenvatting
Bij supervised machine learning wordt een algoritme getraind op gelabelde voorbeelden, zodat het uitkomsten kan voorspellen voor gegevens die het nog nooit eerder heeft gezien. Hierbij wordt regressie gebruikt voor numerieke doelen en classificatie voor categorische doelen zoals spam of fraude.
Wat is begeleid machine learning?
Supervised machine learning is een algoritme dat leert van gelabelde trainingsdata om uitkomsten te voorspellen voor onbekende data. Bij supervised learning train je de machine met data die al goed "gelabeld" is. Dit betekent dat sommige data al voorzien zijn van de juiste antwoorden. Het is vergelijkbaar met leren onder begeleiding van een supervisor of een leraar.
Het succesvol bouwen, schalen en implementeren van nauwkeurige, gecontroleerde machine learning-modellen vergt tijd en technische expertise van een team van zeer bekwame datawetenschappers. Datawetenschappers moeten de modellen bovendien periodiek opnieuw opbouwen, zodat de inzichten die ze genereren relevant blijven, ook als de onderliggende data verandert.
Hoe begeleid leren werkt
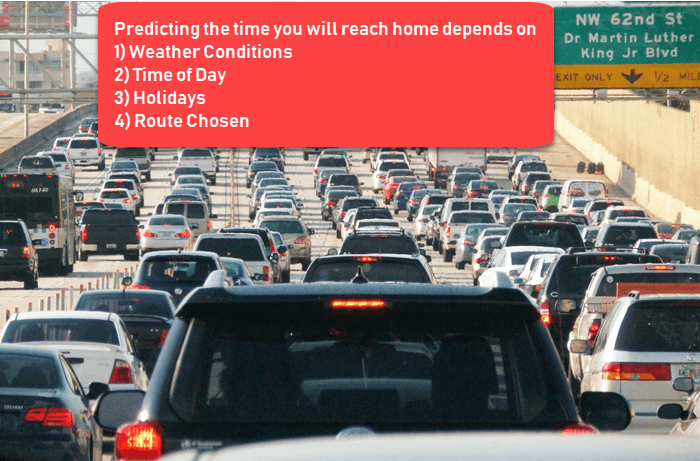
Machine learning onder toezicht maakt gebruik van trainingsdatasets om de gewenste resultaten te bereiken. Deze datasets bevatten input en de juiste output waardoor het model sneller leert. U wilt bijvoorbeeld een machine trainen om u te helpen voorspellen hoe lang het duurt voordat u van uw werkplek naar huis rijdt.
Hier begint u met het maken van een set gelabelde gegevens. Deze gegevens omvatten:
- Weersomstandigheden
- Tijd van de dag
- Holidays
- Gekozen route
Al deze details zijn uw invoer in dit voorbeeld van supervised learning. De uitvoer is de tijd die het kostte om op die specifieke dag terug naar huis te rijden, zoals de onderstaande afbeelding laat zien.
Je weet instinctief dat als het buiten regent, je er langer over doet om naar huis te rijden. Maar de machine heeft data en statistieken nodig.
Het eerste wat je moet doen, is een trainingsset aanmaken. Deze bevat de totale reistijd en bijbehorende factoren zoals het weer, de tijd, enzovoort. Op basis van deze trainingsset kan je machine een direct verband zien tussen de hoeveelheid regen en de tijd die je nodig hebt om thuis te komen.
Het bevestigt dus dat hoe meer het regent, hoe langer je onderweg bent naar huis. Het kan ook een verband leggen tussen het tijdstip waarop je van je werk vertrekt en de tijd die je onderweg bent. Hoe dichter het bij 18:00 uur is, hoe langer het duurt om thuis te komen.
Uw machine kan mogelijk enkele verbanden vinden met uw gelabelde gegevens. Deze leerfase wordt hieronder weergegeven.
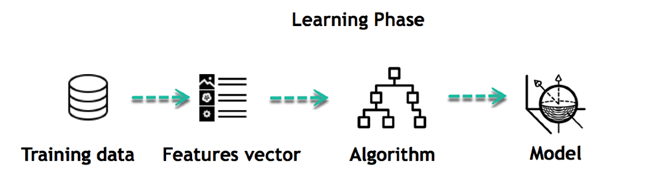
Dit is het begin van uw datamodel. Het registreert hoe regen het rijgedrag beïnvloedt en dat er op bepaalde tijdstippen van de dag meer mensen reizen.
Soorten begeleid machinaal leren Algorithms
Hieronder staan de typen Supervised Machine Learning-algoritmen:
Regressie
De regressietechniek voorspelt één continue uitvoerwaarde aan de hand van trainingsgegevens.
Voorbeeld: U kunt regressie gebruiken om de huizenprijs te voorspellen op basis van trainingsgegevens. De invoervariabelen zijn de locatie, de grootte van een huis, enz.
Sterke punten: De resultaten zijn gemakkelijk te interpreteren en het algoritme kan worden geregulariseerd om overfitting te voorkomen.
Nadelen: Een lineair model is niet flexibel, waardoor het zonder extra kenmerken geen complexe relaties kan weergeven.
Hier zijn een paar soorten regressie Algorithms:
- Lineaire regressie
- Polynomiale regressie
- Ridge- en Lasso-regressie
- Logistische regressie (voor classificatie)
- Beslissingsboom en random forest regressie
- Ondersteuning van vectorregressie
Logistieke regressie:
Logistische regressie wordt gebruikt om discrete waarden te schatten op basis van een gegeven set onafhankelijke variabelen. Het helpt je de waarschijnlijkheid van het optreden van een gebeurtenis te voorspellen door gegevens aan een logitfunctie aan te passen. Daarom wordt het ook wel logistische regressie genoemd. Omdat het een waarschijnlijkheid voorspelt, ligt de uitvoerwaarde tussen 0 en 1, en kan het minder goed presteren wanneer er meerdere of niet-lineaire beslissingsgrenzen zijn.
Classificatie
Classificatie betekent het groeperen van de uitvoer binnen een klasse. Als het algoritme probeert de invoer in twee verschillende klassen te labelen, wordt dit binaire classificatie genoemd. Het selecteren tussen meer dan twee klassen wordt multiclassificatie genoemd.
Voorbeeld: Vaststellen of iemand al dan niet in gebreke zal blijven met de terugbetaling van een lening.
Sterke punten: Classificatiebomen presteren in de praktijk zeer goed.
Nadelen: Omdat individuele bomen niet aan beperkingen onderhevig zijn, zijn ze gevoelig voor overfitting.
Hier zijn een paar soorten classificatie Algorithms:
- Naive Bayes classificatoren
- Beslissingsbomen
- Ondersteuning van Vector Machine
- K-dichtstbijzijnde buren
- Random forest en gradient boosting
Naïeve Bayes-classificatoren
De Naïeve Bayes Dit model is eenvoudig te bouwen en zeer nuttig voor grote datasets. De methode bestaat uit gerichte acyclische grafen met één ouder en meerdere kinderen. Er wordt uitgegaan van onafhankelijkheid tussen de kindknooppunten, die gescheiden zijn van hun ouder.
Beslissingsbomen
Beslissingsbomen classificeren een instantie door deze te sorteren op basis van de kenmerkwaarde. Bij deze methode is elk knooppunt een kenmerk van een instantie die geclassificeerd moet worden, en elke tak vertegenwoordigt een waarde die het knooppunt kan aannemen. Het is een veelgebruikte techniek voor classificatie.
Diezelfde structuur werkt ook voor regressie: een regressieboom helpt je bij het schatten van werkelijke waarden (kosten van de aanschaf van een auto, aantal telefoontjes, totale maandelijkse omzet, enz.).
Ondersteuning van Vector Machine
Support Vector Machine (SVM) is een type leer एल्गोरिtme dat in de jaren negentig is geïntroduceerd. Deze methode is gebaseerd op resultaten uit de statistische leertheorie die is ontwikkeld door Vladimir Vapnik en zijn collega's.
SVM's zijn ook nauw verbonden met kernelfuncties, een centraal concept voor de meeste leertaken. Het kernelraamwerk en SVM worden in diverse vakgebieden gebruikt, waaronder multimedia-informatie-retrieval, bio-informatica en patroonherkenning. Elke bovenstaande estimator wordt samen met zijn afstemmingsparameters beschreven in de documentatie. scikit-leren referentie.
Technieken voor machinaal leren met versus zonder supervisie
Door de methode ernaast te plaatsen zonder toezicht leren maakt zijn grenzen duidelijk.
| Gebaseerd op | Machine learning-techniek onder toezicht | Machine learning-techniek zonder toezicht |
|---|---|---|
| Invoergegevens | Algorithms worden getraind met behulp van gelabelde gegevens. | Algorithms worden gebruikt tegen gegevens die niet zijn gelabeld |
| Computationele complexiteit | Begeleid leren is een eenvoudiger methode. | Ongeleid leren is rekenkundig complex |
| Nauwkeurigheid | Zeer nauwkeurige en betrouwbare methode. | Less nauwkeurige en betrouwbare methode. |
| Typische algoritmen | Logistische regressie, beslissingsbomen, SVM, Naïeve Bayes | K-means, hiërarchische clustering, PCA |
| Hoe de resultaten worden beoordeeld | Beoordeeld aan de hand van bekende antwoorden (nauwkeurigheid, RMSE) | Beoordeeld op basis van interne criteria en menselijke toetsing. |
Uitdagingen in machinaal leren onder supervisie
Dit zijn de uitdagingen waarmee men te maken krijgt bij machinaal leren onder toezicht:
- Irrelevante invoerkenmerken in de trainingsgegevens kunnen tot onnauwkeurige resultaten leiden.
- Het voorbereiden en voorbewerken van gegevens is altijd een uitdaging.
- De nauwkeurigheid lijdt eronder wanneer onmogelijke, onwaarschijnlijke en onvolledige waarden als trainingsgegevens zijn ingevoerd.
- Als de betreffende expert niet beschikbaar is, is de andere aanpak de "brute-force"-methode. Dat betekent dat je moet gokken op welke kenmerken (invoervariabelen) je de machine moet trainen, en die gok kan onnauwkeurig zijn.
Voordelen van begeleid leren
Tegenover deze uitdagingen staan de volgende voordelen van supervised machine learning:
- Begeleid leren in Machine leren Hiermee kunt u gegevens verzamelen of een gegevensuitvoer genereren op basis van eerdere ervaringen.
- Helpt u prestatiecriteria te optimaliseren op basis van ervaring
- Machine learning onder toezicht helpt u bij het oplossen van verschillende soorten rekenproblemen in de echte wereld.
Nadelen van begeleid leren
Hieronder volgen de nadelen van supervised machine learning:
- De beslissingsgrens kan overtraind zijn als uw trainingsset geen voorbeelden bevat die u in een klasse wilt hebben.
- U moet uit elke klas veel goede voorbeelden selecteren terwijl u de classificator traint.
- Het classificeren van big data kan een behoorlijke uitdaging zijn.
- Het trainen van begeleid leren vergt veel rekentijd.
Beste praktijken voor begeleid leren
De volgende reeks stappen zorgt ervoor dat een project blijft draaien. track:
- Voordat je iets anders doet, bepaal je welk type data je als trainingsset wilt gebruiken.
- Bepaal de structuur van de te leren functie en het leer एल्गोरिtm.
- Verzamel de bijbehorende resultaten, hetzij van menselijke experts, hetzij door middel van metingen.
- Houd een testset apart die het model nooit te zien krijgt en rapporteer de score daarop.
