
Machine learning zonder toezicht: Algorithms, Soorten & Voorbeelden
 Evelien Clarke
⚡ Slimme samenvatting
Ongecontroleerd leren is een machine learning-techniek die werkt met ongelabelde data, waarbij het model zelf structuur ontdekt door middel van clustering, associatieregels en dimensionaliteitsreductie, in plaats van op basis van vooraf gegeven antwoorden.
Wat is onbegeleid leren?
Ongecontroleerd leren is een machine learning-techniek waarbij de gebruiker het model niet hoeft te begeleiden. In plaats daarvan laat het het model zelfstandig patronen en informatie ontdekken die voorheen onopgemerkt bleven. Het wordt voornamelijk gebruikt met ongelabelde data.
Niet-gecontroleerd leren Algorithms
Niet-gecontroleerd leren Algorithms stellen gebruikers in staat complexere verwerkingstaken uit te voeren in vergelijking met leren onder toezichtOngecontroleerd leren kan echter onvoorspelbaarder zijn dan methoden die getraind zijn op basis van bekende antwoorden. Algoritmen voor ongecontroleerd leren omvatten clustering, anomaliedetectie, dimensionaliteitsreductie en zelforganiserende neurale netwerken.
Voorbeeld van machinaal leren zonder toezicht
Laten we een voorbeeld nemen van onbegeleid leren bij een baby en haar familiehond. De eerste afbeelding toont het huisdier dat de baby al herkent.
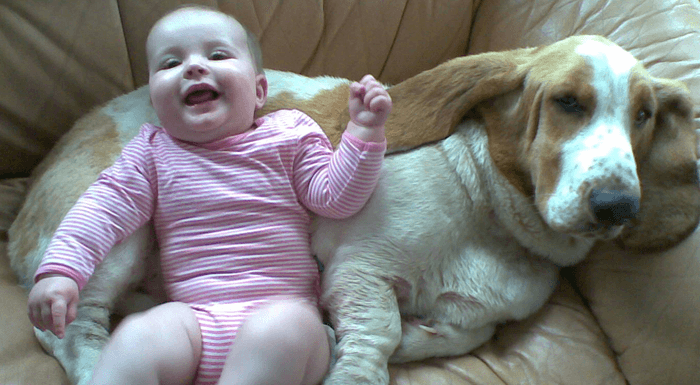
Ze kent en herkent deze hond. Een paar weken later brengt een vriend van de familie een hond mee en probeert met de baby te spelen. Die tweede, onbekende hond is hieronder te zien.
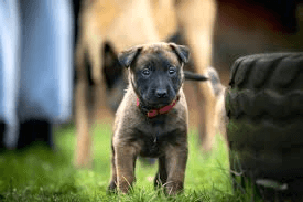
De baby heeft deze hond nog nooit eerder gezien. Maar ze herkent veel kenmerken (2 oren, ogen, lopen op 4 poten) die overeenkomen met die van haar eigen hond. Ze identificeert het nieuwe dier als een hond. Dit is onbegeleid leren, waarbij je niet wordt aangeleerd, maar leert van de gegevens (in dit geval gegevens over een hond). Als dit begeleid leren was geweest, zou de vriend van de familie de baby hebben verteld dat het een hond is, zoals in het bovenstaande voorbeeld van onbegeleid leren te zien is.
Waarom onbegeleid leren?
Hieronder volgen de belangrijkste redenen om onbegeleid leren te gebruiken in Machine leren:
- Ongecontroleerd machinaal leren vindt allerlei onbekende patronen in data.
- Met methoden zonder toezicht kunt u functies vinden die nuttig kunnen zijn voor categorisering.
- Het systeem kan direct met de binnenkomende data werken, waardoor inkomende records worden geanalyseerd en gegroepeerd zonder dat er eerst een mens aan hoeft te werken om ze te labelen.
- Het is gemakkelijker om ongelabelde gegevens van een computer te halen dan gelabelde gegevens, waarvoor handmatige tussenkomst nodig is.
ClusterSoorten onbegeleid leren Algorithms
Problemen met onbegeleid leren worden verder onderverdeeld in clustering-, associatie- en dimensionaliteitsreductieproblemen. ClusterBij het groeperen van records worden vergelijkbare gegevens gegroepeerd, associatie vindt items die samen voorkomen en dimensionaliteitsreductie comprimeert veel kenmerken tot een paar.
ClusterING
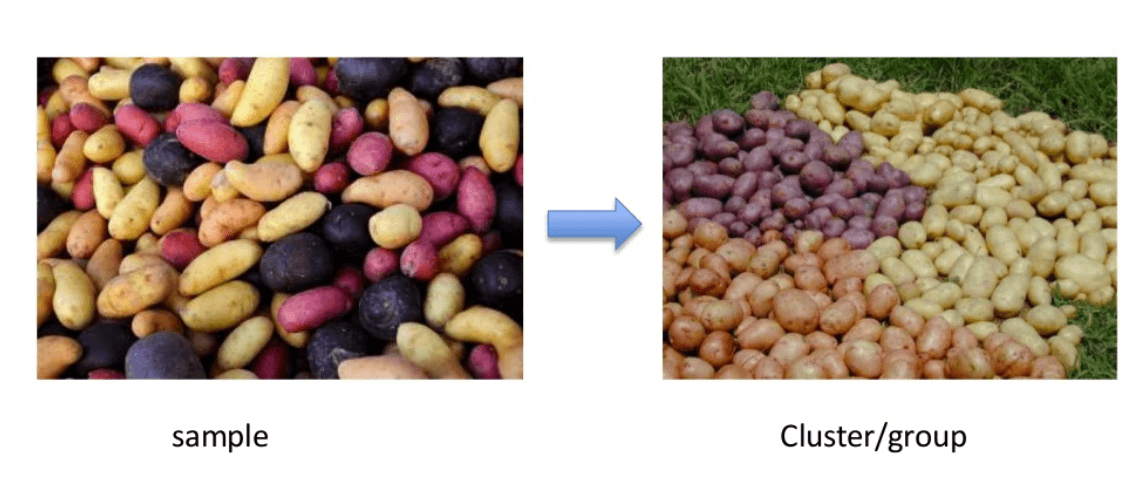
Clustering is een belangrijk concept als het gaat om onbegeleid leren. Het gaat vooral over het vinden van een structuur of patroon in een verzameling ongecategoriseerde gegevens. Ongecontroleerd leren ClusterDe algoritmes verwerken uw gegevens en vinden natuurlijke clusters (groepen) indien deze in de gegevens aanwezig zijn. U kunt ook aanpassen hoeveel clusters de algoritmes moeten identificeren. Hiermee kunt u de granulariteit van deze groepen aanpassen. Het onderstaande diagram toont verspreide records die zijn onderverdeeld in afzonderlijke groepen.
Er zijn verschillende soorten clustering die u kunt gebruiken:
Exclusief (partitionering)
Bij deze clusteringmethode worden gegevens zodanig gegroepeerd dat één record slechts tot één cluster kan behoren.
Voorbeeld: K-betekent
Agglomeratief
Bij deze clusteringtechniek begint elk record als een eigen cluster. Door de iteratieve samenvoeging van de twee dichtstbijzijnde clusters wordt het aantal clusters verminderd.
Voorbeeld: Hiërarchische clustering
overlapping
Bij deze techniek, vage sets worden gebruikt om gegevens te clusteren. Elk punt kan tot twee of meer clusters behoren, elk met een eigen mate van lidmaatschap.
Hier worden gegevens gekoppeld aan een passende lidmaatschapswaarde. Voorbeeld: Fuzzy C-middelen
Probabilistisch
Deze techniek maakt gebruik van een kansverdeling om de clusters te creëren.
Voorbeeld: De volgende trefwoorden
- “mannenschoen.”
- “damesschoen.”
- “dameshandschoen.”
- “mannenhandschoen.”
Ze kunnen worden onderverdeeld in twee categorieën: 'schoen' en 'handschoen', of 'man' en 'vrouw'.
Clustertypen
Hieronder volgen de algoritmen die het meest voorkomen in onbegeleid machinaal leren. De eerste twee groeperen records, de laatste drie reduceren dimensies in plaats van clusters te vormen, en K-NN wordt genoemd omdat het vaak verward wordt met K-means.
- Hiërarchische clustering — clustering
- K-means clustering — clustering
- K-NN (k nearest neighbors) — een supervised classifier, geen clusteringmethode.
- Hoofdcomponentenanalyse — dimensionale reductie
- Singuliere waardeontbinding — dimensionale reductie
- Onafhankelijke componentenanalyse — dimensionale reductie
hiërarchische ClusterING
Hiërarchische clustering is een algoritme dat een hiërarchie van clusters opbouwt. Het begint met alle data die aan een eigen cluster worden toegewezen. Twee clusters die dicht bij elkaar liggen, worden samengevoegd tot één cluster. Dit algoritme eindigt wanneer er nog maar één cluster overblijft. Het definieert twee concepten die het waard zijn om afzonderlijk te benoemen.
Agglomeratieve clustering
Deze bottom-up vorm van hiërarchische clustering vereist niet dat het aantal clusters K als invoer wordt gegeven. Het agglomeratieproces begint met het vormen van elk record als een afzonderlijk cluster.
Deze methode maakt gebruik van een afstandsmaat en reduceert het aantal clusters (één in elke iteratie) door middel van een samenvoegingsproces. Uiteindelijk hebben we één groot cluster dat alle objecten bevat, en de analist snijdt de boom af op de hoogte die een zinvol aantal groepen oplevert.
dendrogram
Bij de dendrogramclusteringsmethode vertegenwoordigt elk niveau een mogelijke cluster. De hoogte van het dendrogram geeft de mate van gelijkenis tussen twee samengevoegde clusters weer. Hoe dichter ze zich bij de onderkant van het proces bevinden, hoe meer de clusters op elkaar lijken; het kiezen van de snede die de uiteindelijke groepen definieert, is niet automatisch en grotendeels subjectief.
K-betekent ClusterING
K-means is een iteratief clusteringalgoritme dat de groepen verfijnt.ping Bij elke iteratie. Aanvankelijk wordt het gewenste aantal clusters geselecteerd. Bij deze clusteringmethode moeten de datapunten in k groepen worden verdeeld. Een grotere k betekent kleinere groepen met een hogere granulariteit; een kleinere k betekent grotere groepen met een lagere granulariteit.
De output van het algoritme is een groep "labels". Het wijst elk datapunt toe aan een van de k groepen. Bij k-means clustering wordt elke groep gedefinieerd door een centroid voor die groep te creëren. De centroids zijn als het hart van de cluster, die de punten die er het dichtst bij liggen opvangen en aan de cluster toevoegen.
K- Dichtstbijzijnde buren
K-nearest neighbour is de eenvoudigste van alle machine learning-classificatiemethoden. Het verschilt van andere machine learning-technieken doordat het geen model produceert. Het is een eenvoudig algoritme dat alle beschikbare gevallen opslaat en nieuwe instanties classificeert op basis van een gelijkenismaat. Omdat het gelabelde gevallen nodig heeft om mee te classificeren, is K-NN een supervised learning-methode; het wordt hier alleen genoemd omdat de op afstand gebaseerde logica lijkt op clustering.
Het werkt erg goed wanneer er een zinvolle afstand tussen de voorbeelden is. De leersnelheid is laag wanneer de trainingsset groot is en de afstandsberekening niet triviaal is.
Analyse van hoofdcomponenten
Hoofdcomponentenanalyse neemt een hoogdimensionale ruimte en selecteert een nieuwe basis, keeping Alleen de belangrijkste scores worden behouden. Elke richting in deze basis wordt een hoofdcomponent genoemd. De subset die je behoudt, vormt een nieuwe ruimte die kleiner is dan de oorspronkelijke ruimte. Het behoudt zoveel mogelijk van de complexiteit van de data.
Vereniging
Associatieregels stellen je in staat om verbanden te leggen tussen dataobjecten in grote databases. Deze onbegeleide techniek draait om het ontdekken van interessante relaties tussen variabelen in grote databases en is een essentieel onderdeel van... dataminingMensen die bijvoorbeeld een nieuw huis kopen, kopen doorgaans ook nieuwe meubels.
Andere voorbeelden:
- Een subgroep van kankerpatiënten ingedeeld op basis van hun genexpressiemetingen.
- Groepen shoppers op basis van hun browse- en aankoopgeschiedenis.
- Films gegroepeerd op basis van de beoordelingen van kijkers.
Onder toezicht versus onbewaakt machinaal leren
Hier is het belangrijkste verschil tussen Begeleid versus onbewaakt leren:
| Kenmerken | Machine learning-techniek onder toezicht | Machine learning-techniek zonder toezicht |
| Invoergegevens | Algorithms worden getraind met behulp van gelabelde gegevens. | Algorithms worden gebruikt tegen gegevens die niet zijn gelabeld |
| Computationele complexiteit | Begeleid leren is een eenvoudiger methode. | Ongeleid leren is rekenkundig complex |
| Nauwkeurigheid | De nauwkeurigheid kan direct worden gemeten aan de hand van bekende labels. | Nauwkeurigheid kan niet direct worden gemeten; resultaten vereisen interpretatie. |
| Typische output | Een voorspelling voor elk nieuw record. | Groepen, regels of gecomprimeerde kenmerken |
Toepassingen van machinaal leren zonder toezicht
Enkele toepassingen van technieken voor onbegeleid leren zijn:
- Clustering verdeelt de dataset automatisch in groepen op basis van hun overeenkomsten.
- Anomaliedetectie kan ongebruikelijke datapunten in uw dataset ontdekken. Het is handig voor het opsporen van frauduleuze transacties
- Association mining identificeert sets van items die vaak samen voorkomen in uw dataset
- Latente variabele modellen worden veel gebruikt voor data-voorverwerking, zoals het reduceren van het aantal kenmerken in een dataset of het opsplitsen van de dataset in meerdere componenten.
Nadelen van leren zonder toezicht
- Je kunt geen precieze informatie krijgen over de sortering van gegevens, omdat de gegevens die in onbegeleid leren worden gebruikt, niet gelabeld zijn en de werkelijke groepering ervan onbekend is.ping is niet bekend
- Less De nauwkeurigheid van de resultaten is afhankelijk van de invoergegevens, die niet bekend zijn en niet van tevoren door mensen zijn gelabeld. Dit betekent dat de machine dit zelf moet doen.
- De spectrale klassen komen niet altijd overeen met informatieklassen.
- De gebruiker moet tijd besteden aan het interpreteren en labelen van de klassen die voortvloeien uit de classificatie.
- De spectrale eigenschappen van klassen kunnen in de loop van de tijd veranderen, waardoor je niet dezelfde klasse-informatie kunt behouden wanneer je van de ene afbeelding naar de andere overgaat.
