
Handleiding voor kunstmatige neurale netwerken (ANN) met TensorFlow
 Redactie
⚡ Slimme samenvatting
Kunstmatige neurale netwerken leren door invoer door verbonden lagen te sturen, het resultaat te beoordelen met een verliesfunctie en de gewichten te corrigeren met een optimizer. Deze handleiding bouwt er een in TensorFlow en classificeert cijfers uit de MNIST-dataset.
Wat is een kunstmatig neuraal netwerk?
An Kunstmatig neuraal netwerk (ANN) Een kunstmatig neuraal netwerk is een computersysteem, geïnspireerd op biologische neurale netwerken, voor het creëren van kunstmatige hersenen op basis van een verzameling verbonden eenheden, kunstmatige neuronen genaamd. Het is ontworpen om informatie te analyseren en te verwerken zoals mensen dat doen. Een kunstmatig neuraal netwerk heeft zelflerende eigenschappen om betere resultaten te leveren naarmate er meer gegevens beschikbaar komen.
Het onderstaande diagram tracDit betekent één volledige doorgang door zo'n netwerk, van de ruwe invoer tot de optimalisator die de gewichten corrigeert.

Een kunstmatig neuraal netwerk (ANN) bestaat uit vier hoofdobjecten:
- Lagen: Al het leerproces vindt plaats in de lagen. Er zijn 3 lagen: 1) Invoer, 2) Verborgen en 3) Uitvoer.
- Kenmerk en label: Inputgegevens voor het netwerk (kenmerken) en output van het netwerk (labels)
- Verlies functie: Metriek gebruikt om de prestaties van de leerfase te beoordelen.
- Optimizer: Verbeter het leerproces door de kennis in het netwerk bij te werken.
Een neuraal netwerk neemt de invoergegevens en voert deze in een ensemble van lagen. Het netwerk evalueert vervolgens zijn prestaties met behulp van een verliesfunctie. De verliesfunctie geeft het netwerk een idee van het pad dat het moet volgen voordat het de kennis beheerst. Het netwerk verbetert die kennis met behulp van een optimalisator.
Als je de figuur hierboven bekijkt, begrijp je het onderliggende mechanisme.
Het programma neemt een aantal invoerwaarden en stuurt deze door naar twee volledig verbonden lagen. Stel je voor dat je een wiskundeprobleem hebt. Je leest eerst het bijbehorende hoofdstuk om het op te lossen. Vervolgens pas je je nieuwe kennis toe op het probleem. De kans is groot dat je niet zo'n goed resultaat behaalt. Hetzelfde geldt voor een neuraal netwerk: de eerste keer dat het de data ziet en een voorspelling doet, zal het resultaat niet perfect overeenkomen met de werkelijke data.
Om zijn kennis te verbeteren, gebruikt het netwerk een optimizer. In deze analogie kun je een optimizer zien als het herlezen van een hoofdstuk. Je verkrijgt nieuwe inzichten door opnieuw te lezen. Op dezelfde manier gebruikt het netwerk de optimizer, werkt het zijn kennis bij en test het die nieuwe kennis om te controleren hoeveel het nog moet leren. Het programma herhaalt deze stap totdat het de laagst mogelijke fout maakt.
In de analogie met een wiskundeprobleem betekent dit dat je een hoofdstuk in een leerboek meerdere keren leest totdat je de lesstof volledig begrijpt. Zelfs na meerdere keren lezen, als je nog steeds fouten maakt, betekent dit dat je het maximale uit je kennis van de huidige stof hebt gehaald. Je moet een ander leerboek gebruiken of een andere methode uitproberen om je score te verbeteren. Voor een neuraal netwerk is dit hetzelfde proces. Als het aantal fouten niet meer afneemt en de verliescurve vlak wordt, kan de huidige architectuur niets meer leren. Het netwerk moet beter geoptimaliseerd worden om de kennis te vergroten.
Die vier objecten komen rechtstreeks overeen met de componenten die u configureert bij het ontwerpen van een netwerk.
Neural Network Architectuur
De architectuur van een kunstmatig neuraal netwerk bestaat uit de volgende componenten:
- Lagen
- Activering functie
- Verliesfunctie
- Optimizer
Lagen
Een laag is de plek waar al het leerproces plaatsvindt. Binnen een laag bevindt zich een willekeurig aantal neuronen, elk met zijn eigen gewichten. Een typisch neuraal netwerk wordt vaak verwerkt door dicht verbonden lagen (ook wel volledig verbonden lagen genoemd). Dit betekent dat alle ingangen met de uitgang zijn verbonden.
Een typisch neuraal netwerk ontvangt een vector met invoerwaarden en een scalaire waarde die de labels bevat. De eenvoudigste opzet is een binaire classificatie met slechts twee klassen: 0 en 1.
Het netwerk ontvangt een invoer, stuurt deze naar alle verbonden knooppunten en berekent het signaal met behulp van een activeringsfunctie. Het onderstaande genummerde diagram vergroot één knooppunt uit, zodat u de gewogen som en de activeringsstap afzonderlijk kunt zien.

De bovenstaande afbeelding illustreert dit idee. De eerste laag bevat de invoerwaarden. De tweede laag, de zogenaamde verborgen laag, ontvangt de gewogen invoer van de vorige laag.
- Het eerste knooppunt bevat de invoerwaarden.
- De neuron wordt opgedeeld in een invoergedeelte en een activeringsfunctie. Het linkergedeelte ontvangt alle invoer van de vorige laag. Het rechtergedeelte is de som van de invoer die aan een activeringsfunctie wordt doorgegeven.
- De uitvoerwaarde wordt berekend op basis van de verborgen lagen en gebruikt om een voorspelling te doen. Bij classificatie is deze gelijk aan het aantal klassen. Bij regressie wordt slechts één waarde voorspeld.
Activering functie
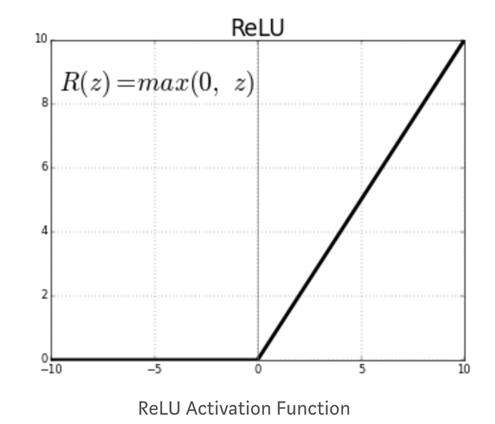
De activeringsfunctie van een knooppunt definieert de uitvoer op basis van een set invoerwaarden. Je hebt een activeringsfunctie nodig om het netwerk in staat te stellen niet-lineaire patronen te leren. Een veelgebruikte activeringsfunctie is ReLU, de Rectified Linear Unit. Deze functie geeft een nulwaarde voor alle negatieve waarden.
De andere activeringsfuncties zijn:
- Stuksgewijs lineair
- sigmoïde
- Tanho
- Lekkende ReLU
De onderstaande grafiek laat zien waarom ReLU op die manier wordt beschreven: de curve is vlak bij nul voor elke negatieve invoer en stijgt daarna lineair.
De cruciale beslissing die u moet nemen bij het bouwen van een neuraal netwerk is:
- Hoeveel lagen in het neurale netwerk
- Hoeveel verborgen eenheden voor elke laag
Neurale netwerken met veel lagen en verborgen eenheden kunnen een complexe representatie van de data leren, maar dit maakt de berekeningen van het netwerk erg kostbaar.
Verliesfunctie
Nadat u de verborgen lagen en de activeringsfunctie hebt gedefinieerd, moet u de verliesfunctie en de optimalisatie opgeven.
Voor binaire classificatie is het gebruikelijk om een binaire kruisentropieverliesfunctie te gebruiken. lineaire regressieJe gebruikt de gemiddelde kwadratische fout.
De verliesfunctie is een belangrijke maatstaf om de prestaties van de optimizer te schatten. Tijdens de training wordt deze statistiek geminimaliseerd. U moet deze hoeveelheid zorgvuldig selecteren, afhankelijk van het type probleem waarmee u te maken heeft.
Optimizer
De verliesfunctie is een maatstaf voor de prestaties van het model. De optimizer helpt bij het verbeteren van de gewichten van het netwerk om het verlies te verminderen. Er zijn verschillende optimizers beschikbaar, maar de meest gebruikte is stochastische gradiëntdaling (Stochastic Gradient Descent).
De conventionele optimizers zijn:
- Momentum optimalisatie
- Nesterov Versnelde Gradiënt
- AdaGrad
- Adam-optimalisatie
ArchiDe structuur alleen garandeert geen bruikbaar model.
Beperkingen van het neurale netwerk
Hieronder volgen de beperkingen van een neuraal netwerk:
overfitting
Een veelvoorkomend probleem bij complexe neurale netwerken is de moeilijkheid om te generaliseren naar onbekende data. Een neuraal netwerk met veel gewichten kan specifieke details in de trainingsset zeer goed herkennen, maar dat leidt vaak tot overfitting. Als de data binnen groepen onevenwichtig verdeeld zijn (dat wil zeggen, er is onvoldoende data beschikbaar in sommige groepen), zal het netwerk tijdens de training zeer goed leren, maar niet in staat zijn om dergelijke patronen te generaliseren naar nooit eerder geziene data.
Er is een afweging te maken bij machine learning tussen optimalisatie en generalisatie.
- Het optimaliseren van een model vereist het vinden van de beste parameters die het verlies van de trainingsset minimaliseren.
- Generalisatie vertelt echter hoe het model zich gedraagt voor onzichtbare gegevens.
Om te voorkomen dat het model specifieke details of ongewenste patronen in de trainingsdata vastlegt, kunt u verschillende technieken gebruiken. De beste methode is een gebalanceerde dataset met voldoende gegevens. Het verminderen van overfitting wordt regularisatie genoemd. De drie onderstaande technieken zijn de gebruikelijke uitgangspunten.
| Techniek | Wat het beperkt | Typische instelling in deze handleiding |
|---|---|---|
| Netwerkgrootte | Het aantal lagen en verborgen eenheden | Twee verborgen lagen, 300 en 100 eenheden |
| L1/L2 gewichtsregularisatie | De omvang van de gewichtscoëfficiënten | l1_regularisatiesterkte en l2_regularisatiesterkte van 0.01 |
| Afvaller | Het percentage uitgeschakelde eenheden per trainingsstap. | uitval van 0.3 |
Netwerkgrootte
Een neuraal netwerk met te veel lagen en verborgen eenheden staat erom bekend zeer complex te zijn. Een eenvoudige manier om de complexiteit van het model te verminderen, is door de omvang ervan te verkleinen. Er is geen eenduidige beste methode om het aantal lagen te bepalen. Je moet beginnen met een klein aantal lagen en de omvang geleidelijk vergroten totdat je merkt dat het model overfit.
Gewichtsregularisatie
Een standaardtechniek om overfitting te voorkomen is het toevoegen van beperkingen aan de gewichten van het netwerk. De beperking zorgt ervoor dat de gewichten van het netwerk alleen kleine waarden aannemen. De beperking wordt toegevoegd aan de verliesfunctie van de fout. Er zijn twee soorten regularisatie:
- L1 (Lasso): De kosten zijn evenredig met de absolute waarde van de gewichtscoëfficiënten.
- L2 (Ridge): De kosten zijn evenredig met het kwadraat van de waarde van de gewichtscoëfficiënten.
Afvaller
Dropout is een bijzondere maar nuttige techniek. Een neuraal netwerk met dropout betekent dat sommige eenheden willekeurig worden uitgeschakeld tijdens een trainingsstap, waardoor hun uitgaande signaal nul wordt. Stel je voor dat je een array met gewichten hebt van [0.1, 1.7, 0.7, -0.9]. Als het neurale netwerk dropout heeft, wordt het [0.1, 0, 0, -0.9] met willekeurig verdeelde nullen. De parameter die de dropout regelt, is de dropout rate. Deze rate bepaalt hoeveel eenheden worden uitgeschakeld. Een rate tussen 0.2 en 0.5 is gebruikelijk.
Een klein interactief voorbeeld maakt de trainingscyclus gemakkelijk te volgen.
Voorbeeld van neuraal netwerk in TensorFlow
Hier is een voorbeeld van een kunstmatig neuraal netwerk in actie, dat laat zien hoe een neuraal netwerk werkt bij een typisch classificatieprobleem. Er zijn twee invoerwaarden, x1 en x2, elk met een willekeurige waarde. De uitvoer is een binaire klasse. Het doel is om het label te classificeren op basis van de twee kenmerken. Om deze taak uit te voeren, wordt de architectuur van het neurale netwerk als volgt gedefinieerd:
- Twee verborgen lagen
- De eerste laag heeft vier volledig verbonden neuronen
- De tweede laag heeft twee volledig verbonden neuronen
- De activeringsfunctie is een ReLU.
- Voeg een L2-regularisatie toe met een leerpercentage van 0.003
Het netwerk optimaliseert de gewichten gedurende 180 iteraties met een batchgrootte van 10. In de onderstaande animatie van het ANN-voorbeeld kunt u zien hoe de gewichten in de loop van de tijd evolueren en hoe het netwerk de classificatiekaart verbetert.ping.

Allereerst kent het netwerk willekeurige waarden toe aan alle gewichten.
- Met de willekeurige gewichten, dus zonder optimalisatie, is het uitvoerverlies 0.453. De onderstaande afbeelding toont het netwerk met verschillende kleuren.
- Over het algemeen vertegenwoordigt de oranje kleur negatieve waarden, terwijl de blauwe kleuren de positieve waarden weergeven.
- De gegevenspunten hebben dezelfde weergave: de blauwe punten staan voor de positieve labels en de oranje punten voor de negatieve labels.

In de tweede verborgen laag zijn de lijnen gekleurd op basis van het teken van de gewichten. De oranje lijnen vertegenwoordigen negatieve gewichten en de blauwe lijnen positieve gewichten.
Zoals u kunt zien, in de uitvoerkaart.pingHet netwerk maakt nogal wat fouten. Kijk nu eens hoe het netwerk zich gedraagt na optimalisatie.
De onderstaande afbeelding van het ANN-voorbeeld toont de resultaten van het geoptimaliseerde netwerk. U ziet direct dat het netwerk succesvol heeft geleerd hoe de datapunten te classificeren. Ter vergelijking: het initiële gewicht was -0.43, terwijl het na optimalisatie -0.95 is.

Het idee kan worden gegeneraliseerd voor netwerken met meer verborgen lagen en neuronen. Je kunt zelf experimenteren met de instellingen in de TensorFlow-speeltuin.
De onderstaande stappen bouwen hetzelfde idee uit in code met behulp van een echte dataset.
Hoe u een neuraal netwerk kunt trainen met TensorFlow
Hieronder vind je een stapsgewijze handleiding voor het trainen van een neuraal netwerk. TensorFlow ANN maakt gebruik van de DNNClassifier-estimator van de API.
We zullen de MNIST-dataset gebruiken om uw eerste neurale netwerk te trainen. Een neuraal netwerk trainen met TensorFlow Het is niet erg ingewikkeld. De voorverwerkingsstap ziet er precies hetzelfde uit als in de vorige tutorials. Je gaat als volgt te werk:
- Importeer de gegevens
- Transformeer de gegevens
- Construeer de tensor
- Bouw het model
- Train en evalueer het model
- Verbeter het model
Versie-opmerking: De code in deze handleiding is gericht op de TensorFlow 1.x Estimator API. De laatste versie van het tf-estimator-pakket werd meegeleverd met TensorFlow 2.15, en tf.estimator is verwijderd in TensorFlow 2.16. Om deze stappen uit te voeren met een recentere versie, moet u TensorFlow 2.15 vastzetten of hetzelfde tweelaags netwerk opnieuw opbouwen met tf.keras.layers.Dense en model.fit().
Stap 1) Importeer de gegevens
Allereerst moet je de benodigde bibliotheek importeren. Je kunt de MNIST-dataset importeren met behulp van scikit-leren zoals te zien is in het onderstaande TensorFlow neurale netwerkvoorbeeld.
De MNIST-dataset is de meest gebruikte dataset om nieuwe technieken of algoritmen te testen. Het is een verzameling afbeeldingen van 28×28 pixels, die elk een handgeschreven cijfer van 0 tot en met 9 tonen. Een team van diepe convolutionele netwerken, getraind met elastische vervormingen, wist de testfout terug te brengen tot 0.27 procent.
import numpy as np
import tensorflow as tf
np.random.seed(1337)
De oorspronkelijke handleiding downloadde de MNIST-bestanden handmatig en verwees fetch_mldata naar die map.
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata(' /Users/Thomas/Dropbox/Learning/Upwork/tuto_TF/data/mldata/MNIST original')
print(mnist.data.shape)
print(mnist.target.shape)
API-opmerking: mldata.org is niet langer online en fetch_mldata is verwijderd in scikit-learn 0.22. Vervang in een recente installatie de bovenstaande aanroep door fetch_openml('mnist_784', version=1), waarmee dezelfde 70,000 cijfers worden gedownload en dezelfde gegevens en doelkenmerken beschikbaar worden gesteld.
Daarna splits je de gegevens en krijg je de vorm van beide datasets.
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(mnist.data, mnist.target, test_size=0.2, random_state=42)
y_train  = y_train.astype(int)
y_test  = y_test.astype(int)
batch_size =len(X_train)

print(X_train.shape, y_train.shape,y_test.shape )
Stap 2) Transformeer de gegevens
In de vorige tutorial heb je geleerd dat je de data moet transformeren om het effect van uitschieters te beperken. In deze tutorial over neurale netwerken transformeer je de data met behulp van de min-max scaler. De formule is:
(X-min_x)/(max_x - min_x)
scikit-learn heeft daar al een functie voor: MinMaxScaler().
## resclae
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
# Train
X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
# test
X_test_scaled = scaler.fit_transform(X_test.astype(np.float64))
Stap 3) Construeer de tensor
Je bent nu bekend met de manier om te creëren. tensoren In TensorFlow kun je de trainingsset omzetten naar een numerieke kolom.
feature_columns = [tf.feature_column.numeric_column('x', shape=X_train_scaled.shape[1:])]
Stap 4) Bouw het model
De architectuur van het neurale netwerk bevat 2 verborgen lagen met respectievelijk 300 en 100 eenheden. Deze waarden zijn gebaseerd op ervaring en niet op een formule. Je kunt ze aanpassen en zien hoe ze de nauwkeurigheid van het netwerk beïnvloeden.
Om het model te bouwen, gebruikt u de estimator DNNClassifier. U moet het aantal klassen instellen op 10, aangezien er tien klassen in de trainingsset zitten. U bent al bekend met de syntaxis van het estimator-object. De argumenten feature_columns, n_classes en model_dir zijn precies hetzelfde als in de vorige tutorial. Het argument hidden_units is nieuw: het bepaalt zowel het aantal lagen als het aantal knooppunten dat elke laag met het neurale netwerk verbindt. In de onderstaande code zijn er twee verborgen lagen, de eerste verbindt 300 knooppunten en de tweede 100 knooppunten.
Om de schatter te bouwen, gebruikt u tf.estimator.DNNClassifier met de volgende parameters:
- feature_columns: Definieer de kolommen die in het netwerk gebruikt moeten worden.
- verborgen_eenheden: Definieer het aantal verborgen neuronen.
- n_klassen: Definieer het aantal klassen dat voorspeld moet worden.
- model_dir: Definieer het pad van TensorBoard
estimator = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    n_classes=10,
    model_dir = '/train/DNN')
Stap 5) Train en evalueer het model
Je kunt de NumPy-inputfunctie gebruiken om het model te trainen en te evalueren.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_train_scaled},
    y=y_train,
    batch_size=50,
    shuffle=False,
    num_epochs=None)
estimator.train(input_fn = train_input,steps=1000)
eval_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_test_scaled},
    y=y_test,
    shuffle=False,
    batch_size=X_test_scaled.shape[0],
    num_epochs=1)
estimator.evaluate(eval_input,steps=None)
Output:
{'accuracy': 0.9637143,
 'average_loss': 0.12014342,
 'loss': 1682.0079,
 'global_step': 1000}
De huidige architectuur leidt tot een nauwkeurigheid van ongeveer 96 procent op de evaluatieset.
Stap 6) Verbeter het model
U kunt proberen het model te verbeteren door regularisatieparameters toe te voegen.
Hier gebruikt de schatter een Proximal AdaGrad-optimizer met een dropout-rate van 0.3 en zowel de L1- als de L2-sterkte ingesteld op 0.01. In een neuraal netwerk van TensorFlow bereik je de optimizer via het `train`-object, gevolgd door de naam van de optimizer. TensorFlow biedt een ingebouwde API voor de Proximal AdaGrad-optimizer.
Om regularisatie toe te voegen aan het diepe neurale netwerk, kunt u tf.train.ProximalAdagradOptimizer gebruiken met de volgende parameters:
- Leersnelheid: leertempo
- L1-regularisatie: l1_regularisatie_sterkte
- L2-regularisatie: l2_regularisatie_sterkte
estimator_imp = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    dropout=0.3,
    n_classes = 10,
    optimizer=tf.train.ProximalAdagradOptimizer(
      learning_rate=0.01,
      l1_regularization_strength=0.01,
      l2_regularization_strength=0.01
    ),
    model_dir = '/train/DNN1')
estimator_imp.train(input_fn = train_input,steps=1000)
estimator_imp.evaluate(eval_input,steps=None)
Output:
{'accuracy': 0.95057142,
 'average_loss': 0.17318928,
 'loss': 2424.6499,
 'global_step': 2000}
De waarden die gekozen zijn om overfitting te verminderen, hebben de nauwkeurigheid van het model niet verbeterd. Uw eerste model had een nauwkeurigheid van 96%, terwijl het model met de L2-regularisatie een nauwkeurigheid van 95% heeft. U kunt verschillende waarden uitproberen en kijken wat de impact daarvan is op de nauwkeurigheid.
