
Scikit-Learn-tutorial: installeren en Scikit-Learn-voorbeelden
 Redactie
⚡ Slimme samenvatting
Scikit-learn is de open-source Python Een bibliotheek die voorbewerking, classificatie, regressie, clustering en modelselectie combineert in één consistente schatterinterface. Dit zorgt ervoor dat een complete machine learning-workflow kort, leesbaar en reproduceerbaar blijft, van ruwe data tot gescoorde voorspellingen.
Wat is Scikit-leren?
Scikit leren is een open-source Python bibliotheek voor machine learningHet ondersteunt gevestigde algoritmen zoals KNN, gradient boosting, random forest en SVM, en het is gebouwd op basis van NumPy en SciPy. Scikit-learn wordt veel gebruikt in Kaggle-competities en bij vooraanstaande technologiebedrijven. Het omvat voorbewerking, dimensionaliteitsreductie, classificatie, regressie, clustering en modelselectie.
Scikit-learn heeft een van de beste documentaties van alle open-sourcebibliotheken. Het biedt zelfs een interactieve schattingsgrafiek. De juiste taxateur kiezenDat leidt je van de grootte van je dataset naar een shortlist van algoritmen die het proberen waard zijn.
Onderstaande afbeelding illustreert hoe Scikit-learn werkt.
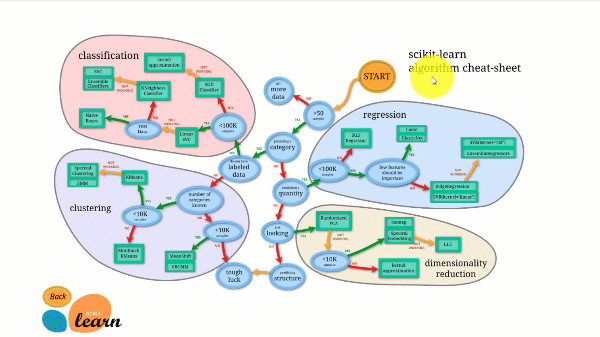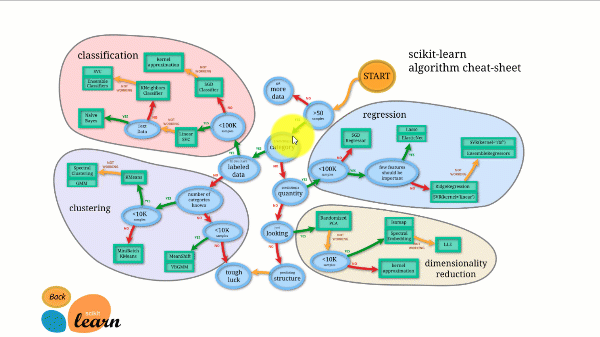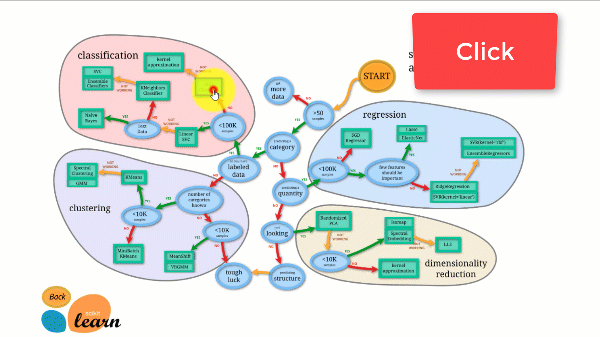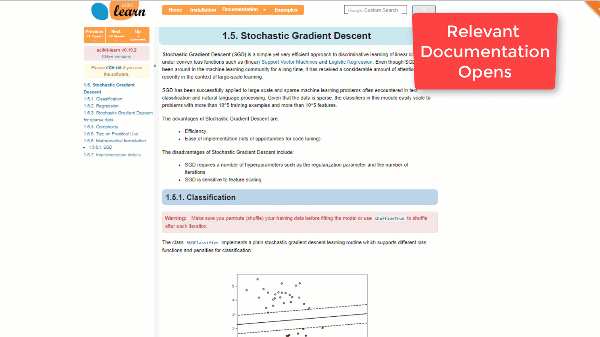
Scikit-learn is niet moeilijk te gebruiken en levert uitstekende resultaten. Het traint echter wel op de CPU: het werk wordt geparallelliseerd over de cores met het argument `n_jobs` in plaats van op een GPU. Het uitvoeren van een deep learning-algoritme ermee is mogelijk, maar zelden optimaal, vooral als je al weet hoe je het moet gebruiken. TensorFlow.
Scikit-learn downloaden en installeren
Nu in dit Python In deze Scikit-learn tutorial leer je hoe je Scikit-learn kunt downloaden en installeren:
Optie 1: AWS
Scikit-learn kan via AWS worden gebruikt. Een Docker-image met vooraf geïnstalleerde scikit-learn bespaart u alle installatiewerkzaamheden.
Om de ontwikkelaarsversie te installeren, voert u de onderstaande opdracht uit in de volgende map: Jupyter:
import sys
!{sys.executable} -m pip install git+git://github.com/scikit-learn/scikit-learn.git
Optie 2: Mac of Windows gebruik van anaconda
Voor meer informatie over de installatie van Anaconda kunt u terecht bij... Hoe download en installeer je TensorFlow?.
Toen deze handleiding werd geschreven, hadden de ontwikkelaars van scikit-learn een ontwikkelingsversie uitgebracht die problemen in de toenmalige release verhielp. De onderstaande stappen maken daarom gebruik van die ontwikkelingsversie. Op een nieuwe machine bevat de huidige stabiele release al alle transformatoren die hier worden gebruikt. pip install -U scikit-learn is genoeg.
Scikit-learn installeren met Conda Environment
Als je scikit-learn hebt geïnstalleerd met de conda-omgeving, volg dan de onderstaande stappen om bij te werken naar versie 0.20.
Stap 1) Activeer de TensorFlow-omgeving
source activate hello-tf
Stap 2) Verwijder scikit-learn met behulp van het conda-commando.
conda remove scikit-learn
Stap 3) Installeer de ontwikkelaarsversie
Installeer de ontwikkelaarsversie van scikit-learn samen met de benodigde bibliotheken.
conda install -c anaconda git
pip install Cython
pip install h5py
pip install git+git://github.com/scikit-learn/scikit-learn.git
NOTITIE: Windows gebruikers hebben nodig Microsoft Visual C++ 14. Je kunt het krijgen hier.
Scikit-Learn-voorbeeld met machine learning
Deze Scikit-tutorial is verdeeld in twee delen:
- Machine learning met scikit-learn
- Hoe u uw model kunt vertrouwen met LIME
Het eerste deel beschrijft hoe je een pipeline bouwt, een model creëert en de hyperparameters afstemt, terwijl het tweede deel ingaat op de interpretatie van het model.
Stap 1) Importeer de gegevens
Tijdens deze Scikit-learn-tutorial ga je de dataset van de volwassenentelling gebruiken.
Het bestand wordt in de onderstaande code rechtstreeks uit de UCI Machine Learning Repository gelezen, dus handmatig downloaden is niet nodig. Als u geïnteresseerd bent in de beschrijvende statistieken, zijn de tools Dive en Overview de moeite waard om te bekijken. Zie ook deze tutorial Om meer te weten te komen over Dive en Overview.
Je importeert de dataset met pandas. Houd er rekening mee dat je de continue variabelen moet converteren naar het float-formaat.
Deze dataset bevat acht categorische variabelen, die worden vermeld in CATE_FEATURES:
- werkklas
- onderwijs
- huwelijks-
- bezetting
- relatie
- race
- geslacht
- geboorteland
Het omvat ook zes continue variabelen, die worden vermeld in CONTI_FEATURES:
- leeftijd
- fnlwgt
- onderwijs_num
- kapitaal_winst
- kapitaal_verlies
- uren_week
De lijsten worden hier handmatig ingevuld, zodat u een duidelijker beeld krijgt van welke kolommen relevant zijn. Een snellere manier om een lijst met categorische of continue kolommen samen te stellen is:
## List Categorical
CATE_FEATURES = df_train.iloc[:,:-1].select_dtypes('object').columns
print(CATE_FEATURES)

## List continuous
CONTI_FEATURES =  df_train._get_numeric_data()
print(CONTI_FEATURES)
Hier is de code om de gegevens te importeren:
# Import dataset
import pandas as pd

## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country', 'label']
### Define continuous list
CONTI_FEATURES  = ['age', 'fnlwgt','capital_gain', 'education_num', 'capital_loss', 'hours_week']
### Define categorical list
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']

## Prepare the data
features = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country']

PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"

df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_train[CONTI_FEATURES] =df_train[CONTI_FEATURES].astype('float64')
df_train.describe()
Door describe() op het frame aan te roepen, worden de samenvattende statistieken voor de zes continue kolommen geretourneerd:
| leeftijd | fnlwgt | onderwijs_num | kapitaal_winst | kapitaal_verlies | uren_week | |
|---|---|---|---|---|---|---|
| tellen | 32561.000000 | 3.256100e + 04 | 32561.000000 | 32561.000000 | 32561.000000 | 32561.000000 |
| gemiddelde | 38.581647 | 1.897784e + 05 | 10.080679 | 1077.648844 | 87.303830 | 40.437456 |
| soa | 13.640433 | 1.055500e + 05 | 2.572720 | 7385.292085 | 402.960219 | 12.347429 |
| Min | 17.000000 | 1.228500e + 04 | 1.000000 | 0.000000 | 0.000000 | 1.000000 |
| 25% | 28.000000 | 1.178270e + 05 | 9.000000 | 0.000000 | 0.000000 | 40.000000 |
| 50% | 37.000000 | 1.783560e + 05 | 10.000000 | 0.000000 | 0.000000 | 40.000000 |
| 75% | 48.000000 | 2.370510e + 05 | 12.000000 | 0.000000 | 0.000000 | 45.000000 |
| max | 90.000000 | 1.484705e + 06 | 16.000000 | 99999.000000 | 4356.000000 | 99.000000 |
Je kunt het aantal unieke waarden van de eigenschap native_country controleren. Slechts één huishouden is afkomstig uit Nederland. Dat huishouden levert geen informatie op en zal een foutmelding geven tijdens de training.
df_train.native_country.value_counts()
United-States                 29170
Mexico                          643
?                               583
Philippines                     198
Germany                         137
Canada                          121
Puerto-Rico                     114
El-Salvador                     106
India                           100
Cuba                             95
England                          90
Jamaica                          81
South                            80
China                            75
Italy                            73
Dominican-Republic               70
Vietnam                          67
Guatemala                        64
Japan                            62
Poland                           60
Columbia                         59
Taiwan                           51
Haiti                            44
Iran                             43
Portugal                         37
Nicaragua                        34
Peru                             31
France                           29
Greece                           29
Ecuador                          28
Ireland                          24
Hong                             20
Cambodia                         19
Trinadad&Tobago                  19
Thailand                         18
Laos                             18
Yugoslavia                       16
Outlying-US(Guam-USVI-etc)       14
Honduras                         13
Hungary                          13
Scotland                         12
Holand-Netherlands                1
Name: native_country, dtype: int64
U kunt deze niet-informatieve rij uit de dataset verwijderen:
## Drop Netherland, because only one row
df_train = df_train[df_train.native_country != "Holand-Netherlands"]
Vervolgens slaat u de positie van de doorlopende objecten op in een lijst. U hebt deze nodig bij de volgende stap om de pijplijn te bouwen.
De onderstaande code doorloopt alle kolomnamen in CONTI_FEATURES, leest elke locatie (dat wil zeggen, het kolomnummer) en voegt deze toe aan een lijst genaamd conti_features.
## Get the column index of the categorical features
conti_features = []
for i in CONTI_FEATURES:
    position = df_train.columns.get_loc(i)
    conti_features.append(position)
print(conti_features)
[0, 2, 10, 4, 11, 12]
Het volgende blok doet hetzelfde voor de categorische variabelen.
## Get the column index of the categorical features
categorical_features = []
for i in CATE_FEATURES:
    position = df_train.columns.get_loc(i)
    categorical_features.append(position)
print(categorical_features)
[1, 3, 5, 6, 7, 8, 9, 13]
Laten we nu eens naar de dataset zelf kijken. Elk categorisch kenmerk is een tekenreeks, en een model kan geen tekenreeks als invoer krijgen. Daarom moet de dataset worden getransformeerd met behulp van dummyvariabelen.
df_train.head(5)
Je hebt namelijk één kolom nodig voor elke groep in elk kenmerk. Voer eerst de onderstaande code uit om het totale aantal benodigde kolommen te berekenen.
print(df_train[CATE_FEATURES].nunique(),
      'There are',sum(df_train[CATE_FEATURES].nunique()), 'groups in the whole dataset')
workclass          9
education         16
marital            7
occupation        15
relationship       6
race               5
sex                2
native_country    41
dtype: int64 There are 101 groups in the whole dataset
De volledige dataset bevat 101 groepen, zoals hierboven weergegeven. Alleen al de feature 'workclass' heeft negen groepen. Je kunt de namen van de groepen weergeven met de onderstaande code; de functie `unique()` retourneert de unieke waarden van elke categorische feature.
for i in CATE_FEATURES:
    print(df_train[i].unique())
['State-gov' 'Self-emp-not-inc' 'Private' 'Federal-gov' 'Local-gov' '?'
 'Self-emp-inc' 'Without-pay' 'Never-worked']
['Bachelors' 'HS-grad' '11th' 'Masters' '9th' 'Some-college' 'Assoc-acdm'
 'Assoc-voc' '7th-8th' 'Doctorate' 'Prof-school' '5th-6th' '10th'
 '1st-4th' 'Preschool' '12th']
['Never-married' 'Married-civ-spouse' 'Divorced' 'Married-spouse-absent'
 'Separated' 'Married-AF-spouse' 'Widowed']
['Adm-clerical' 'Exec-managerial' 'Handlers-cleaners' 'Prof-specialty'
 'Other-service' 'Sales' 'Craft-repair' 'Transport-moving'
 'Farming-fishing' 'Machine-op-inspct' 'Tech-support' '?'
 'Protective-serv' 'Armed-Forces' 'Priv-house-serv']
['Not-in-family' 'Husband' 'Wife' 'Own-child' 'Unmarried' 'Other-relative']
['White' 'Black' 'Asian-Pac-Islander' 'Amer-Indian-Eskimo' 'Other']
['Male' 'Female']
['United-States' 'Cuba' 'Jamaica' 'India' '?' 'Mexico' 'South'
 'Puerto-Rico' 'Honduras' 'England' 'Canada' 'Germany' 'Iran'
 'Philippines' 'Italy' 'Poland' 'Columbia' 'Cambodia' 'Thailand' 'Ecuador'
 'Laos' 'Taiwan' 'Haiti' 'Portugal' 'Dominican-Republic' 'El-Salvador'
 'France' 'Guatemala' 'China' 'Japan' 'Yugoslavia' 'Peru'
 'Outlying-US(Guam-USVI-etc)' 'Scotland' 'Trinadad&Tobago' 'Greece'
 'Nicaragua' 'Vietnam' 'Hong' 'Ireland' 'Hungary']
De trainingsdataset zal daarom 101 + 6 kolommen bevatten: de one-hot-groepen plus de zes continue kenmerken.
Scikit-learn kan de conversie in twee stappen voor u uitvoeren:
- Converteer de tekenreeks naar een ID. State-gov wordt ID 1, Self-emp-not-inc wordt ID 2, enzovoort. LabelEncoder doet dit automatisch voor u.
- Zet elke ID om naar een nieuwe kolom. De dataset bevat 101 groeps-ID's, dus er zullen 101 kolommen zijn die elke categorische kenmerkgroep vastleggen. Scikit-learn biedt OneHotEncoder voor deze bewerking.
Stap 2) Maak de trein-/testset aan
Nu de dataset klaar is, verdeel je deze in een verhouding van 80/20: 80 procent voor de trainingsset en 20 procent voor de testset.
Je kunt train_test_split gebruiken. Het eerste argument is de dataframe met kenmerken en het tweede is het label. Je stelt de grootte van de testset in met test_size.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(df_train[features],
                                                    df_train.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train.head(5)
print(X_train.shape, X_test.shape)
(26048, 14) (6512, 14)
Stap 3) Bouw de pijpleiding
De pipeline maakt het eenvoudiger om het model te voeden met consistente data. Het idee is om de ruwe data door één object te leiden dat alle bewerkingen in de juiste volgorde uitvoert.
Met deze dataset moet je de continue variabelen standaardiseren en de categorische variabelen converteren. Elke bewerking kan binnen een pipeline plaatsvinden: ontbrekende waarden kunnen worden vervangen door het gemiddelde of de mediaan, en er kunnen nieuwe variabelen worden aangemaakt.
Je hebt twee opties: de twee processen hardcoderen of een pipeline bouwen. Hardcoderen kan testdata in de berekende statistieken laten lekken en na verloop van tijd inconsistenties veroorzaken, dus een pipeline is de betere optie.
from sklearn.preprocessing import StandardScaler, OneHotEncoder, LabelEncoder
from sklearn.compose import ColumnTransformer, make_column_transformer
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LogisticRegression
De pipeline voert twee bewerkingen uit voordat de gegevens aan de logistieke classifier worden aangeleverd:
- Standaardiseer de variabele: StandardScaler()
- Converteer de categorische kenmerken: OneHotEncoder(sparse=False)
Je voert beide stappen uit met make_column_transformer. Toen deze handleiding werd geschreven, was de functie nog niet opgenomen in de uitgebrachte versie van scikit-learn (0.19), daarom werd de ontwikkelaarsversie gebruikt; deze is sinds versie 0.20 in elke stabiele release opgenomen.
make_column_transformer is eenvoudig: je geeft aan welke kolommen je wilt transformeren en welke transformatie je wilt toepassen. Om de continue kenmerken te standaardiseren, geef je het volgende door:
- conti_features, StandardScaler() binnen make_column_transformer
- conti_features: de lijst met continue kolommen
- StandardScaler: standaardiseert die kolommen
Het OneHotEncoder-object in make_column_transformer codeert de labels automatisch.
preprocess = make_column_transformer(
    (conti_features, StandardScaler()),
    ### Need to be numeric not string to specify columns name
    (categorical_features, OneHotEncoder(sparse=False))
)
Versie-opmerking: Twee argumenten in het bovenstaande blok zijn gewijzigd. De huidige versies verwachten eerst de transformator en daarna de kolommen, en dun werd hernoemd sparse_output was aanwezig in scikit-learn 1.2 en verwijderd in 1.4, dus de nieuwere code leest als volgt: OneHotEncoder(sparse_output=False).
Je kunt testen of de pipeline werkt met fit_transform. De uitvoer moet de vorm 26048, 107 hebben.
preprocess.fit_transform(X_train).shape
(26048, 107)
De datatransformator is klaar. Je maakt de pipeline aan met make_pipeline, en zodra de data is getransformeerd, voer je deze in de logistische regressie.
model = make_pipeline(
    preprocess,
    LogisticRegression())
Het trainen van een model met scikit-learn is dan heel eenvoudig: roep de `fit`-methode aan in de pipeline. Je kunt de nauwkeurigheid afdrukken met de `score`-methode.
model.fit(X_train, y_train)
print("logistic regression score: %f" % model.score(X_test, y_test))
logistic regression score: 0.850891
Ten slotte kun je de klassen voorspellen met predict_proba, die de waarschijnlijkheid van elke klasse retourneert. Merk op dat de twee waarschijnlijkheden bij elkaar opgeteld één zijn.
model.predict_proba(X_test)
array([[0.83576663, 0.16423337],
       [0.94582765, 0.05417235],
       [0.64760587, 0.35239413],
       ...,
       [0.99639252, 0.00360748],
       [0.02072181, 0.97927819],
       [0.56781353, 0.43218647]])
Stap 4) Onze pijplijn gebruiken bij een rasterzoekopdracht
Het afstellen van de hyperparameters, de waarden die de structuur van het model bepalen, kan een moeizaam en uitputtend proces zijn.
Een manier om het model te evalueren zou zijn om de grootte van de trainingsset te veranderen en de prestaties te meten, waarbij de oefening tien keer wordt herhaald om de spreiding van de scores te zien. Dat is veel handmatig werk.
Scikit-learn biedt daarentegen functies die parameteroptimalisatie en kruisvalidatie voor je uitvoeren.
Kruisvalidatie
Kruisvalidatie houdt in dat tijdens de training de trainingsset n keer wordt opgesplitst in vouwen (folds) en het model n keer wordt geëvalueerd. Als cv is ingesteld op 10, wordt het model tien keer getraind en geëvalueerd. In elke ronde traint de classifier op negen willekeurig gekozen vouwen en wordt de tiende vouw gebruikt voor evaluatie.
Raster zoeken
Elke classificator heeft hyperparameters die afgesteld moeten worden. Je kunt waarden één voor één uitproberen, of een parametergrid instellen. De scikit-learn-documentatie geeft een overzicht van alle parameters die de logistische classificator accepteert. Om de training snel te houden, wordt in dit voorbeeld alleen de parameter C afgesteld, die de regularisatie regelt. Deze moet positief zijn, en een kleine waarde geeft meer gewicht aan de regularisator.
Je gebruikt het GridSearchCV-object, dat een woordenboek met de te optimaliseren hyperparameters als argument accepteert. Geef elke hyperparameter op, gevolgd door de waarden die je wilt uitproberen. Om C te optimaliseren, schrijf je:
- 'logisticregression__C': [0.001, 0.01, 0.1, 1.0] — de parameternaam wordt voorafgegaan door de naam van de classifier in kleine letters en twee underscores.
Het model zal vier verschillende waarden proberen: 0.001, 0.01, 0.1 en 1. Het wordt getraind met 10 vouwen, oftewel cv=10.
from sklearn.model_selection import GridSearchCV
# Construct the parameter grid
param_grid = {
    'logisticregression__C': [0.001, 0.01,0.1, 1.0],
    }
Je kunt het model nu trainen met GridSearchCV met de parameters grid en cv.
# Train the model
grid_clf = GridSearchCV(model,
                        param_grid,
                        cv=10,
                        iid=False)
grid_clf.fit(X_train, y_train)
Output:
GridSearchCV(cv=10, error_score='raise-deprecating',
       estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...ty='l2', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False))]),
       fit_params=None, iid=False, n_jobs=1,
       param_grid={'logisticregression__C': [0.001, 0.01, 0.1, 1.0]},
       pre_dispatch='2*n_jobs', refit=True, return_train_score='warn',
       scoring=None, verbose=0)
Versie-opmerking: the iid Het argument dat in deze uitvoer zichtbaar is, is afgekeurd in scikit-learn 0.22 en verwijderd in 0.24. Het zou daarom in de huidige versies gewoonweg uit de GridSearchCV-aanroep moeten worden verwijderd.
Om de beste parameters te vinden, gebruik je best_params_.
grid_clf.best_params_
Output:
{'logisticregression__C': 1.0}
Na het trainen van het model met vier verschillende regularisatiewaarden, levert de optimale parameter het volgende op:
print("best logistic regression from grid search: %f" % grid_clf.best_estimator_.score(X_test, y_test))
beste logistische regressie uit rasterzoekopdracht: 0.850891
Om toegang te krijgen tot de voorspelde kansen:
grid_clf.best_estimator_.predict_proba(X_test)
array([[0.83576677, 0.16423323],
       [0.9458291 , 0.0541709 ],
       [0.64760416, 0.35239584],
       ...,
       [0.99639224, 0.00360776],
       [0.02072033, 0.97927967],
       [0.56782222, 0.43217778]])
XGBoost-model met scikit-learn
Probeer nu eens een van de krachtigste classificatiemodellen op de markt. XGBoost is een gradient-boosting verbetering op het random forest-model. De theoretische achtergrond ervan valt buiten het bestek van dit artikel. Python Bekijk de Scikit-tutorial, maar houd er rekening mee dat XGBoost al heel wat Kaggle-competities heeft gewonnen. Op een dataset van gemiddelde grootte kan het net zo goed, of zelfs beter, presteren als een deep learning-algoritme.
Het trainen van de classifier is een uitdaging omdat deze een groot aantal parameters bevat. Je kunt natuurlijk GridSearchCV gebruiken om deze parameters voor je te selecteren.
Een betere optie is RandomizedSearchCV. GridSearchCV wordt traag bij grote rasters, omdat de zoekruimte groeit met elke toegevoegde parameter. RandomizedSearchCV daarentegen bemonstert de waarden van elke hyperparameter willekeurig bij elke iteratie, waardoor 1,000 iteraties 1,000 combinaties evalueren. Voor de rest werkt het grotendeels hetzelfde als GridSearchCV.
Je moet xgboost importeren. Als de bibliotheek niet is geïnstalleerd, voer dan `pip3 install xgboost` uit, of installeer deze vanuit een `pip`-bestand. Jupyter notitieboek met:
use import sys
!{sys.executable} -m pip install xgboost
Importeer vervolgens de classifier en de twee zoekhulpmiddelen:
import xgboost
from sklearn.model_selection import RandomizedSearchCV
from sklearn.model_selection import StratifiedKFold
De volgende stap in deze Scikit Python Het doel van deze handleiding is om de parameters te specificeren die moeten worden afgestemd. De officiële XGBoost-documentatie bevat een lijst van al deze parameters. Voor dit doel Python In de Sklearn-tutorial kies je slechts twee hyperparameters met elk twee waarden, omdat XGBoost lang duurt om te trainen en elk extra rasterpunt de wachttijd verlengt.
params = {
        'xgbclassifier__gamma': [0.5, 1],
        'xgbclassifier__max_depth': [3, 4]
        }
Vervolgens bouw je een nieuwe pipeline met de XGBoost-classificator en 600 estimators. n_estimators is zelf instelbaar, en een hoge waarde kan leiden tot overfitting. Je kunt andere waarden proberen, maar houd er rekening mee dat dit uren kan duren. Alle andere parameters behouden hun standaardwaarde.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1)
)
Je kunt de kruisvalidatie verbeteren met de Stratified K-Folds kruisvalidator. Hier worden slechts drie vouwen gebruikt om de berekening te versnellen, ten koste van de kwaliteit; verhoog dit naar 5 of 10 op je eigen computer voor betere resultaten. Het model wordt getraind over vier iteraties.
skf = StratifiedKFold(n_splits=3,
                      shuffle = True,
                      random_state = 1001)

random_search = RandomizedSearchCV(model_xgb,
                                   param_distributions=params,
                                   n_iter=4,
                                   scoring='accuracy',
                                   n_jobs=4,
                                   cv=skf.split(X_train, y_train),
                                   verbose=3,
                                   random_state=1001)
De gerandomiseerde zoekopdracht is klaar, dus je kunt het model trainen.
#grid_xgb = GridSearchCV(model_xgb, params, cv=10, iid=False)
random_search.fit(X_train, y_train)
Fitting 3 folds for each of 4 candidates, totalling 12 fits
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8759645283888057, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8729701715996775, total= 1.0min
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8706519235199263, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8735460094437406, total= 1.3min
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8722791661868018, total=  57.7s
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8753886905447426, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8697304768486523, total= 1.3min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8740066797189912, total= 1.4min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8707671043538355, total= 1.0min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8729701715996775, total= 1.2min
[Parallel(n_jobs=4)]: Done  10 out of  12 | elapsed:  3.6min remaining:   43.5s
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8736611770125533, total= 1.2min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8692697535130154, total= 1.2min
[Parallel(n_jobs=4)]: Done  12 out of  12 | elapsed:  3.6min finished
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/model_selection/_search.py:737: DeprecationWarning: The default of the `iid` parameter will change from True to False in version 0.22 and will be removed in 0.24. This will change numeric results when test-set sizes are unequal. DeprecationWarning)
RandomizedSearchCV(cv=<generator object _BaseKFold.split at 0x1101eb830>,
          error_score='raise-deprecating',
          estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))]),
          fit_params=None, iid='warn', n_iter=4, n_jobs=4,
          param_distributions={'xgbclassifier__gamma': [0.5, 1], 'xgbclassifier__max_depth': [3, 4]},
          pre_dispatch='2*n_jobs', random_state=1001, refit=True,
          return_train_score='warn', scoring='accuracy', verbose=3)
Zoals u kunt zien, scoort XGBoost beter dan de eerdere logistische regressie.
print("Best parameter", random_search.best_params_)
print("best logistic regression from grid search: %f" % random_search.best_estimator_.score(X_test, y_test))
Best parameter {'xgbclassifier__max_depth': 3, 'xgbclassifier__gamma': 0.5}
best logistic regression from grid search: 0.873157
random_search.best_estimator_.predict(X_test)
array(['<=50K', '<=50K', '<=50K', ..., '<=50K', '>50K', '<=50K'], dtype=object)
Maak DNN met MLPClassifier in scikit-learn
Tot slot kun je een neuraal netwerk trainen met scikit-learn zelf. De methode is hetzelfde als voor elke andere classifier, en de estimator is MLPClassifier.
from sklearn.neural_network import MLPClassifier
Het onderstaande netwerk is als volgt gedefinieerd:
- Adam-oplosser
- ReLU activeringsfunctie
- Alfa = 0.0001
- Batchgrootte van 150
- Twee verborgen lagen met respectievelijk 200 en 100 neuronen
model_dnn = make_pipeline(
    preprocess,
    MLPClassifier(solver='adam',
                  alpha=0.0001,
                  activation='relu',
                    batch_size=150,
                    hidden_layer_sizes=(200, 100),
                    random_state=1))
Je kunt het aantal lagen aanpassen om het model te verbeteren.
model_dnn.fit(X_train, y_train)
  print("DNN regression score: %f" % model_dnn.score(X_test, y_test))
DNN-regressiescore: 0.821253
LIME: Vertrouw op je model
Nu je een goed model hebt, moet je het kunnen vertrouwen. Machine learning-algoritmen, met name random forests en neurale netwerken, staan bekend als black-box-modellen: ze werken, maar niemand kan zien waarom.
Drie onderzoekers hebben een tool ontwikkeld die laat zien hoe een computer tot een voorspelling komt. Hun artikel is... “Waarom zou ik je vertrouwen?”en het algoritme dat ze publiceerden heet Local Interpretable Model-Agnostic Explanations (LIME).
Neem bijvoorbeeld het volgende. Soms weet je niet of een voorspelling van een machine learning-model te vertrouwen is. Een arts kan een diagnose niet zomaar accepteren omdat die door een computer is gesteld, en je moet weten of een model betrouwbaar is voordat je het in gebruik neemt.
Stel je voor dat je kunt zien waarom een classificator een voorspelling heeft gedaan, zelfs voor complexe modellen zoals neurale netwerken, random forests of SVM's met een willekeurige kernel. Het wordt veel gemakkelijker om een voorspelling te vertrouwen wanneer de redenen erachter zichtbaar zijn, en even gemakkelijk om te bepalen wanneer een model niet te vertrouwen is. LIME laat je zien welke kenmerken de beslissing van de classificator hebben beïnvloed.
Data voorbereiding
Je moet een paar dingen aanpassen om LIME te kunnen gebruiken. PythonInstalleer eerst kalk in de terminal met behulp van een kalkaanvoerbuis.
Lime gebruikt een LimeTabularExplainer-object om het model lokaal te benaderen. Dit object vereist het volgende:
- een dataset in NumPy formaat
- De naam van de features: feature_names
- De naam van de klassen: class_names
- De index van de kolom met categorische kenmerken: categorical_features
- De naam van de groep voor elk categorisch kenmerk: categorical_names
Maak de NumPy-trainingsset aan.
Je kunt de `df_train` dataset van pandas heel gemakkelijk kopiëren en converteren naar NumPy.
df_train.head(5)
# Create numpy data
df_lime = df_train
df_lime.head(3)
Haal de klassenaam op
Het label is toegankelijk via unique(). Je zou het volgende moeten zien:
- '<= 50K'
- '> 50K'
# Get the class name
class_names = df_lime.label.unique()
class_names
array(['<=50K', '>50K'], dtype=object)
Indexeer de kolommen met categorische kenmerken
Gebruik de eerder geleerde methode om de naam van elke groep te verkrijgen. Codeer het label met LabelEncoder en herhaal de bewerking voor elk categorisch kenmerk.
##
import sklearn.preprocessing as preprocessing
categorical_names = {}
for feature in CATE_FEATURES:
    le = preprocessing.LabelEncoder()
    le.fit(df_lime[feature])
    df_lime[feature] = le.transform(df_lime[feature])
    categorical_names[feature] = le.classes_
print(categorical_names)
{'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}

df_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
label              object
dtype: object
Nu de dataset gereed is, kunt u de verschillende datasets bouwen die in de onderstaande Scikit-learn-voorbeelden worden getoond. De data wordt hier buiten de pipeline getransformeerd om fouten met LIME te voorkomen: de trainingsset die aan LimeTabularExplainer wordt doorgegeven, moet een NumPy-array zonder strings zijn, en de bovenstaande methode heeft er al een geproduceerd.
from sklearn.model_selection import train_test_split
X_train_lime, X_test_lime, y_train_lime, y_test_lime = train_test_split(df_lime[features],
                                                    df_lime.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train_lime.head(5)
Je kunt de pipeline maken met de optimale parameters die XGBoost heeft gevonden.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(max_depth = 3,
                          gamma = 0.5,
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1))

model_xgb.fit(X_train_lime, y_train_lime)
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/preprocessing/_encoders.py:351: FutureWarning: The handling of integer data will change in version 0.22. Currently, the categories are determined based on the range [0, max(values)], while in the future they will be determined based on the unique values.
If you want the future behavior and silence this warning, you can specify "categories='auto'."In case you used a LabelEncoder before this OneHotEncoder to convert the categories to integers, then you can now use the OneHotEncoder directly.
  warnings.warn(msg, FutureWarning)
Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))])
Je krijgt een waarschuwing. Daarin wordt uitgelegd dat je geen label-encoder hoeft te maken vóór de pipeline. Als je geen LIME gebruikt, is de methode uit het eerste deel van deze tutorial over machine learning met Scikit-learn prima. Anders kun je deze aanpak aanhouden: maak eerst een gecodeerde dataset aan en pas vervolgens de one-hot-encoder toe in de pipeline.
print("best logistic regression from grid search: %f" % model_xgb.score(X_test_lime, y_test_lime))
best logistic regression from grid search: 0.873157
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
Voordat je LIME aan de slag laat gaan, maak je een NumPy-array aan met de kenmerken van de rijen die verkeerd geclassificeerd zijn. Je kunt die lijst later gebruiken om te achterhalen waardoor de classifier op het verkeerde spoor is geraakt.
temp = pd.concat([X_test_lime, y_test_lime], axis= 1)
temp['predicted'] = model_xgb.predict(X_test_lime)
temp['wrong']=  temp['label'] != temp['predicted']
temp = temp.query('wrong==True').drop('wrong', axis=1)
temp= temp.sort_values(by=['label'])
temp.shape
(826, 16)
Vervolgens maak je een lambda-functie aan die de voorspelling van het model voor nieuwe gegevens ophaalt. Die heb je straks nodig.
predict_fn = lambda x: model_xgb.predict_proba(x).astype(float)
X_test_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
dtype: object
predict_fn(X_test_lime)
array([[7.96461046e-01, 2.03538969e-01],
       [9.51730132e-01, 4.82698716e-02],
       [7.93448269e-01, 2.06551731e-01],
       ...,
       [9.90314305e-01, 9.68566816e-03],
       [6.45816326e-04, 9.99354184e-01],
       [9.71042812e-01, 2.89571714e-02]])
Je converteert het pandas-dataframe naar een NumPy-array.
X_train_lime = X_train_lime.values
X_test_lime = X_test_lime.values
X_test_lime
array([[4.00000e+01, 5.00000e+00, 1.93524e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.70000e+01, 4.00000e+00, 2.16481e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.50000e+01, 4.00000e+00, 2.56263e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       ...,
       [2.80000e+01, 6.00000e+00, 2.11032e+05, ..., 0.00000e+00,
        4.00000e+01, 2.50000e+01],
       [4.40000e+01, 4.00000e+00, 1.67005e+05, ..., 0.00000e+00,
        6.00000e+01, 3.80000e+01],
       [5.30000e+01, 4.00000e+00, 2.57940e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01]])
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
print(features,
      class_names,
      categorical_features,
      categorical_names)
['age', 'workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country'] ['<=50K' '>50K'] [1, 3, 5, 6, 7, 8, 9, 13] {'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}
import lime
import lime.lime_tabular
### Train should be label encoded not one hot encoded
explainer = lime.lime_tabular.LimeTabularExplainer(X_train_lime ,
                                                   feature_names = features,
                                                   class_names=class_names,
                                                   categorical_features=categorical_features,
                                                   categorical_names=categorical_names,
                                                   kernel_width=3)
Kies nu een willekeurig huishouden uit de testset en bekijk zowel de voorspelling als de manier waarop de computer tot die voorspelling is gekomen.
import numpy as np
np.random.seed(1)
i = 100
print(y_test_lime.iloc[i])
>50K
X_test_lime[i]
array([4.20000e+01, 4.00000e+00, 1.76286e+05, 7.00000e+00, 1.20000e+01,
       2.00000e+00, 4.00000e+00, 0.00000e+00, 4.00000e+00, 1.00000e+00,
       0.00000e+00, 0.00000e+00, 4.00000e+01, 3.80000e+01])
Je kunt de explainer met explain_instance gebruiken om de redenering achter het model te inspecteren. De grafiek die wordt gegenereerd, zie je hieronder.
exp = explainer.explain_instance(X_test_lime[i], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

De classificatiesoftware voorspelde dit huishouden correct: het inkomen ligt inderdaad boven de 50.
Het eerste wat opvalt, is dat de classificator niet erg zeker van zichzelf is. Hij voorspelt een inkomen van meer dan 50 euro met een waarschijnlijkheid van 64%, en die 64% wordt bepaald door vermogenswinst en burgerlijke staat. De blauwe kleur draagt negatief bij aan de positieve klasse en de oranje lijn positief.
De classificator aarzelt omdat de vermogenswinst van dit huishouden nul is, terwijl vermogenswinst doorgaans een goede voorspeller van vermogen is. Het huishouden werkt bovendien minder dan 40 uur per week. Leeftijd, beroep en geslacht dragen allemaal positief bij.
Als de burgerlijke staat 'ongehuwd' was, zou de classificator een inkomen onder de 50 euro hebben voorspeld (0.64 – 0.18 = 0.46).
Probeer nu een ander huishouden, een dat verkeerd is geclassificeerd. De verklarende tabel hiervoor volgt na de code.
temp.head(3)
temp.iloc[1,:-2]
age                  58
workclass             4
fnlwgt            68624
education            11
education_num         9
marital               2
occupation            4
relationship          0
race                  4
sex                   1
capital_gain          0
capital_loss          0
hours_week           45
native_country       38
Name: 20931, dtype: object
i = 1
print('This observation is', temp.iloc[i,-2:])
This observation is label        <=50K
predicted     >50K
Name: 20931, dtype: object
exp = explainer.explain_instance(temp.iloc[1,:-2], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

De classificator voorspelde een inkomen onder de 50 euro, wat onjuist is. Dit huishouden is ongebruikelijk: er is geen sprake van vermogenswinst of -verlies, de persoon is gescheiden, bijna 60 jaar oud en hoogopgeleid (opleidingsniveau > 12). Volgens het algemene patroon plaatste de classificator het huishouden onder de 50 euro.
Speel zelf met LIME en je zult talloze grove fouten van de classifier tegenkomen. De GitHub-repository van de auteur van de bibliotheek bevat aanvullende documentatie voor beeld- en tekstclassificatie.
Scikit-learn Command Reference
Hieronder vindt u een lijst met nuttige commando's die van toepassing zijn op scikit-learn versie 0.20 en later.
| Taak | Functie of klasse |
|---|---|
| Maak de trainings-/testdataset aan. | train_test_split |
| Bouw een pijplijn | |
| Selecteer de kolommen en pas de transformatie toe. | maak_kolom_transformer |
| Soort transformatie | |
| Standaardiseren | Standaardscaler |
| Min-max schaling | MinMaxScaler |
| Normaliseren | Normalizer |
| Ontbrekende waarden invullen | SimpleImputer |
| Converteer categorisch | OneHotEncoder |
| Pas de gegevens aan en transformeer ze | fit_transform |
| Maak de pijpleiding | make_pipeline |
| Basismodel | |
| Logistische regressie | Logistische regressie |
| XGBoost | XGBClassifier |
| neuraal net | MLP-classificatie |
| Raster zoeken | RasterZoekenCV |
| Gerandomiseerde zoekopdracht | GerandomiseerdZoekenCV |
