
Data Mart ใน Data Warehouse คืออะไร? ประเภทและตัวอย่าง
 ทีมบรรณาธิการ
⚡ สรุปอย่างชาญฉลาด
การออกแบบ Data Mart มุ่งเน้นการส่งมอบชุดข้อมูลย่อยที่สำคัญจากคลังข้อมูลไปยังแผนกใดแผนกหนึ่ง โดยครอบคลุม Data Mart ทั้งสามประเภท ขั้นตอนทั้งห้าตั้งแต่การออกแบบไปจนถึงการจัดการ และแนวปฏิบัติที่ดีที่สุดที่ช่วยให้การส่งมอบรวดเร็ว ปลอดภัย และคุ้มค่า
ดาต้ามาทนำมาซึ่งพลังการวิเคราะห์ของ คลังข้อมูล สำหรับทีมเดียว การมุ่งเน้นไปที่หัวข้อเดียวช่วยให้แผนกสามารถวิเคราะห์ข้อมูลของตนเองได้อย่างรวดเร็วโดยไม่ต้องรอการประมวลผลจากทั่วทั้งองค์กร หัวข้อด้านล่างนี้จะอธิบายว่าดาต้ามาทคืออะไร เหตุใดองค์กรจึงใช้ดาต้ามาท ประเภททั้งสามที่มีอยู่ และวิธีการนำไปใช้และจัดการ
Data Mart คืออะไร?
ดาต้ามาท (Data Mart) มุ่งเน้นไปที่ส่วนงานเฉพาะด้านใดด้านหนึ่งขององค์กร และประกอบด้วยชุดข้อมูลย่อยจากข้อมูลที่จัดเก็บไว้ในฐานข้อมูลหลัก คลังข้อมูลเป็นเวอร์ชันย่อของคลังข้อมูลขนาดใหญ่ ออกแบบมาเพื่อใช้งานโดยแผนก หน่วยงาน หรือกลุ่มผู้ใช้เฉพาะ เช่น ฝ่ายการตลาด ฝ่ายขาย ฝ่ายทรัพยากรบุคคล หรือฝ่ายการเงิน
เนื่องจากดาต้ามาทมีหน้าที่เพียงอย่างเดียว จึงมักถูกควบคุมโดยแผนกเดียวภายในองค์กร การมุ่งเน้นเช่นนี้ทำให้ขอบเขตการทำงานแคบลงและผู้รับผิดชอบมีความชัดเจน
นอกจากนี้ ดาต้ามาทจะดึงข้อมูลจากแหล่งข้อมูลเพียงไม่กี่แหล่ง ต่างจากดาต้าแวร์เฮาส์ที่ผสานรวมแหล่งข้อมูลจำนวนมาก ส่งผลให้ดาต้ามาทมีขนาดเล็กและมีความยืดหยุ่นมากกว่าดาต้าแวร์เฮาส์อย่างเต็มรูปแบบ
ทำไมเราต้องมี Data Mart?
องค์กรต่างๆ พึ่งพาคลังข้อมูลขนาดใหญ่ (data marts) ด้วยเหตุผลเชิงปฏิบัติหลายประการ:
- ดาต้ามาทช่วยปรับปรุงเวลาตอบสนองของผู้ใช้โดยการลดปริมาณข้อมูลที่พวกเขาสอบถาม
- ช่วยให้เข้าถึงข้อมูลที่ร้องขอบ่อยได้อย่างง่ายดาย
- การสร้าง Data Mart นั้นง่ายกว่าและมีต้นทุนต่ำกว่าการสร้าง Data Warehouse ขององค์กร
- มันมีความคล่องตัว: เมื่อโมเดลเปลี่ยนแปลง สามารถสร้างคลังข้อมูลขนาดเล็กขึ้นใหม่ได้อย่างรวดเร็ว
- Data mart ถูกกำหนดโดยผู้เชี่ยวชาญเฉพาะด้านเพียงคนเดียว ในขณะที่ Data warehouse ถูกกำหนดโดยทีมสหวิชาชีพ ดังนั้น Data mart จึงเปิดกว้างต่อการเปลี่ยนแปลงมากกว่า
- ข้อมูลถูกแบ่งออกเป็นส่วนๆ ทำให้สามารถกำหนดสิทธิ์การเข้าถึงได้อย่างละเอียดมากยิ่งขึ้น
- ข้อมูลสามารถแบ่งส่วนและจัดเก็บไว้บนแพลตฟอร์มฮาร์ดแวร์หรือซอฟต์แวร์ที่แตกต่างกันได้
กล่าวโดยสรุป เนื่องจากดาต้ามาทจัดการข้อมูลส่วนเล็ก ๆ ที่กำหนดไว้อย่างชัดเจน จึงสร้างได้รวดเร็วกว่า ดำเนินการได้ถูกกว่า และรักษาความปลอดภัยได้ง่ายกว่าคลังข้อมูลระดับองค์กร
อย่างไรก็ตาม ดาต้ามาร์ทไม่ได้ถูกสร้างขึ้นด้วยวิธีเดียวกันทั้งหมด แหล่งข้อมูลที่ดาต้ามาร์ทดึงข้อมูลมานั้นจะเป็นตัวกำหนดว่าคุณกำลังใช้งานดาต้ามาร์ทประเภทใดจากสามประเภทที่มีอยู่
ประเภทของดาต้ามาร์ท
ดาต้ามาร์ทแบ่งออกเป็น 3 ประเภทหลัก โดยพิจารณาจากแหล่งที่มาของข้อมูล:
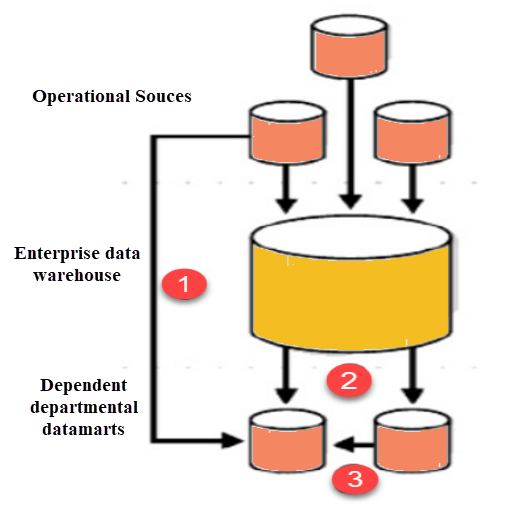
- ขึ้นอยู่กับ: ดาต้ามาทแบบพึ่งพาจะดึงข้อมูลโดยตรงจากแหล่งข้อมูลการดำเนินงาน แหล่งข้อมูลภายนอก หรือทั้งสองอย่าง
- อิสระ: มีการสร้างคลังข้อมูลอิสระขึ้นโดยไม่ต้องมีคลังข้อมูลส่วนกลาง
- ไฮบริด: ดาต้ามาทแบบไฮบริดสามารถดึงข้อมูลจากคลังข้อมูลหรือระบบปฏิบัติการได้
ขึ้นอยู่กับ Data Mart
ดาต้ามาทแบบพึ่งพา (Dependent Data Mart) ดึงข้อมูลขององค์กรมาจากดาต้าแวร์เฮาส์ (Data Warehouse) เดียว ซึ่งมีข้อดีคือการกระจายข้อมูลไปที่ส่วนเดียว หากคุณต้องการสร้างดาต้ามาททางกายภาพหนึ่งแห่งหรือมากกว่านั้น คุณจะต้องกำหนดค่าดาต้ามาทเหล่านั้นให้เป็นดาต้ามาทแบบพึ่งพา
การสร้างดาต้ามาทแบบพึ่งพา (Dependent Data Mart) สามารถทำได้สองวิธี: วิธีแรกคือผู้ใช้เข้าถึงทั้งดาต้ามาทและดาต้าแวร์เฮาส์ตามความต้องการ และวิธีที่สองคือจำกัดการเข้าถึงเฉพาะดาต้ามาทเท่านั้น วิธีที่สองนี้ไม่เหมาะสมนัก เพราะอาจทำให้เกิด "กองขยะข้อมูล" — ข้อมูลที่เริ่มต้นจากแหล่งข้อมูลเดียวกัน แต่ถูกทิ้งและแทบไม่ได้ใช้งานเลย

อิสระข้อมูลมาร์ท
มีการสร้างดาต้ามาร์ทอิสระขึ้นโดยไม่ต้องมีคลังข้อมูลส่วนกลาง ดาต้ามาร์ทประเภทนี้เหมาะสำหรับกลุ่มงานขนาดเล็กภายในองค์กร
ดาต้ามาร์ทอิสระไม่มีความสัมพันธ์กับดาต้าแวร์เฮาส์ขององค์กรหรือดาต้ามาร์ทอื่นๆ ข้อมูลของมันจะถูกโหลดและวิเคราะห์โดยตัวมันเอง วิธีการนี้ขัดแย้งกับเหตุผลหลักในการสร้างดาต้าแวร์เฮาส์ตั้งแต่แรก นั่นคือ การจัดเก็บข้อมูลขององค์กรอย่างสม่ำเสมอและเป็นศูนย์กลาง ซึ่งผู้ใช้จำนวนมากที่มีความสนใจแตกต่างกันสามารถวิเคราะห์ได้

ไฮบริดดาต้ามาร์ท
ดาต้ามาทแบบไฮบริดเป็นการผสานรวมข้อมูลจากแหล่งข้อมูลภายนอกคลังข้อมูลหลัก ซึ่งเป็นประโยชน์เมื่อคุณต้องการการผสานรวมแบบเฉพาะกิจ เช่น หลังจากมีการเพิ่มกลุ่มหรือผลิตภัณฑ์ใหม่เข้ามาในองค์กร
โครงสร้างข้อมูลแบบไฮบริดเหมาะอย่างยิ่งสำหรับสภาพแวดล้อมที่มีฐานข้อมูลหลายแห่ง และช่วยให้การใช้งานรวดเร็วขึ้นโดยใช้ความพยายามในการทำความสะอาดข้อมูลน้อยที่สุด นอกจากนี้ โครงสร้างข้อมูลแบบไฮบริดยังรองรับโครงสร้างการจัดเก็บข้อมูลขนาดใหญ่และทำงานได้ดีสำหรับแอปพลิเคชันขนาดเล็กที่เน้นข้อมูลเป็นหลัก
ขั้นตอนในการใช้งาน Datamart

การสร้างดาต้ามาร์ทเป็นกระบวนการที่คุ้มค่าแต่ก็ซับซ้อน ประกอบด้วยห้าขั้นตอน ได้แก่ การออกแบบ การสร้าง การเติมข้อมูล การเข้าถึง และการจัดการ ซึ่งแต่ละขั้นตอนจะอธิบายไว้ด้านล่าง
การออกแบบ
การออกแบบเป็นขั้นตอนแรกของการนำดาต้ามาร์ทไปใช้ ครอบคลุมทุกขั้นตอนตั้งแต่การร้องขอดาต้ามาร์ทครั้งแรก การรวบรวมข้อกำหนด ไปจนถึงการออกแบบดาต้ามาร์ททั้งในเชิงตรรกะและเชิงกายภาพ
ขั้นตอนการออกแบบเกี่ยวข้องกับงานต่อไปนี้:
- รวบรวมข้อกำหนดทางธุรกิจและทางเทคนิค และระบุแหล่งข้อมูล
- การเลือกชุดย่อยของข้อมูลที่เหมาะสม
- การออกแบบโครงสร้างเชิงตรรกะและทางกายภาพของดาต้ามาร์ท
สามารถแบ่งข้อมูลตามเกณฑ์ต่อไปนี้ได้:
- วันที่
- หน่วยธุรกิจหรือหน่วยปฏิบัติงาน
- ภูมิศาสตร์
- การรวมกันดังกล่าวข้างต้น
สามารถแบ่งพาร์ติชันข้อมูลได้ที่ระดับแอปพลิเคชันหรือระดับ DBMS แต่แนะนำให้แบ่งพาร์ติชันที่ระดับแอปพลิเคชัน เนื่องจากช่วยให้สามารถใช้โมเดลข้อมูลที่แตกต่างกันได้ในแต่ละปีตามการเปลี่ยนแปลงของสภาพแวดล้อมทางธุรกิจ ดาต้ามาทส่วนใหญ่สร้างขึ้นบน... แบบจำลองมิติเช่น โครงสร้างข้อมูลแบบดาว (star schema) เพื่อให้การค้นหาข้อมูลรวดเร็ว
คุณต้องการผลิตภัณฑ์และเทคโนโลยีอะไรบ้าง?
เพียงแค่ปากกาและกระดาษก็เพียงพอแล้วในขั้นตอนนี้ เครื่องมือที่ช่วยในการสร้างแผนภาพ UML หรือแผนภาพความสัมพันธ์ระหว่างเอนทิตี ยังสามารถเพิ่มเมตาเดตาให้กับแบบจำลองเชิงตรรกะและเชิงกายภาพของคุณได้อีกด้วย
การสร้าง
การสร้างโครงสร้างเป็นขั้นตอนที่สองของการนำไปใช้งาน ซึ่งเกี่ยวข้องกับการสร้างฐานข้อมูลทางกายภาพและโครงสร้างเชิงตรรกะ
ขั้นตอนนี้ประกอบด้วยงานดังต่อไปนี้:
- การนำฐานข้อมูลทางกายภาพที่ออกแบบไว้ในขั้นตอนก่อนหน้านี้มาใช้งานจริง เช่น การสร้างอ็อบเจ็กต์สคีมา เช่น ตาราง ดัชนี และวิว
คุณต้องการผลิตภัณฑ์และเทคโนโลยีอะไรบ้าง?
ในการสร้างดาต้ามาท คุณจำเป็นต้องมีระบบจัดการฐานข้อมูลเชิงสัมพันธ์ (RDBMS) RDBMS มีคุณสมบัติหลายอย่างที่จำเป็นต่อความสำเร็จของดาต้ามาท:
- การจัดการพื้นที่เก็บข้อมูล: ระบบจัดการฐานข้อมูลเชิงสัมพันธ์ (RDBMS) ทำหน้าที่จัดเก็บและจัดการข้อมูล ทำให้คุณสามารถสร้าง เพิ่ม และลบระเบียนได้
- การเข้าถึงข้อมูลที่รวดเร็ว: ด้วยคำสั่ง SQL คุณสามารถดึงข้อมูลตามเงื่อนไขหรือตัวกรองที่กำหนดได้อย่างง่ายดาย
- การป้องกันข้อมูล: ระบบ RDBMS สามารถกู้คืนจากความล้มเหลวของระบบ เช่น ไฟฟ้าดับ และกู้คืนข้อมูลจากข้อมูลสำรองได้หากดิสก์เสียหาย
- การสนับสนุนผู้ใช้หลายคน: ระบบนี้รองรับการเข้าถึงพร้อมกัน ทำให้ผู้ใช้หลายคนสามารถอ่านและแก้ไขข้อมูลได้โดยไม่เขียนทับการเปลี่ยนแปลงของผู้อื่น
- การรักษาความปลอดภัย: มันควบคุมว่าผู้ใช้รายใดสามารถเข้าถึงวัตถุใดได้บ้าง และสามารถดำเนินการใดได้บ้าง
กำลังประชากร
ในขั้นตอนที่สาม ข้อมูลจะถูกป้อนเข้าไปในดาต้ามาท
ขั้นตอนการเติมข้อมูลเกี่ยวข้องกับงานต่อไปนี้:
- แผนที่แสดงที่ตั้งบริษัทping แปลงข้อมูลจากแหล่งต้นทางเป็นข้อมูลปลายทาง
- Extracการตรวจสอบข้อมูลต้นฉบับ
- การทำความสะอาดและการแปลงข้อมูล
- กำลังโหลดข้อมูลลงในดาต้ามาท
- การสร้างและการจัดเก็บข้อมูลเมตา
คุณต้องการผลิตภัณฑ์และเทคโนโลยีอะไรบ้าง?
คุณดำเนินการงานเหล่านี้ด้วย ETL (เช่น)tracเครื่องมือ (t, Transform, Load) จะตรวจสอบแหล่งข้อมูลและทำการแปลงข้อมูลจากแหล่งข้อมูลไปยังเป้าหมายpingแล้วก็...tracts จะทำการแปลง ทำความสะอาด และโหลดข้อมูลลงในดาต้ามาท
ในระหว่างกระบวนการนี้ เครื่องมือดังกล่าวยังสร้างเมตาเดตาขึ้นมาด้วย ซึ่งเป็นรายละเอียดต่างๆ เช่น แหล่งที่มาของข้อมูล ความใหม่ของข้อมูล การเปลี่ยนแปลงที่เกิดขึ้น และระดับการสรุปข้อมูลที่ใช้
การเข้าถึง
การเข้าถึงข้อมูลเป็นขั้นตอนที่สี่ และเป็นการนำข้อมูลไปใช้ประโยชน์ ได้แก่ การสอบถามข้อมูล การสร้างรายงานและแผนภูมิ และการเผยแพร่ ผู้ใช้ปลายทางจะส่งคำสอบถามและดูผลลัพธ์ ซึ่งมักจะผ่านทาง สพป tools.
ขั้นตอนการเข้าถึงประกอบด้วยงานต่อไปนี้:
- สร้างเลเยอร์เมตาที่แปลงโครงสร้างฐานข้อมูลและชื่อวัตถุให้เป็นคำศัพท์ทางธุรกิจ เพื่อให้ผู้ใช้ที่ไม่เชี่ยวชาญด้านเทคนิคสามารถเข้าถึงดาต้ามาทได้อย่างง่ายดาย
- การติดตั้งและบำรุงรักษาโครงสร้างฐานข้อมูล
- ตั้งค่า API และอินเทอร์เฟซหากจำเป็น
คุณต้องการผลิตภัณฑ์และเทคโนโลยีอะไรบ้าง?
คุณสามารถเข้าถึงดาต้ามาร์ทได้โดยใช้บรรทัดคำสั่งหรืออินเทอร์เฟซผู้ใช้แบบกราฟิก (GUI) โดยปกติแล้วจะนิยมใช้ GUI มากกว่า เนื่องจากสร้างกราฟได้ง่ายกว่าและใช้งานง่ายกว่าบรรทัดคำสั่ง
ผู้จัดการ
การจัดการเป็นขั้นตอนสุดท้ายของกระบวนการสร้างดาต้ามาร์ท โดยทีมงานจะจัดการงานบริหารจัดการอย่างต่อเนื่อง เช่น: ผ่านทาง GUI หรือบรรทัดคำสั่ง
- การจัดการการเข้าถึงของผู้ใช้อย่างต่อเนื่อง
- การเพิ่มประสิทธิภาพและการปรับแต่งระบบเพื่อประสิทธิภาพที่ดีขึ้น
- การเพิ่มและจัดการข้อมูลใหม่ในดาต้ามาท
- วางแผนสถานการณ์การกู้คืนระบบเพื่อให้ระบบยังคงใช้งานได้หากเกิดความล้มเหลว
- กู้คืนระบบจากความล้มเหลวของฮาร์ดแวร์และซอฟต์แวร์พร้อมทั้งรักษาข้อมูลไว้ได้
แนวทางปฏิบัติที่ดีที่สุดสำหรับการนำ Data Marts ไปใช้
ปฏิบัติตามแนวทางปฏิบัติที่ดีที่สุดเหล่านี้ตลอดกระบวนการสร้างดาต้ามาท:
- จัดโครงสร้างแหล่งข้อมูลของดาต้ามาทตามแผนกต่างๆ
- วัดรอบการดำเนินการเป็นสัปดาห์ แทนที่จะเป็นเดือนหรือปี
- ควรดึงผู้มีส่วนได้ส่วนเสียทั้งหมดเข้ามามีส่วนร่วมในขั้นตอนการวางแผนและการออกแบบ เนื่องจากกระบวนการสร้างดาต้ามาทนั้นอาจมีความซับซ้อน
- วางแผนงบประมาณอย่างแม่นยำสำหรับฮาร์ดแวร์ ซอฟต์แวร์ เครือข่าย และค่าใช้จ่ายในการติดตั้งระบบดาต้ามาร์ท
- แม้ว่าดาต้ามาร์ทจะใช้ฮาร์ดแวร์ร่วมกัน แต่ก็อาจต้องการซอฟต์แวร์ที่แตกต่างกันเพื่อจัดการกับคำถามของผู้ใช้ ประเมินกำลังประมวลผลและพื้นที่จัดเก็บเพิ่มเติมที่จำเป็นสำหรับการตอบสนองที่รวดเร็ว
- เมื่อดาต้ามาทตั้งอยู่ในตำแหน่งที่แตกต่างจากดาต้าแวร์เฮาส์ ตรวจสอบให้แน่ใจว่ามีความจุเครือข่ายเพียงพอสำหรับการย้ายปริมาณข้อมูลที่ต้องการ
- จัดสรรงบประมาณสำหรับเวลาในการโหลด ซึ่งจะเพิ่มขึ้นตามความซับซ้อนของการแปลงข้อมูล
ข้อดีและข้อเสียของ Data Mart
เช่นเดียวกับการเลือกใช้สถาปัตยกรรมใดๆ ก็ตาม ดาต้า มาร์ท นำมาซึ่งข้อดีที่ชัดเจน พร้อมกับข้อแลกเปลี่ยนบางประการ
ข้อดี
- ดาต้ามาท (Data Mart) คือชุดข้อมูลย่อยขององค์กรที่เก็บข้อมูลซึ่งมีประโยชน์ต่อกลุ่มผู้ใช้เฉพาะกลุ่ม
- นี่เป็นทางเลือกที่คุ้มค่ากว่าการสร้างคลังข้อมูลขนาดใหญ่ ซึ่งมีค่าใช้จ่ายสูง
- ดาต้ามาทช่วยให้เข้าถึงข้อมูลได้รวดเร็วยิ่งขึ้น
- ใช้งานง่าย เนื่องจากได้รับการออกแบบมาเพื่อตอบสนองความต้องการเฉพาะของผู้ใช้ ซึ่งสามารถช่วยเร่งกระบวนการทางธุรกิจได้
- การสร้างดาต้ามาทใช้เวลาน้อยกว่าการสร้างดาต้าแวร์เฮาส์ เนื่องจากคุณมุ่งเน้นไปที่ข้อมูลเพียงส่วนย่อยเท่านั้น
- ประกอบด้วยข้อมูลทางประวัติศาสตร์ที่ช่วยให้นักวิเคราะห์ระบุแนวโน้มได้
ข้อเสีย
- บางครั้งองค์กรต่างๆ สร้างคลังข้อมูลที่แตกต่างกันและไม่เกี่ยวข้องกันมากเกินไป ซึ่งทำให้ยากต่อการบำรุงรักษา
- ดาต้ามาทไม่สามารถให้การวิเคราะห์ข้อมูลทั่วทั้งบริษัทได้ เนื่องจากชุดข้อมูลมีจำกัด
