
คลังข้อมูล Archiเทคเจอร์ ส่วนประกอบ และไดอะแกรม Concepts
 เดวิดคาร์เตอร์
⚡ สรุปอย่างชาญฉลาด
คลังข้อมูล Archiโครงสร้างข้อมูลกำหนดวิธีการจัดระเบียบข้อมูลทางประวัติศาสตร์และข้อมูลสะสมจากหลายแหล่งให้เป็นชั้นๆ และส่วนประกอบที่เชื่อมต่อกัน ซึ่งช่วยให้สามารถรายงาน วิเคราะห์ และมีข้อมูลที่ถูกต้องเพียงแหล่งเดียวสำหรับการตัดสินใจและการคาดการณ์ขององค์กรได้อย่างน่าเชื่อถือ
คลังข้อมูล Concepts
A คลังข้อมูล ระบบนี้มีอยู่เพื่อให้บริษัทมีข้อมูลที่ถูกต้องและเป็นเอกภาพสำหรับการตัดสินใจและการคาดการณ์ เป็นระบบข้อมูลที่เก็บรวบรวมข้อมูลในอดีตและข้อมูลสะสมจากแหล่งข้อมูลหนึ่งแหล่งหรือหลายแหล่ง
การจัดระเบียบข้อมูลเพื่อการวิเคราะห์แทนที่จะเป็นข้อมูลธุรกรรม ทำให้คลังข้อมูลช่วยลดความซับซ้อนของงานรายงานและการวิเคราะห์ขององค์กรทั้งหมดได้
ลักษณะของคลังข้อมูล
คลังข้อมูลมีลักษณะเด่นสี่ประการที่แตกต่างจากฐานข้อมูลการดำเนินงานทั่วไป:
- เน้นหัวเรื่อง
- แบบบูรณาการ
- ตัวแปรเวลา
- ไม่ระเหย
เน้นหัวเรื่อง
คลังข้อมูลมีลักษณะเฉพาะตามหัวข้อ เนื่องจากให้ข้อมูลเกี่ยวกับหัวข้อใดหัวข้อหนึ่งมากกว่าการดำเนินงานอย่างต่อเนื่องของบริษัท หัวข้อทั่วไปได้แก่ การขาย การตลาด และการจัดจำหน่าย
แทนที่จะเน้นการประมวลผลรายวัน คลังข้อมูลนี้เน้นการสร้างแบบจำลองและการวิเคราะห์เพื่อประกอบการตัดสินใจ โดยนำเสนอภาพรวมที่เรียบง่ายและกระชับของแต่ละเรื่อง และตัดข้อมูลที่ไม่สนับสนุนกระบวนการตัดสินใจออกไป
แบบบูรณาการ
การบูรณาการมีความเกี่ยวข้องอย่างใกล้ชิดกับการวางแนวทางตามหัวเรื่อง ในคลังข้อมูล การบูรณาการหมายถึงการสร้างหน่วยวัดร่วมกันสำหรับข้อมูลที่คล้ายคลึงกันทั้งหมดที่ดึงมาจากฐานข้อมูลที่แตกต่างกัน และการจัดเก็บข้อมูลเหล่านั้นในรูปแบบที่เหมือนกันและเป็นที่ยอมรับในระดับสากล
คลังข้อมูลถูกสร้างขึ้นโดยการบูรณาการข้อมูลจากแหล่งข้อมูลที่หลากหลาย เช่น เมนเฟรม ฐานข้อมูลเชิงสัมพันธ์ และไฟล์ข้อความธรรมดา นอกจากนี้ยังต้องรักษาความสม่ำเสมอในการตั้งชื่อ รูปแบบ และการเข้ารหัสด้วย
ความสอดคล้องกันในเรื่องการตั้งชื่อ การวัดคุณลักษณะ และโครงสร้างการเข้ารหัส คือสิ่งที่ทำให้การวิเคราะห์มีประสิทธิภาพ ลองพิจารณาตัวอย่างต่อไปนี้:
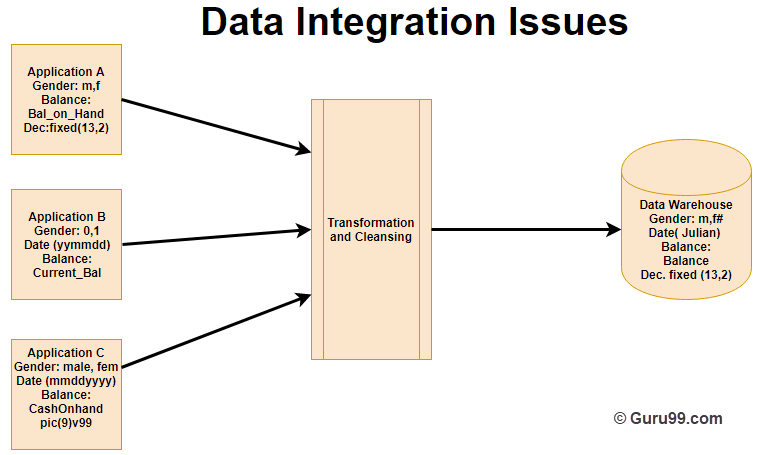
ในตัวอย่างข้างต้น แอปพลิเคชันสามแอปที่ติดป้ายกำกับ A, B และ C ต่างก็จัดเก็บข้อมูลเพศ วันที่ และยอดเงินคงเหลือ แต่แต่ละแอปพลิเคชันจัดเก็บข้อมูลเหล่านั้นด้วยวิธีที่แตกต่างกัน:
- แอปพลิเคชัน A จัดเก็บฟิลด์เพศเป็นค่าตรรกะ เช่น M หรือ F
- แอปพลิเคชัน B จัดเก็บฟิลด์เพศเป็นค่าตัวเลข
- แอปพลิเคชัน C จัดเก็บฟิลด์เพศเป็นค่าตัวอักษร
- รูปแบบเดียวกันนี้ใช้กับช่องวันที่และยอดคงเหลือด้วย
หลังจากกระบวนการแปลงและทำความสะอาดข้อมูลแล้ว ข้อมูลทั้งหมดจะถูกจัดเก็บในรูปแบบเดียวกันภายในคลังข้อมูล
ตัวแปรเวลา
ขอบเขตเวลาของคลังข้อมูลนั้นกว้างกว่าระบบปฏิบัติการมาก ข้อมูลจะถูกระบุในช่วงเวลาที่เฉพาะเจาะจงและให้มุมมองเชิงประวัติศาสตร์ ดังนั้นจึงมีองค์ประกอบของเวลาอยู่เสมอ ไม่ว่าจะโดยชัดแจ้งหรือโดยปริยาย
จุดหนึ่งที่ความคลาดเคลื่อนของเวลาปรากฏให้เห็นคือ โครงสร้างของคีย์บันทึก คีย์หลักทุกตัวในคลังข้อมูลควรมีองค์ประกอบของเวลา เช่น วัน สัปดาห์ หรือเดือน
อีกแง่มุมหนึ่งของความคลาดเคลื่อนตามเวลาคือ เมื่อข้อมูลถูกป้อนเข้าไปในคลังข้อมูลแล้ว จะไม่สามารถอัปเดตหรือเปลี่ยนแปลงได้
ไม่ระเหย
คลังข้อมูลยังเป็นข้อมูลที่ไม่ลบเลือน ซึ่งหมายความว่าข้อมูลเก่าจะไม่ถูกลบเมื่อมีข้อมูลใหม่เข้ามา ข้อมูลเป็นแบบอ่านอย่างเดียวและจะได้รับการอัปเดตเป็นระยะ ซึ่งช่วยให้นักวิเคราะห์สามารถศึกษาข้อมูลในอดีตและเข้าใจว่าเกิดอะไรขึ้นและเมื่อใด
เนื่องจากไม่จำเป็นต้องมีการประมวลผลธุรกรรม การกู้คืน หรือการควบคุมการทำงานพร้อมกัน คลังข้อมูลจึงละเว้นกิจกรรมการลบ การอัปเดต และการแทรกข้อมูล ซึ่งเป็นเรื่องปกติในแอปพลิเคชันการทำงานทั่วไป มีการดำเนินการข้อมูลเพียงสองอย่างเท่านั้นในคลังข้อมูล:
- กำลังโหลดข้อมูล
- การเข้าถึงข้อมูล
ตารางด้านล่างนี้แสดงให้เห็นถึงความแตกต่างที่สำคัญบางประการระหว่างแอปพลิเคชันที่ใช้งานจริงและคลังข้อมูล:
| Operaแอปพลิเคชันแห่งชาติ | คลังข้อมูล |
|---|---|
| จำเป็นต้องเขียนโค้ดโปรแกรมที่ซับซ้อนเพื่อให้แน่ใจว่ากระบวนการอัปเกรดข้อมูลรักษาความสมบูรณ์ของผลิตภัณฑ์ขั้นสุดท้ายในระดับสูง | ปัญหาลักษณะนี้จะไม่เกิดขึ้นหากไม่มีการอัปเดตข้อมูล |
| ข้อมูลจะถูกวางในรูปแบบมาตรฐานเพื่อให้แน่ใจว่ามีความซ้ำซ้อนน้อยที่สุด | ข้อมูลไม่ได้ถูกจัดเก็บในรูปแบบมาตรฐาน |
| เทคโนโลยีที่จำเป็นในการสนับสนุนประเด็นต่างๆ เกี่ยวกับธุรกรรม การกู้คืนข้อมูล การย้อนกลับ และการแก้ไขปัญหาการติดขัดนั้นค่อนข้างซับซ้อน | มันนำเสนอความเรียบง่ายในด้านเทคโนโลยี |
คลังข้อมูล Archiเทคเจอร์
คลังข้อมูล Archiโครงสร้างของคลังข้อมูลมีความซับซ้อน เนื่องจากระบบจัดเก็บข้อมูลในอดีตและข้อมูลสะสมจากหลายแหล่ง มีแนวทางสามประการในการสร้างชั้นของคลังข้อมูล ได้แก่ แบบชั้นเดียว แบบสองชั้น และแบบสามชั้น
สถาปัตยกรรมแบบชั้นเดียว มีเป้าหมายเพื่อลดปริมาณข้อมูลที่จัดเก็บโดยการกำจัดข้อมูลที่ซ้ำซ้อน แต่ในทางปฏิบัติแล้วไม่ค่อยได้ใช้กัน
สถาปัตยกรรมสองชั้น เป็นการแยกแหล่งข้อมูลที่เข้าถึงได้จริงออกจากคลังข้อมูล ไม่สามารถขยายได้ง่าย รองรับผู้ใช้งานปลายทางได้น้อยกว่า และอาจประสบปัญหาการเชื่อมต่อเนื่องจากข้อจำกัดของเครือข่าย
สถาปัตยกรรมสามชั้น เป็นรูปแบบการออกแบบคลังข้อมูลที่ใช้กันอย่างแพร่หลายที่สุด
ประกอบด้วยระดับบน ระดับกลาง และระดับล่าง:
- ชั้นล่างสุด: ฐานข้อมูลของคลังสินค้าทำหน้าที่เป็นชั้นล่างสุด โดยปกติแล้วจะเป็นระบบฐานข้อมูลเชิงสัมพันธ์ และข้อมูลจะถูกทำความสะอาด แปลง และโหลดเข้าสู่ชั้นนี้โดยใช้เครื่องมือแบ็กเอนด์
- ระดับกลาง: ชั้นกลางคือเซิร์ฟเวอร์ OLAP ที่ใช้งานโดยใช้โมเดล ROLAP หรือ MOLAP โดยจะนำเสนอข้อมูลแบบสัมบูรณ์tracทำหน้าที่แสดงภาพรวมของฐานข้อมูลและเป็นตัวกลางระหว่างผู้ใช้ปลายทางกับฐานข้อมูล
- ชั้นบนสุด: ชั้นบนสุดคือชั้นส่วนหน้าของไคลเอนต์ ซึ่งประกอบด้วยเครื่องมือและ API ที่ใช้ในการเชื่อมต่อและดึงข้อมูลจากคลังข้อมูล เช่น เครื่องมือค้นหาข้อมูล เครื่องมือสร้างรายงาน เครื่องมือค้นหาข้อมูลแบบจัดการ เครื่องมือวิเคราะห์ และเครื่องมือขุดค้นข้อมูล
ส่วนประกอบคลังข้อมูล
ส่วนประกอบและโครงสร้างโดยรวมของคลังข้อมูลทำงานร่วมกันดังแสดงในแผนภาพด้านล่าง
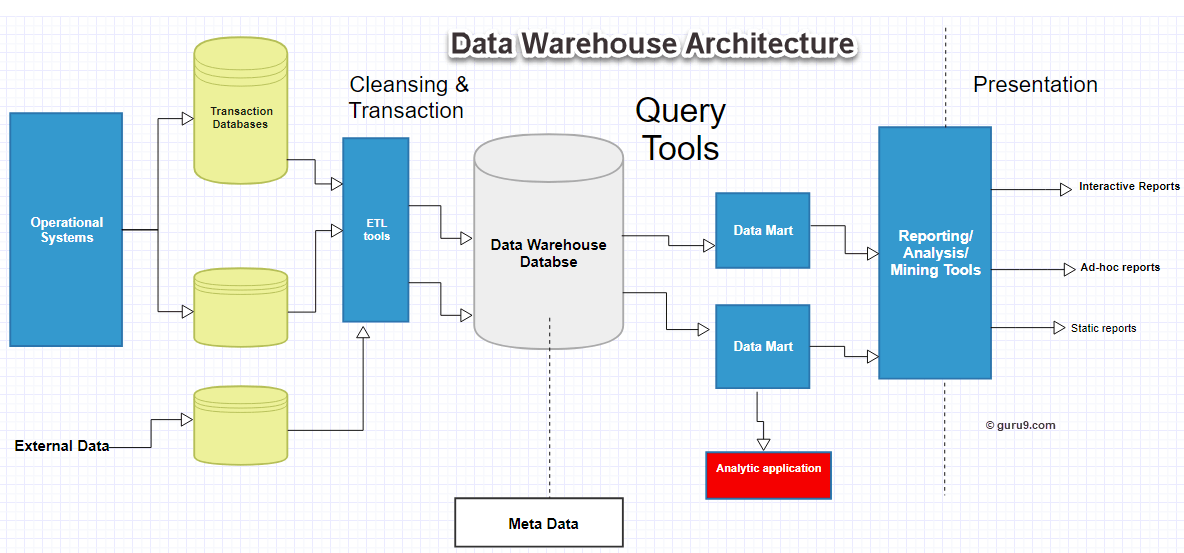
คลังข้อมูลนี้ตั้งอยู่บนเซิร์ฟเวอร์ RDBMS ซึ่งเป็นแหล่งเก็บข้อมูลส่วนกลางที่ล้อมรอบด้วยส่วนประกอบสำคัญต่างๆ ที่ช่วยให้สภาพแวดล้อมโดยรวมทำงานได้อย่างมีประสิทธิภาพ จัดการได้ และเข้าถึงได้ง่าย
คลังข้อมูลประกอบด้วยส่วนประกอบหลัก 5 ส่วน ดังที่อธิบายไว้ด้านล่าง
ฐานข้อมูลคลังข้อมูล
ฐานข้อมูลกลางเป็นรากฐานของสภาพแวดล้อมคลังข้อมูล และถูกนำไปใช้งานบน อาร์ดีบีเอ็มเอส เทคโนโลยี เนื่องจากระบบจัดการฐานข้อมูลเชิงสัมพันธ์แบบดั้งเดิม (RDBMS) ถูกออกแบบมาเพื่อประมวลผลธุรกรรมมากกว่าการจัดเก็บข้อมูล การดำเนินการที่ใช้ทรัพยากรมาก เช่น การสืบค้นข้อมูลเฉพาะกิจ การเชื่อมตารางหลายตาราง และการคำนวณค่ารวม อาจทำให้ระบบทำงานช้าลง
ด้วยเหตุนี้ จึงมีการใช้แนวทางฐานข้อมูลทางเลือกอื่นๆ:
- ฐานข้อมูลเชิงสัมพันธ์ถูกใช้งานแบบขนานเพื่อให้สามารถปรับขนาดได้ โดยใช้โมเดลหน่วยความจำร่วมหรือแบบไม่ร่วมใช้หน่วยความจำ บนระบบประมวลผลแบบหลายโปรเซสเซอร์หรือแบบขนานขนาดใหญ่ต่างๆ
- มีการใช้โครงสร้างดัชนีใหม่เพื่อหลีกเลี่ยงการสแกนตารางเชิงสัมพันธ์และเพิ่มความเร็ว
- ฐานข้อมูลหลายมิติ (MDDBs) ถูกนำมาใช้เพื่อเอาชนะข้อจำกัดของโมเดลคลังข้อมูลเชิงสัมพันธ์ ตัวอย่างเช่น Essbase จาก Oracle.
เครื่องมือการจัดหา การเข้าซื้อกิจการ การล้างข้อมูล และการเปลี่ยนแปลง (ETL)
เครื่องมือในการจัดหา การแปลง และการย้ายข้อมูล จะทำการแปลง สรุป และเปลี่ยนแปลงข้อมูลทั้งหมดที่จำเป็น เพื่อเปลี่ยนข้อมูลให้เป็นรูปแบบคลังข้อมูลที่เป็นหนึ่งเดียว เรียกอีกอย่างว่า Extracเครื่องมือ t, Transform และ Load (ETL)
ฟังก์ชันการทำงานของอุปกรณ์เหล่านี้ประกอบด้วยสิ่งต่อไปนี้:
- ทำให้ข้อมูลไม่ระบุชื่อตามข้อกำหนดด้านกฎระเบียบ
- ลบข้อมูลที่ไม่ต้องการออกจากฐานข้อมูลการดำเนินงานก่อนที่จะนำเข้าสู่คลังสินค้า
- ค้นหาและแทนที่ชื่อและคำจำกัดความทั่วไปสำหรับข้อมูลที่มาจากแหล่งต่างๆ
- คำนวณค่าสรุปและข้อมูลที่ได้มา
- กรอกข้อมูลที่ขาดหายไปโดยใช้ค่าเริ่มต้น
- ลบข้อมูลซ้ำซ้อนที่มาจากหลายแหล่ง
ล้อยางขัดเหล่านี้ติดตั้งบนแกน XNUMX (มม.) ผลิตภัณฑ์นี้ถูกผลิตในหลายรูปทรง และหลากหลายเบอร์ความแน่นหนาของปริมาณอนุภาคขัดของมัน จะทำให้ท่านได้รับประสิทธิภาพสูงในการขัดและการใช้งานที่ยาวนาน เครื่องมือ ETL อาจสร้างงาน Cron, งานเบื้องหลัง, โปรแกรม Cobol และสคริปต์ Shell ที่รีเฟรชคลังข้อมูลเป็นประจำและช่วยบำรุงรักษาเมตาเดต้า
เนื่องจากเครื่องมือ ETL ดึงข้อมูลจากหลายระบบ จึงต้องรับมือกับความหลากหลายของฐานข้อมูลและข้อมูลด้วยเช่นกัน
เมตาดาต้า
เมตาเดตาอาจฟังดูซับซ้อน แต่ที่จริงแล้วมันก็คือข้อมูลเกี่ยวกับข้อมูลที่ใช้กำหนดโครงสร้างของคลังข้อมูลนั่นเอง เมตาเดตาถูกนำมาใช้ในการสร้าง บำรุงรักษา และจัดการคลังข้อมูล
ภายในโครงสร้างสถาปัตยกรรม เมตาเดตาจะระบุแหล่งที่มา การใช้งาน ค่า และคุณลักษณะของข้อมูล และกำหนดวิธีการเปลี่ยนแปลงและประมวลผลข้อมูล เพื่อให้ข้อมูลยังคงเชื่อมโยงกับคลังข้อมูลอย่างใกล้ชิด
ตัวอย่างเช่น บรรทัดหนึ่งในฐานข้อมูลการขายอาจมีข้อมูลดังนี้:
4030 KJ732 299.90
ข้อมูลนี้จะไม่มีความหมายจนกว่าข้อมูลเมตาจะอธิบายว่ามันแสดงถึงหมายเลขรุ่น 4030 รหัสตัวแทนขาย KJ732 และยอดขายรวม 299.90 ดอลลาร์สหรัฐ
ดังนั้น เมตาเดตาจึงเป็นส่วนประกอบสำคัญในการเปลี่ยนข้อมูลให้เป็นองค์ความรู้ และช่วยตอบคำถามต่างๆ เช่น:
- คลังข้อมูลนี้ประกอบด้วยตาราง คุณลักษณะ และคีย์อะไรบ้าง?
- ข้อมูลมาจากไหน?
- ข้อมูลถูกโหลดซ้ำกี่ครั้ง?
- มีการเปลี่ยนแปลงและชำระล้างอะไรบ้าง?
ข้อมูลเมตาแบ่งออกเป็นสองประเภท:
- ข้อมูลเมตาทางเทคนิค: นี่คือคำอธิบายเกี่ยวกับคลังสินค้าสำหรับนักออกแบบและผู้บริหารที่สร้างและดำเนินงานคลังสินค้านี้
- ข้อมูลเมตาของธุรกิจ: วิธีนี้ช่วยให้ผู้ใช้ปลายทางเข้าใจข้อมูลที่จัดเก็บไว้ในคลังข้อมูลได้ง่ายขึ้น
เครื่องมือสืบค้นข้อมูล
เป้าหมายหลักของการจัดเก็บข้อมูลคือการให้ข้อมูลที่ธุรกิจต้องการเพื่อประกอบการตัดสินใจเชิงกลยุทธ์ และเครื่องมือค้นหาข้อมูลคือวิธีการที่ผู้ใช้โต้ตอบกับระบบ
เครื่องมือเหล่านี้แบ่งออกเป็นสี่ประเภท:
- เครื่องมือสืบค้นและการรายงาน
- เครื่องมือพัฒนาแอปพลิเคชัน
- เครื่องมือขุดข้อมูล
- เครื่องมือ OLAP
เครื่องมือสอบถามและรายงาน
เครื่องมือสอบถามและสร้างรายงานแบ่งออกเป็นสองกลุ่ม ได้แก่ เครื่องมือสร้างรายงาน และเครื่องมือจัดการการสอบถามข้อมูล
เครื่องมือการรายงาน แบ่งย่อยออกเป็นเครื่องมือรายงานการผลิตและโปรแกรมสร้างรายงานบนเดสก์ท็อป:
- ผู้เขียนรายงาน: เครื่องมือเหล่านี้ออกแบบมาสำหรับผู้ใช้งานทั่วไปที่ต้องการสร้างการวิเคราะห์ด้วยตนเอง
- รายงานการผลิต: ซอฟต์แวร์เหล่านี้ช่วยให้องค์กรสามารถสร้างรายงานการดำเนินงานเป็นประจำและรองรับงานประมวลผลแบบกลุ่มปริมาณมาก เช่น การพิมพ์และการคำนวณ ตัวอย่างที่นิยมได้แก่ Brio และ Business Objects Oracleรวมถึง PowerSoft และ SAS Institute ด้วย
เครื่องมือสืบค้นที่มีการจัดการ ช่วยผู้ใช้งานโดยการแทรกเลเยอร์กลางระหว่างผู้ใช้กับฐานข้อมูล ซึ่งจะซ่อนความซับซ้อนของ SQL และโครงสร้างฐานข้อมูล
เครื่องมือพัฒนาแอปพลิเคชัน
เมื่อเครื่องมือสร้างกราฟและวิเคราะห์ข้อมูลที่มีอยู่ภายในระบบไม่สามารถตอบสนองความต้องการด้านการวิเคราะห์ขององค์กรได้ จึงจำเป็นต้องสร้างรายงานแบบกำหนดเองโดยใช้เครื่องมือพัฒนาแอปพลิเคชัน
เครื่องมือขุดข้อมูล
การขุดค้นข้อมูลค้นพบความสัมพันธ์ รูปแบบ และแนวโน้มใหม่ที่มีความหมายภายในข้อมูลปริมาณมหาศาล และเครื่องมือขุดค้นข้อมูลจะช่วยทำให้การค้นพบนั้นเป็นไปโดยอัตโนมัติ
เครื่องมือ OLAP
สพป เครื่องมือเหล่านี้สร้างขึ้นบนฐานข้อมูลแบบหลายมิติ และช่วยให้ผู้ใช้สามารถวิเคราะห์ข้อมูลผ่านมุมมองแบบหลายมิติที่ซับซ้อนได้
รถบัสคลังข้อมูล Archiเทคเจอร์
ระบบบัสของคลังข้อมูลทำหน้าที่กำหนดวิธีการไหลของข้อมูลผ่านคลังข้อมูล การไหลนั้นสามารถแบ่งออกเป็น การไหลเข้า การไหลขึ้น การไหลลง การไหลออก และการไหลระดับเมตา
ในการออกแบบบัส คุณต้องคำนึงถึงมิติและข้อเท็จจริงที่ใช้ร่วมกันซึ่งครอบคลุมดาต้ามาร์ทต่างๆ
ดาต้า มาร์ท
A ดาต้ามาร์ท เป็นเลเยอร์การเข้าถึงที่ใช้ในการส่งข้อมูลไปยังผู้ใช้ เหมาะสำหรับคลังข้อมูลขนาดใหญ่เพราะใช้เวลาน้อยลงและค่าใช้จ่ายในการสร้างน้อยกว่า แม้ว่าจะไม่มีคำจำกัดความที่ตกลงกันไว้เป็นเอกฉันท์สำหรับดาต้ามาทก็ตาม
กล่าวโดยง่าย Data Mart คือส่วนย่อยของ Data Warehouse ทำหน้าที่แบ่งข้อมูลสำหรับกลุ่มผู้ใช้เฉพาะกลุ่ม และสามารถจัดเก็บอยู่ในฐานข้อมูลเดียวกันกับ Data Warehouse หรืออยู่ในฐานข้อมูลที่แยกต่างหากก็ได้
คลังข้อมูล Archiแนวทางปฏิบัติที่ดีที่สุดสำหรับการสอน
ในการออกแบบสถาปัตยกรรมคลังข้อมูลที่มีประสิทธิภาพ ควรปฏิบัติตามแนวทางปฏิบัติที่ดีที่สุดดังต่อไปนี้:
- ใช้โมเดลคลังข้อมูลที่ได้รับการปรับให้เหมาะสมสำหรับการดึงข้อมูล ไม่ว่าจะเป็น มิติวิธีการที่ไม่ปรับค่ามาตรฐาน หรือวิธีการแบบผสมผสาน
- เลือกวิธีการออกแบบที่เหมาะสม ไม่ว่าจะเป็นแบบจากบนลงล่างหรือจากล่างขึ้นบน
- ตรวจสอบให้แน่ใจว่าข้อมูลได้รับการประมวลผลอย่างรวดเร็วและแม่นยำ พร้อมทั้งรวบรวมข้อมูลทั้งหมดไว้ในเวอร์ชันเดียวที่เป็นความจริง
- ออกแบบกระบวนการเก็บรวบรวมและทำความสะอาดข้อมูลสำหรับคลังข้อมูลอย่างรอบคอบ
- ออกแบบสถาปัตยกรรมเมตาเดตาที่ช่วยให้สามารถแบ่งปันเมตาเดตาระหว่างส่วนประกอบต่างๆ ของคลังข้อมูลได้
- พิจารณาไฟล์ Operaรูปแบบคลังข้อมูลระดับภูมิภาค (ODS) เมื่อความต้องการในการเรียกค้นข้อมูลอยู่ใกล้ระดับล่างสุดของฐานข้อมูลtracในกรณีที่จำเป็นต้องใช้แหล่งข้อมูลปฏิบัติการหลายแหล่ง เช่น พีระมิดข้อมูล
- ตรวจสอบให้แน่ใจว่าแบบจำลองข้อมูลมีการบูรณาการ แทนที่จะเป็นการรวมเข้าด้วยกันเพียงอย่างเดียว ในกรณีดังกล่าว ให้ใช้แบบจำลองข้อมูล 3NF ซึ่งเหมาะอย่างยิ่งเมื่อเลือกใช้เครื่องมือ ETL และเครื่องมือทำความสะอาดข้อมูล
