
Przekierowanie wejścia/wyjścia w przykładach systemu Linux/Unix
 Emilia Cartera
⚡ Inteligentne podsumowanie
Przekierowanie w systemach Linux i Unix zmienia miejsce, w którym polecenie odczytuje dane wejściowe lub wysyła dane wyjściowe,ping klawiatura i ekran dla plików lub urządzeń przy użyciu operatorów takich jak znak większości, znak mniejszości i operator dołączania.
Przekierowanie jest jedną z najprzydatniejszych funkcji Linux i powłoka Unix, ponieważ pozwala określić, gdzie polecenie odczytuje dane wejściowe i wysyła dane wyjściowe. Ta strona wyjaśnia przekierowywanie danych wyjściowych, wejściowych i błędów wraz z przykładami.
Co to jest przekierowanie?
Przekierowanie to funkcja w Linuksie, dzięki której podczas wykonywania polecenia można zmienić standardowe urządzenia wejściowe i wyjściowe. Podstawowy przepływ pracy każdego Polecenie Linuksa polega na tym, że przyjmuje dane wejściowe i daje dane wyjściowe.
- Standardowym urządzeniem wejściowym (stdin) jest klawiatura.
- Standardowym urządzeniem wyjściowym (stdout) jest ekran.
Dzięki przekierowaniu można zmienić powyższe standardowe dane wejściowe i wyjściowe.
Przekierowanie wyjścia
Poniższa grafika stanowi początek przykładów przekierowywania wyjścia.

Symbol '>' służy do przekierowania wyjścia (STDOUT).
Przykład:
ls -al > listings
W tym przypadku wynik polecenia ls -al jest przekierowywany do pliku „listings” zamiast na ekran. Wynik pokazuje poniższy zrzut ekranu.

Uwaga: Podczas przekierowywania wyników polecenia do pliku należy użyć prawidłowej nazwy pliku. Jeśli plik o tej samej nazwie już istnieje, przekierowane polecenie usunie jego zawartość, a następnie ją nadpisze.
Jeśli nie chcesz nadpisać pliku, ale chcesz dodać więcej treści do istniejącego pliku, użyj operatora „>>”. Poniższy zrzut ekranu pokazuje treść z dołączonym operatorem „>>”.

Możesz przekierować standardowe wyjście nie tylko do plików, ale także do urządzeń.
$ cat music.mp3 > /dev/audio
Polecenie cat odczytuje plik music.mp3 i wysyła dane wyjściowe do /dev/audio, czyli urządzenia audio. Jeśli konfiguracja dźwięku na komputerze jest poprawna, to polecenie odtworzy plik music.mp3.
Przekierowanie wejścia
Poniższa grafika przedstawia przekierowywanie danych wejściowych.
Symbol „<” służy do przekierowania danych wejściowych (STDIN).
Przykład: Program pocztowy w systemie Linux może pomóc w wysyłaniu wiadomości e-mail z terminala.
Treść wiadomości e-mail możesz wpisać za pomocą klawiatury, czyli standardowego urządzenia wejściowego. Jeśli jednak chcesz dołączyć plik do wiadomości e-mail, możesz użyć operatora przekierowania danych wejściowych w poniższym formacie.
mail -s "Subject" to-address < Filename
Poniższy zrzut ekranu pokazuje polecenie mail odczytujące plik jako swoje dane wejściowe.

Plik zostaje dołączony do wiadomości e-mail i wysłany do odbiorcy.
Powyższe przykłady były proste. Teraz przyjrzyjmy się zaawansowanym technikom przekierowywania, które wykorzystują deskryptory plików.
filet Descriptory (FD)
W systemach Linux i Unix wszystko jest plikiem. Zwykłe pliki, katalogi, a nawet urządzenia są plikami. Każdy plik ma przypisany numer zwany deskryptorem pliku (FD).
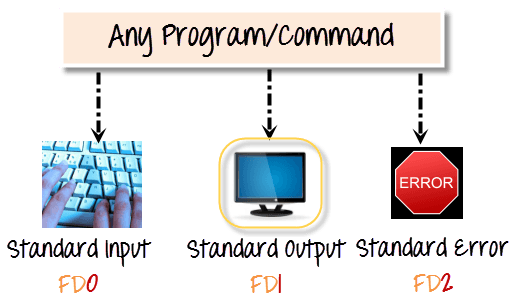
Poniższy diagram przedstawia standardowe strumienie i ich deskryptory plików.
Twój ekran ma również deskryptor pliku. Po uruchomieniu programu, dane wyjściowe są wysyłane do deskryptora pliku ekranu, a Ty widzisz dane wyjściowe programu na monitorze. Gdyby dane wyjściowe zostały wysłane do deskryptora pliku drukarki, dane wyjściowe programu zostałyby wydrukowane.
Błąd przekierowania
Za każdym razem, gdy uruchamiasz program lub polecenie w terminalu, otwarte są trzy pliki: standardowe wejście, standardowe wyjście i standardowe wyjście błędów.
Pliki te są zawsze obecne przy każdym uruchomieniu programu. Jak wyjaśniono wcześniej, z każdym z tych plików jest powiązany deskryptor pliku.
| filet | filet Descriptor |
|---|---|
| Standardowe wejście STDIN | 0 |
| Standardowe wyjście STDOUT | 1 |
| Błąd standardowy STDERR | 2 |
Domyślnie strumień błędów jest wyświetlany na ekranie. Przekierowanie błędów kieruje błędy do pliku innego niż ekran.
Dlaczego przekierowanie błędów?
Przekierowywanie błędów jest jedną z bardzo popularnych funkcji systemów Unix i Linux.
Doświadczeni użytkownicy Uniksa wiedzą, że wiele poleceń generuje mnóstwo błędów. Na przykład podczas wyszukiwania plików zazwyczaj pojawia się… pozwolenie błędy odmowy, które zazwyczaj nie pomagają osobie wyszukującej konkretny plik. Podczas wykonywania skryptów powłoki często nie chcemy, aby komunikaty o błędach zaśmiecały normalne wyjście programu.
Rozwiązaniem jest przekierowanie komunikatów o błędach do pliku.
1 przykład
$ myprogram 2>errorsfile
Zrzut ekranu poniżej pokazuje to polecenie w terminalu.

Powyżej wykonujemy program o nazwie myprogram. Deskryptor pliku dla standardowego wyjścia błędów to 2. Używając „2>”, przekierowujemy wyjście błędu do pliku o nazwie „errorsfile”. Dzięki temu wyjście programu nie jest zaśmiecone błędami.
2 przykład
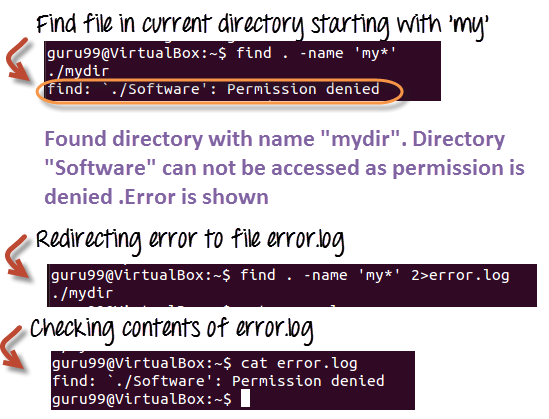
Oto kolejny przykład wykorzystujący polecenie find.
find . -name 'my*' 2>error.log
Używając polecenia find, przeszukujemy bieżący katalog „.” w celu znalezienia pliku, którego nazwa zaczyna się od „my” i wysyłamy wszelkie błędy do pliku error.log.
3 przykład: Przyjrzyjmy się bardziej złożonemu przykładowi.
Administratorzy serwerów często tworzą listę katalogów i zapisują zarówno komunikaty o błędach, jak i standardowe wyjście w pliku, który można później przetworzyć. Oto polecenie.
ls Documents ABC> dirlist 2>&1
Poniższy diagram przedstawia oba strumienie przechwytywane w jednym pliku.
Tutaj:
- 2>&1 oznacza, że STDERR jest przekierowywany do tego samego celu co STDOUT (czyli do listy katalogów plików).
- Wyjście błędu jest przekierowywane na standardowe wyjście, które z kolei jest przekierowywane do pliku dirlist. W związku z tym oba strumienie są zapisywane do pliku dirlist.
Poniższy diagram podsumowuje, w jaki sposób przekierowywanie danych wejściowych, wyjściowych i błędów jest ze sobą powiązane.

