
Samouczek dotyczący sztucznej sieci neuronowej (ANN) z TensorFlow
 Zespół redakcyjny
⚡ Inteligentne podsumowanie
Sztuczne sieci neuronowe uczą się, przesyłając dane wejściowe przez połączone warstwy, oceniając wynik za pomocą funkcji straty i korygując wagi za pomocą optymalizatora. W tym przewodniku zbudujemy taką sieć w TensorFlow i klasyfikujemy cyfry MNIST.
Co to jest sztuczna sieć neuronowa?
An Sztuczna sieć neuronowa (SSN) to system komputerowy inspirowany biologicznymi sieciami neuronowymi, służący do tworzenia sztucznych mózgów w oparciu o zbiór połączonych jednostek zwanych sztucznymi neuronami. Został zaprojektowany do analizowania i przetwarzania informacji w sposób podobny do tego, jaki robią ludzie. Sztuczna sieć neuronowa posiada zdolność samouczenia się, co pozwala jej uzyskiwać lepsze wyniki w miarę zwiększania się dostępności danych.
Poniższy diagram tracto jedno pełne przejście przez taką sieć, od surowego wejścia do optymalizatora, który koryguje wagi.

Sztuczna sieć neuronowa (ANN) składa się z czterech głównych obiektów:
- Warstwy: Cała nauka odbywa się warstwowo. Są 3 warstwy: 1) wejściowa, 2) ukryta i 3) wyjściowa.
- Funkcja i etykieta: Dane wejściowe do sieci (cechy) i dane wyjściowe z sieci (etykiety)
- Funkcja strat: Metryka służąca do oszacowania wydajności fazy uczenia się
- Optymalizator: Popraw naukę poprzez aktualizację wiedzy w sieci
Sieć neuronowa pobiera dane wejściowe i przesyła je do zespołu warstw. Następnie sieć ocenia swoją wydajność za pomocą funkcji straty. Funkcja straty daje sieci pojęcie o ścieżce, którą musi pokonać, aby opanować wiedzę. Sieć ulepsza tę wiedzę za pomocą optymalizatora.
Jeśli spojrzysz na powyższy rysunek, zrozumiesz leżący u jego podstaw mechanizm.
Program pobiera wartości wejściowe i umieszcza je w dwóch w pełni połączonych warstwach. Wyobraź sobie, że masz problem matematyczny. Pierwszą rzeczą, jaką robisz, jest przeczytanie odpowiedniego rozdziału, aby go rozwiązać. Następnie stosujesz zdobytą wiedzę do rozwiązania problemu. Istnieje duże prawdopodobieństwo, że nie uzyskasz zbyt dobrego wyniku. To samo dotyczy sieci: gdy po raz pierwszy widzi dane i dokonuje prognozy, wynik nie będzie idealnie zgodny z rzeczywistymi danymi.
Aby poszerzyć swoją wiedzę, sieć korzysta z optymalizatora. W tej analogii optymalizator można porównać do ponownego przeczytania rozdziału. Dzięki ponownemu przeczytaniu zyskujesz nowe spostrzeżenia. Podobnie sieć korzysta z optymalizatora, aktualizuje swoją wiedzę i testuje ją, aby sprawdzić, ile jeszcze musi się nauczyć. Program powtarza ten krok, aż osiągnie najniższy możliwy błąd.
W analogii do zadania matematycznego oznacza to, że czytasz rozdział podręcznika wiele razy, aż do całkowitego zrozumienia treści kursu. Nawet po wielokrotnym przeczytaniu, jeśli ciągle popełniasz błąd, oznacza to, że osiągnąłeś limit wiedzy w ramach bieżącego materiału. Musisz skorzystać z innego podręcznika lub przetestować inną metodę, aby poprawić swój wynik. W przypadku sieci neuronowej proces jest taki sam. Jeśli błąd przestanie spadać, a krzywa strat stanie się płaska, obecna architektura nie będzie w stanie nauczyć się niczego więcej. Sieć musi zostać lepiej zoptymalizowana, aby pogłębić wiedzę.
Te cztery obiekty są bezpośrednio odwzorowywane na komponenty konfigurowane podczas projektowania sieci.
Sieć neuronowa Architektura
Architektura sztucznej sieci neuronowej składa się z następujących komponentów:
- Warstwy
- Funkcja aktywacji
- Funkcja utraty
- Optimizer
Warstwy
Warstwa to miejsce, w którym odbywa się całe uczenie. Wewnątrz warstwy znajduje się dowolna liczba neuronów, z których każdy ma swoją własną wagę. Typowa sieć neuronowa jest często przetwarzana przez warstwy gęsto połączone (nazywane również warstwami w pełni połączonymi). Oznacza to, że wszystkie wejścia są połączone z wyjściami.
Typowa sieć neuronowa przyjmuje wektor wejściowy i skalar zawierający etykiety. Najprostsza konfiguracja to klasyfikacja binarna z tylko dwiema klasami: 0 i 1.
Sieć pobiera dane wejściowe, wysyła je do wszystkich połączonych węzłów i oblicza sygnał za pomocą funkcji aktywacji. Poniższy diagram numeryczny przedstawia pojedynczy węzeł, dzięki czemu można osobno zobaczyć sumę ważoną i krok aktywacji.

Powyższy rysunek ilustruje tę ideę. Pierwsza warstwa przechowuje wartości wejściowe. Druga warstwa, zwana warstwą ukrytą, odbiera ważone dane wejściowe z poprzedniej warstwy.
- Pierwszy węzeł to wartości wejściowe.
- Neuron jest rozkładany na część wejściową i funkcję aktywacji. Lewa część otrzymuje wszystkie dane wejściowe z poprzedniej warstwy. Prawa część to suma danych wejściowych przekazanych do funkcji aktywacji.
- Wartość wyjściowa obliczona z warstw ukrytych i używana do prognozowania. W przypadku klasyfikacji jest ona równa liczbie klas. W przypadku regresji przewidywana jest tylko jedna wartość.
Funkcja aktywacji
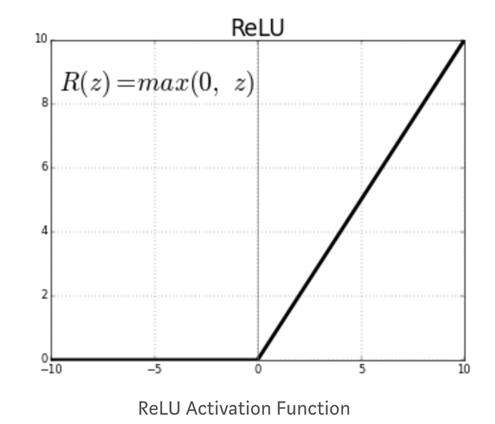
Funkcja aktywacji węzła definiuje wynik na podstawie zestawu danych wejściowych. Funkcja aktywacji jest potrzebna, aby sieć mogła uczyć się wzorców nieliniowych. Popularną funkcją aktywacji jest ReLU, czyli Rectified Linear Unit. Funkcja ta zwraca zero dla wszystkich wartości ujemnych.
Pozostałe funkcje aktywacji to:
- Liniowy po kawałku
- esicy
- Tanh
- Nieszczelny ReLU
Poniższy wykres pokazuje, dlaczego ReLU jest opisane w ten sposób: krzywa jest płaska przy zerze dla każdego ujemnego sygnału wejściowego, a następnie rośnie liniowo.
Najważniejszą decyzją, jaką należy podjąć podczas budowy sieci neuronowej, jest:
- Ile warstw w sieci neuronowej
- Ile ukrytych jednostek dla każdej warstwy
Sieci neuronowe z wieloma warstwami i ukrytymi jednostkami mogą nauczyć się złożonej reprezentacji danych, ale sprawiają, że obliczenia sieci są bardzo kosztowne.
Funkcja utraty
Po zdefiniowaniu warstw ukrytych i funkcji aktywacji należy określić funkcję straty i optymalizator.
W przypadku klasyfikacji binarnej powszechną praktyką jest stosowanie funkcji straty entropii krzyżowej binarnej. regresji liniowej, używasz średniego błędu kwadratowego.
Funkcja straty jest ważną metryką pozwalającą oszacować wydajność optymalizatora. Podczas szkolenia wskaźnik ten zostanie zminimalizowany. Należy dokładnie dobrać tę ilość w zależności od rodzaju problemu, z jakim się borykamy.
Optimizer
Funkcja straty jest miarą wydajności modelu. Optymalizator pomoże poprawić wagi sieci, aby zmniejszyć straty. Dostępne są różne optymalizatory, ale najpopularniejszym jest Stochastic Gradient Descent.
Konwencjonalne optymalizatory to:
- Momentum optymalizacja
- Przyspieszony gradient Nesterova
- Ada Grad
- Optymalizacja Adama
ArchiSama struktura nie gwarantuje użyteczności modelu.
Ograniczenia sieci neuronowej
Oto ograniczenia sieci neuronowej:
Przeładowanie
Częstym problemem w przypadku złożonych sieci neuronowych jest trudność w generalizacji na niewidziane wcześniej dane. Sieć neuronowa z wieloma wagami może bardzo dobrze identyfikować konkretne szczegóły w zbiorze uczącym, ale często prowadzi to do przeuczenia. Jeśli dane są niezrównoważone w grupach (tj. w niektórych grupach brakuje danych), sieć będzie się bardzo dobrze uczyć podczas treningu, ale nie będzie w stanie generalizować takich wzorców na dane, których wcześniej nie widziano.
Istnieje pewien kompromis uczenie maszynowe między optymalizacją a generalizacją.
- Optymalizacja modelu wymaga znalezienia najlepszych parametrów, które zminimalizują utratę zbioru treningowego.
- Uogólnienie mówi jednak, jak model zachowuje się w przypadku niewidocznych danych.
Aby zapobiec przechwytywaniu przez model określonych szczegółów lub niepożądanych wzorców danych treningowych, można zastosować różne techniki. Najlepszą metodą jest posiadanie zrównoważonego zbioru danych o wystarczającej ilości danych. Sztuka ograniczania nadmiernego dopasowania nazywa się regularyzacją. Poniższe trzy techniki to konwencjonalne punkty wyjścia.
| Technika | Co ogranicza | Typowe ustawienia w tym samouczku |
|---|---|---|
| Rozmiar sieci | Liczba warstw i ukrytych jednostek | Dwie ukryte warstwy, 300 i 100 jednostek |
| Regularyzacja wagi L1/L2 | Wielkość współczynników wagowych | l1_regularization_strength i l2_regularization_strength na poziomie 0.01 |
| Spadkowicz | Udział jednostek wyłączonych na każdym etapie szkolenia | porzucenie 0.3 |
Rozmiar sieci
Sieć neuronowa ze zbyt wieloma warstwami i ukrytymi jednostkami jest znana jako wysoce zaawansowana. Prostym sposobem na zmniejszenie złożoności modelu jest zmniejszenie jego rozmiaru. Nie ma jednej, najlepszej praktyki definiowania liczby warstw. Należy zacząć od niewielkiej liczby warstw i zwiększać ich rozmiar, aż model się przetrenuje.
Regularyzacja wagi
Standardową techniką zapobiegania przeuczeniu jest dodawanie ograniczeń do wag sieci. Ograniczenie wymusza, aby wagi sieci przyjmowały tylko małe wartości. Ograniczenie jest dodawane do funkcji straty błędu. Istnieją dwa rodzaje regularyzacji:
- L1 (Lasso): koszt jest proporcjonalny do wartości bezwzględnej współczynników wagowych.
- L2 (Grzbiet): koszt jest proporcjonalny do kwadratu wartości współczynników wagowych.
Spadkowicz
Dropout to dziwna, ale użyteczna technika. Sieć z dropoutem oznacza, że niektóre jednostki będą losowo wyłączane podczas etapu uczenia, więc ich sygnał wyjściowy staje się zerowy. Wyobraź sobie, że masz tablicę wag [0.1, 1.7, 0.7, -0.9]. Jeśli sieć neuronowa ma dropout, stanie się on [0.1, 0, 0, -0.9] z losowo rozłożonym 0. Parametrem kontrolującym dropout jest współczynnik dropoutu. Współczynnik ten definiuje liczbę wyłączonych jednostek. Częstotliwość wynosi od 0.2 do 0.5.
Mały interaktywny przykład ułatwia oglądanie pętli szkoleniowej.
Przykład sieci neuronowej w TensorFlow
Oto przykład działania sztucznej sieci neuronowej, pokazujący, jak działa ona w przypadku typowego problemu klasyfikacji. Istnieją dwa wejścia, x1 i x2, każde z losową wartością. Wyjściem jest klasa binarna. Celem jest klasyfikacja etykiety na podstawie dwóch cech. Aby zrealizować to zadanie, architektura sieci neuronowej jest zdefiniowana w następujący sposób:
- Dwie ukryte warstwy
- Pierwsza warstwa ma cztery w pełni połączone neurony
- Druga warstwa ma dwa w pełni połączone neurony
- Funkcja aktywacji to ReLU
- Dodaj regularyzację L2 z szybkością uczenia się 0.003
Sieć będzie optymalizować wagi przez 180 epok przy rozmiarze partii wynoszącym 10. W poniższej animacji przykładowej sieci neuronowej (ANN) można zobaczyć, jak wagi ewoluują w czasie i jak sieć ulepsza mapę klasyfikacji.ping.

Po pierwsze, sieć przypisuje wszystkim wagom losowe wartości.
- Przy losowych wagach, czyli bez optymalizacji, strata wyjściowa wynosi 0.453. Poniższy rysunek przedstawia sieć w różnych kolorach.
- Ogólnie rzecz biorąc, kolor pomarańczowy reprezentuje wartości ujemne, podczas gdy kolory niebieskie przedstawiają wartości dodatnie.
- Punkty danych mają tę samą reprezentację: niebieskie to etykiety dodatnie, a pomarańczowe – etykiety ujemne.

W drugiej ukrytej warstwie linie są pokolorowane zgodnie ze znakiem wagi. Linie pomarańczowe oznaczają wagę ujemną, a niebieskie wagę dodatnią.
Jak widać na mapie wyjściowejpingSieć popełnia sporo błędów. Spójrzmy teraz, jak zachowuje się sieć po optymalizacji.
Poniższy przykład sieci neuronowej (ANN) przedstawia wyniki zoptymalizowanej sieci. Przede wszystkim widać, że sieć pomyślnie nauczyła się klasyfikować punkty danych. Porównując to z poprzednim rysunkiem, początkowa waga wynosiła -0.43, a po optymalizacji waga wynosi -0.95.

Pomysł można uogólnić dla sieci z większą liczbą warstw ukrytych i neuronów. Możesz samodzielnie poeksperymentować z ustawieniami w Plac zabaw TensorFlow.
Poniższy opis przedstawia realizację tego samego pomysłu w kodzie na podstawie prawdziwego zbioru danych.
Jak trenować sieć neuronową za pomocą TensorFlow
Oto proces krok po kroku, jak trenować sieć neuronową za pomocą TensorFlow ANN wykorzystująca estymator API DNNClassifier.
Wykorzystamy zbiór danych MNIST do szkolenia Twojej pierwszej sieci neuronowej. Uczenie sieci neuronowej za pomocą TensorFlow Nie jest to bardzo skomplikowane. Krok wstępnego przetwarzania wygląda dokładnie tak samo, jak w poprzednich samouczkach. Postępujesz w następujący sposób:
- Importuj dane
- Przekształć dane
- Zbuduj tensor
- Zbuduj model
- Wytrenuj i oceń model
- Ulepsz model
Uwaga dotycząca wersji: Kod w tym przewodniku dotyczy interfejsu API estymatora TensorFlow 1.x. Ostateczna wersja pakietu tf-estimator została dostarczona z TensorFlow 2.15, a tf.estimator został usunięty w TensorFlow 2.16. Aby wykonać te kroki w aktualnej wersji, należy przypiąć TensorFlow 2.15 lub przebudować tę samą sieć dwuwarstwową za pomocą tf.keras.layers.Dense i model.fit().
Krok 1) Zaimportuj dane
Przede wszystkim musisz zaimportować potrzebną bibliotekę. Możesz zaimportować zbiór danych MNIST za pomocą nauka-scikit jak pokazano w poniższym przykładzie sieci neuronowej TensorFlow.
Zbiór danych MNIST jest najczęściej używanym zbiorem danych do testowania nowych technik lub algorytmów. Jest to zbiór obrazów o wymiarach 28×28 pikseli, z których każdy przedstawia ręcznie zapisaną cyfrę od 0 do 9. Zespół głębokich sieci splotowych, trenowanych z wykorzystaniem zniekształceń elastycznych, obniżył błąd testowania do 0.27%.
import numpy as np
import tensorflow as tf
np.random.seed(1337)
Oryginalny przewodnik pobrał pliki MNIST ręcznie i wskazał folder fetch_mldata.
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata(' /Users/Thomas/Dropbox/Learning/Upwork/tuto_TF/data/mldata/MNIST original')
print(mnist.data.shape)
print(mnist.target.shape)
Uwaga dotycząca API: Strona mldata.org nie jest już dostępna online, a fetch_mldata została usunięta w wersji 0.22 pakietu scikit-learn. W obecnej instalacji zastąp powyższe wywołanie funkcją fetch_openml('mnist_784', version=1), która pobiera te same 70 000 cyfr i udostępnia te same dane oraz atrybuty docelowe.
Następnie dzielisz dane i uzyskujesz kształt obu zbiorów danych.
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(mnist.data, mnist.target, test_size=0.2, random_state=42)
y_train  = y_train.astype(int)
y_test  = y_test.astype(int)
batch_size =len(X_train)

print(X_train.shape, y_train.shape,y_test.shape )
Krok 2) Przekształć dane
W poprzednim samouczku dowiedziałeś się, że musisz przekształcić dane, aby ograniczyć wpływ wartości odstających. W tym samouczku poświęconym sieciom neuronowym przekształcisz dane za pomocą skalera min-max. Wzór wygląda następująco:
(X-min_x)/(max_x - min_x)
scikit-learn ma już funkcję do tego celu: MinMaxScaler()
## resclae
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
# Train
X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
# test
X_test_scaled = scaler.fit_transform(X_test.astype(np.float64))
Krok 3) Skonstruuj tensor
Teraz znasz już sposób tworzenia tensory w TensorFlow. Możesz przekonwertować zestaw danych na kolumnę numeryczną.
feature_columns = [tf.feature_column.numeric_column('x', shape=X_train_scaled.shape[1:])]
Krok 4) Zbuduj model
Architektura sieci neuronowej zawiera 2 warstwy ukryte, z czego pierwsza ma 300 jednostek, a druga 100. Wartości te wynikają z doświadczenia, a nie ze wzoru. Można je dostroić i sprawdzić, jak wpływają na dokładność sieci.
Do zbudowania modelu należy użyć estymatora DNNClassifier. Należy ustawić liczbę klas na 10, ponieważ w zbiorze treningowym znajduje się ich dziesięć. Znasz już składnię obiektu estymatora. Argumenty feature_columns, n_classes i model_dir są dokładnie takie same jak w poprzednim samouczku. Argument hidden_units jest nowy: kontroluje on zarówno liczbę warstw, jak i liczbę węzłów, które każda warstwa łączy z siecią neuronową. W poniższym kodzie znajdują się dwie ukryte warstwy: pierwsza łącząca 300 węzłów, a druga 100 węzłów.
Aby zbudować estymator, użyj tf.estimator.DNNClassifier z następującymi parametrami:
- kolumny_funkcji: Zdefiniuj kolumny, które mają być używane w sieci
- ukryte_jednostki: Określ liczbę ukrytych neuronów
- n_klas: Zdefiniuj liczbę klas do przewidzenia
- katalog_modelu: Zdefiniuj ścieżkę Tensorboard
estimator = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    n_classes=10,
    model_dir = '/train/DNN')
Krok 5) Wytrenuj i oceń model
Do trenowania modelu i jego oceny można użyć funkcji wejściowej NumPy.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_train_scaled},
    y=y_train,
    batch_size=50,
    shuffle=False,
    num_epochs=None)
estimator.train(input_fn = train_input,steps=1000)
eval_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_test_scaled},
    y=y_test,
    shuffle=False,
    batch_size=X_test_scaled.shape[0],
    num_epochs=1)
estimator.evaluate(eval_input,steps=None)
Wyjście:
{'accuracy': 0.9637143,
 'average_loss': 0.12014342,
 'loss': 1682.0079,
 'global_step': 1000}
Obecna architektura zapewnia dokładność zestawu ewaluacyjnego na poziomie około 96 procent.
Krok 6) Ulepsz model
Można spróbować ulepszyć model dodając parametry regularyzacji.
W tym przypadku estymator wykorzystuje optymalizator Proximal AdaGrad ze współczynnikiem rezygnacji 0.3 i siłą L1 i L2 ustawioną na 0.01. W sieci neuronowej TensorFlow dostęp do optymalizatora uzyskuje się poprzez obiekt trenujący, po którym następuje nazwa optymalizatora. TensorFlow dostarcza wbudowane API dla optymalizatora Proximal AdaGrad.
Aby dodać regularyzację do głębokiej sieci neuronowej, możesz użyć tf.train.ProximalAdagradOptimizer z następującymi parametrami:
- Współczynnik uczenia się: wskaźnik_nauczenia
- Regularyzacja L1: l1_regulation_strength
- Regularyzacja L2: l2_regulation_strength
estimator_imp = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    dropout=0.3,
    n_classes = 10,
    optimizer=tf.train.ProximalAdagradOptimizer(
      learning_rate=0.01,
      l1_regularization_strength=0.01,
      l2_regularization_strength=0.01
    ),
    model_dir = '/train/DNN1')
estimator_imp.train(input_fn = train_input,steps=1000)
estimator_imp.evaluate(eval_input,steps=None)
Wyjście:
{'accuracy': 0.95057142,
 'average_loss': 0.17318928,
 'loss': 2424.6499,
 'global_step': 2000}
Wartości wybrane w celu zmniejszenia nadmiernego dopasowania nie poprawiły dokładności modelu. Twój pierwszy model miał dokładność 96%, podczas gdy model z regularyzatorem L2 ma dokładność 95%. Możesz wypróbować różne wartości i sprawdzić, jak wpływają one na dokładność.
