
Jądro Gaussa w uczeniu maszynowym: Python Metody jądra
 Zespół redakcyjny
⚡ Inteligentne podsumowanie
Metody jądra Gaussa sprawiają, że dane nieseparowalne stają się liniowo separowalne bez konieczności budowania wielowymiarowej mapy cech. Ten przewodnik pokazuje mapę wielomianową.ping ręcznie, a następnie trenuje losowy klasyfikator jądra Fouriera w TensorFlow.
Celem tego samouczka jest zapewnienie liniowej separacji zbioru danych. Tutorial jest podzielony na dwie części:
- Transformacja funkcji
- Szkolenie klasyfikatora jądra za pomocą TensorFlow
W pierwszej części zrozumiesz ideę stojącą za metodą jądra w uczeniu maszynowym, natomiast w drugiej części zobaczysz, jak trenować klasyfikator jądra za pomocą TensorFlowBędziesz korzystać z zestawu danych dla dorosłych. Celem tego zestawu danych jest klasyfikacja dochodów poniżej i powyżej 50 tys. dolarów, z uwzględnieniem zachowań każdego gospodarstwa domowego.
Dlaczego potrzebujesz metod jądra?
Celem każdego klasyfikatora jest prawidłowe przewidywanie klas. W tym celu zbiór danych powinien być separowalny. Spójrz na poniższy wykres; dość łatwo zauważyć, że wszystkie punkty powyżej czarnej linii należą do pierwszej klasy, a pozostałe punkty do drugiej. Jednak tak prosty zbiór danych jest niezwykle rzadki. W większości przypadków dane nie są separowalne, a dane, które nie są separowalne, utrudniają pracę prostym klasyfikatorom, takim jak regresja logistyczna.
import numpy as np
  import matplotlib.pyplot as plt
  from mpl_toolkits.mplot3d import Axes3D
  x_lin = np.array([1,2,3,4,5,6,7,8,9,10])
  y_lin = np.array([2,2,3,2,2,9,6,8,8,9])
  label_lin = np.array([0,0,0,0,0,1,1,1,1,1])

  fig = plt.figure()
  ax=fig.add_subplot(111)
  plt.scatter(x_lin, y_lin, c=label_lin, s=60)
  plt.plot([-2.5, 10], [12.5, -2.5], 'k-', lw=2)
  ax.set_xlim([-5,15])
  ax.set_ylim([-5,15])plt.show()

Na poniższym rysunku przedstawiamy zbiór danych, który nie jest liniowo rozdzielny. Jeśli narysujemy linię prostą, większość punktów nie zostanie zaklasyfikowana do właściwej klasy.
Jednym ze sposobów rozwiązania tego problemu jest pobranie zbioru danych i przekształcenie go w inną mapę cech. Oznacza to, że użyjesz funkcji, aby przenieść dane na inną płaszczyznę, która powinna być liniowo separowalna.
x = np.array([1,1,2,3,3,6,6,6,9,9,10,11,12,13,16,18])
y = np.array([18,13,9,6,15,11,6,3,5,2,10,5,6,1,3,1])
label = np.array([1,1,1,1,0,0,0,1,0,1,0,0,0,1,0,1])
fig = plt.figure()
plt.scatter(x, y, c=label, s=60)
plt.show()
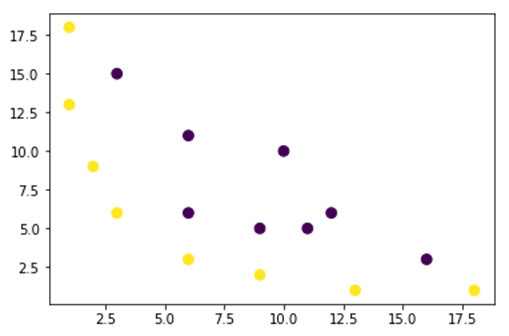
Dane z powyższego rysunku znajdują się na płaszczyźnie 2D i nie są rozdzielne. Możesz spróbować przekształcić te dane do postaci trójwymiarowej, co oznacza utworzenie rysunku z 3 osiami.
W naszym przykładzie jądra Gaussa zastosujemy mapę wielomianowąping Aby przenieść nasze dane do trzeciego wymiaru, wzór na transformację danych jest następujący.

Definiujesz funkcję w jądrze Gaussa Python aby utworzyć nowe mapy obiektów.
Możesz użyć numpy Aby zakodować powyższy wzór. Każdy wiersz poniżej paruje jeden wyraz mapyping z wyrażeniem tablicowym, które je generuje, a mały obraz oznacza pierwiastek kwadratowy z dwóch czynników.
| Formuła | Odpowiedni kod NumPy |
|---|---|
| x | x[:,0] |
| y | x[:,1] |
| x² | x[:,0]**2 |
 |
np.sqrt(2)* |
| xy | x[:,0]*x[:,1] |
| y² | x[:,1]**2 |
### illustration purpose
def mapping(x, y):
	x = np.c_[(x, y)]
    if len(x) >	2:
    	x_1 = x[:,0]**2
        x_2 = np.sqrt(2)*x[:,0]*x[:,1]
        x_3 = x[:,1]**2
    else:
    	x_1 = x[0]**2
        x_2 = np.sqrt(2)*x[0]*x[1]
        x_3 = x[1]**2
   trans_x = np.array([x_1, x_2, x_3])
   return trans_x
Nowa mapaping ma 3 wymiary i 16 punktów.
x_1  = mapping(x, y)
x_1.shape
(3, 16)
Teraz utwórz nowy wykres z 3 osiami x, y i z.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[2], c=label, s=60)
ax.view_init(30, 185)ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')
plt.show()

Widzimy poprawę, ale jeśli zmienimy orientację wykresu, stanie się jasne, że zbiór danych jest teraz rozdzielny.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[1], c=label, s=60)
ax.view_init(0, -180)ax.set_ylim([150,-50])
ax.set_zlim([-10000,10000])
ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')plt.show()

Jeśli musisz manipulować dużym zbiorem danych i tworzyć więcej niż dwa wymiary, powyższa metoda napotka duży problem. W rzeczywistości musisz przekształcić wszystkie punkty danych, co jest ewidentnie nieopłacalne. Zajmie Ci to wieki, a na komputerze może zabraknąć pamięci.
Najczęstszym sposobem obejścia tego problemu jest użycie jądra.
Czym jest jądro w uczeniu maszynowym?
Pomysł polega na wykorzystaniu przestrzeni cech o wyższym wymiarze, aby dane były niemal liniowo rozdzielne, jak pokazano na powyższym rysunku.
Istnieje wiele przestrzeni o wyższych wymiarach, które sprawiają, że punkty danych są separowalne. Na przykład pokazaliśmy, że mapa wielomianowaping to świetny początek.
Wykazaliśmy również, że w przypadku dużej ilości danych te transformacje nie są wydajne. Zamiast tego można użyć funkcji jądra w uczeniu maszynowym, aby zmodyfikować dane bez przechodzenia na nową płaszczyznę cech.
Magia jądra polega na znalezieniu funkcji, która unika wszystkich problemów związanych z obliczeniami wielowymiarowymi. Wynikiem jądra jest skalar, czyli, mówiąc inaczej, wracamy do przestrzeni jednowymiarowej.
Po znalezieniu tej funkcji można ją podstawić do standardowego klasyfikatora liniowego.
Oto przykład, który urzeczywistnia koncepcję Kernel Machine Learning. Mamy dwa wektory, x1 i x2. Celem jest utworzenie wyższego wymiaru za pomocą mapy wielomianowej.pingWynik jest równy iloczynowi skalarnemu nowej mapy cech. Korzystając z powyższej metody, należy:
- Przekształć x1 i x2 w nowy wymiar
- Oblicz iloczyn skalarny: wspólny dla wszystkich jąder
Przekształć x1 i x2 w nowy wymiar
Możesz użyć funkcji utworzonej powyżej, aby obliczyć wyższy wymiar.
## Kernel
x1 = np.array([3,6])
x2 = np.array([10,10])

x_1 = mapping(x1, x2)
print(x_1)
Wydajność
[[  9.         100.        ]
      [ 25.45584412 141.42135624]
      [ 36.         100.        ]]
Oblicz iloczyn skalarny
Możesz użyć kropki obiektu z numpy aby obliczyć iloczyn skalarny pierwszego i drugiego wektora zapisanego w x_1.
print(np.dot(x_1[:,0], x_1[:,1]))
8100.0
Wynik to 8100. Widzisz problem: musisz zapisać w pamięci nową mapę cech, aby obliczyć iloczyn skalarny. Jeśli masz zbiór danych z milionami rekordów, jest to obliczeniowo nieefektywne.
Zamiast tego można użyć jądra wielomianu do obliczenia iloczynu skalarnego bez transformacji wektora. Ta funkcja oblicza iloczyn skalarny x1 i x2 tak, jakby te dwa wektory zostały przekształcone do wyższego wymiaru. Innymi słowy, funkcja jądra oblicza wynik iloczynu skalarnego z innej przestrzeni cech.
Możesz napisać funkcję jądra wielomianu w Python następująco.
def polynomial_kernel(x, y, p=2):
	return (np.dot(x, y)) ** p
Jest to potęga iloczynu skalarnego dwóch wektorów. Poniżej zwracasz drugi stopień jądra wielomianu. Dane wyjściowe są takie same jak w przypadku drugiej metody. Na tym polega magia jądra.
polynomial_kernel(x1, x2, p=2)
8100
Rodzaje metod jądra
Dostępnych jest wiele różnych technik jądra. Najprostszym jest jądro liniowe. Ta funkcja sprawdza się całkiem dobrze w klasyfikacji tekstu. Pozostałe jądra to:
- Jądro wielomianowe
- Jądro Gaussa
Poniższa tabela podsumowuje, co każda z nich robi i kiedy praktycy po nią sięgają.
| Jądro | Co oblicza | Typowe zastosowanie |
|---|---|---|
| Liniowy | Prosty iloczyn skalarny w oryginalnej przestrzeni cech | Już teraz możliwe do oddzielenia funkcje danych i tekstu wielowymiarowego |
| Wielomian | Iloczyn skalarny podniesiony do stopnia p, ukazujący interakcje cech | Zakrzywione granice, gdy wiadomo, że interakcje mają znaczenie |
| Gaussa (RBF) | Podobieństwo oparte na odległości, które spada do zera w miarę oddalania się punktów | Zwykle pierwszy wybór, gdy kształt granicy jest nieznany |
W przykładzie z TensorFlow wykorzystamy losowe cechy Fouriera. TensorFlow posiada wbudowany estymator do obliczania nowej przestrzeni cech. Maper losowych cech Fouriera jest aproksymacją funkcji jądra Gaussa pokazanej poniżej.

Funkcja filtrowania Gaussa oblicza podobieństwo między punktami danych w przestrzeni o znacznie wyższych wymiarach.
Po przedstawieniu teorii przejdziemy do dalszej części przewodnika, w której jądro Gaussa zostanie wykorzystane w rzeczywistym zestawie danych.
Trenuj klasyfikator jądra Gaussa za pomocą TensorFlow
Celem algorytmu jest klasyfikacja gospodarstwa domowego zarabiającego powyżej 50 tys.
Najpierw przeprowadzisz ocenę regresji logistycznej, aby uzyskać model porównawczy. Następnie wytrenujesz klasyfikator jądra, aby sprawdzić, czy można uzyskać lepsze wyniki.
Używasz następujących zmiennych ze zbioru danych dla dorosłych:
- wiek
- klasa pracy
- fnlwgt
- Edukacja
- edukacja_num
- małżeński
- zawód
- związek
- wyścig
- seks
- zysk kapitałowy
- strata_kapitału
- godziny_tydzień
- ojczyźnie
- etykieta
Przed rozpoczęciem trenowania i oceny modelu należy wykonać następujące czynności:
- Importuj biblioteki
- Importuj dane
- Przygotuj dane
- Zbuduj model logistyczny: model bazowy
- Oceń model
- Zbuduj i oceń klasyfikator jądra
Uwaga dotycząca wersji: Każdy poniższy fragment kodu dotyczy TensorFlow 1.x. Przestrzeń nazw tf.contrib, która dostarcza real_valued_column, RandomFourierFeatureMapper i KernelLinearClassifier, została usunięta w TensorFlow 2.0, a sam tf.estimator został usunięty w TensorFlow 2.16. W obecnej wersji zbuduj ten sam potok z warstwą tf.keras.layers.experimental.RandomFourierFeatures, a następnie warstwą wyjściową Dense lub z parą RBFSampler i SGDClassifier z biblioteki scikit-learn.
Krok 1) Zaimportuj biblioteki
Aby importować i trenować modele jądra w Artificial Intelligence, musisz zaimportować TensorFlow, pandy i NumPy.
#import numpy as np
from sklearn.model_selection
import train_test_split
import tensorflow as tf
import pandas as pd
import numpy as np
Krok 2) Zaimportuj dane
Pobierasz dane z Strona zbioru danych dla dorosłych UCI i zaimportuj go jako pandas DataFrame.
## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country', 'label']
PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"
PATH_test ="https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.test
"## Import
df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_test = pd.read_csv(PATH_test,skiprows = 1, skipinitialspace=True, names = COLUMNS, index_col=False)
Teraz, gdy zestaw treningowy i testowy są zdefiniowane, możesz zmienić etykietę kolumny z ciągu na liczbę całkowitą. TensorFlow nie akceptuje wartości ciągu dla etykiety.
label = {'<=50K': 0,'>50K': 1}
df_train.label = [label[item] for item in df_train.label]
label_t = {'<=50K.': 0,'>50K.': 1}
df_test.label = [label_t[item] for item in df_test.label]
df_train.shape
(32561, 15)
Krok 3) Przygotuj dane
Zbiór danych zawiera zarówno cechy ciągłe, jak i kategoryczne. Dobrą praktyką jest standaryzacja wartości zmiennych ciągłych. Można użyć funkcji StandardScaler z nauka-scikitTworzysz również funkcję zdefiniowaną przez użytkownika, aby ułatwić konwersję zbioru treningowego i testowego. Pamiętaj, aby połączyć zmienne ciągłe i kategoryczne we wspólny zbiór danych, a tablica powinna być typu float32.
COLUMNS_INT = ['age','fnlwgt','education_num','capital_gain', 'capital_loss', 'hours_week']
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']
from sklearn.preprocessing import StandardScaler
from sklearn import preprocessing

def prep_data_str(df):
	scaler = StandardScaler()
    le = preprocessing.LabelEncoder()
    df_toscale = df[COLUMNS_INT]
    df_scaled = scaler.fit_transform(df_toscale.astype(np.float64))
    X_1 = df[CATE_FEATURES].apply(le.fit_transform)
    y = df['label'].astype(np.int32)
    X_conc = np.c_[df_scaled, X_1].astype(np.float32)
    return X_conc, y
Funkcja transformatora jest gotowa, więc możesz przekonwertować zbiór danych i utworzyć funkcję input_fn.
X_train, y_train = prep_data_str(df_train)
X_test, y_test = prep_data_str(df_test)
print(X_train.shape)
(32561, 14)
W następnym kroku będziesz trenować regresję logistyczną. Zapewni to podstawową dokładność. Celem jest pokonanie linii bazowej za pomocą innego algorytmu, a mianowicie klasyfikatora jądra.
Krok 4) Skonstruuj model logistyczny: Model bazowy
Konstruujesz kolumnę cech za pomocą obiektu real_valued_column. Dzięki temu wszystkie zmienne będą gęstymi danymi liczbowymi.
feat_column = tf.contrib.layers.real_valued_column('features', dimension=14)
Estymator definiuje się za pomocą interfejsu API TensorFlow Estimator; należy podać kolumny cech i wskazać miejsce zapisania wykresu.
estimator = tf.estimator.LinearClassifier(feature_columns=[feat_column],
                                          n_classes=2,
                                          model_dir = "kernel_log"
                                         )
INFO:tensorflow:Using default config.INFO:tensorflow:Using config: {'_model_dir': 'kernel_log', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a2003f780>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Będziesz trenować regresję logistyczną, używając mini-partii o rozmiarze 200.
# Train the model
train_input_fn = tf.estimator.inputs.numpy_input_fn(
	x={"features": X_train},
    y=y_train,
    batch_size=200,
    num_epochs=None,
    shuffle=True)
Można trenować model za pomocą 1,000 iteracji.
estimator.train(input_fn=train_input_fn, steps=1000)
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into kernel_log/model.ckpt.
INFO:tensorflow:loss = 138.62949, step = 1
INFO:tensorflow:global_step/sec: 324.16
INFO:tensorflow:loss = 87.16762, step = 101 (0.310 sec)
INFO:tensorflow:global_step/sec: 267.092
INFO:tensorflow:loss = 71.53657, step = 201 (0.376 sec)
INFO:tensorflow:global_step/sec: 292.679
INFO:tensorflow:loss = 69.56703, step = 301 (0.340 sec)
INFO:tensorflow:global_step/sec: 225.582
INFO:tensorflow:loss = 74.615875, step = 401 (0.445 sec)
INFO:tensorflow:global_step/sec: 209.975
INFO:tensorflow:loss = 76.49044, step = 501 (0.475 sec)
INFO:tensorflow:global_step/sec: 241.648
INFO:tensorflow:loss = 66.38373, step = 601 (0.419 sec)
INFO:tensorflow:global_step/sec: 305.193
INFO:tensorflow:loss = 87.93341, step = 701 (0.327 sec)
INFO:tensorflow:global_step/sec: 396.295
INFO:tensorflow:loss = 76.61518, step = 801 (0.249 sec)
INFO:tensorflow:global_step/sec: 359.857
INFO:tensorflow:loss = 78.54885, step = 901 (0.277 sec)
INFO:tensorflow:Saving checkpoints for 1000 into kernel_log/model.ckpt.
INFO:tensorflow:Loss for final step: 67.79706.


<tensorflow.python.estimator.canned.linear.LinearClassifier at 0x1a1fa3cbe0>
Krok 5) Oceń model
Definiujesz funkcję wejściową NumPy, aby ocenić model. Do oceny używasz całego zestawu testowego.
# Evaluation
test_input_fn = tf.estimator.inputs.numpy_input_fn(
    x={"features": X_test},
    y=y_test,
    batch_size=16281,
    num_epochs=1,
    shuffle=False)
estimator.evaluate(input_fn=test_input_fn, steps=1)
INFO:tensorflow:Calling model_fn.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:22
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from kernel_log/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Evaluation [1/1]
INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:23
INFO:tensorflow:Saving dict for global step 1000: accuracy = 0.82353663, accuracy_baseline = 0.76377374, auc = 0.84898686, auc_precision_recall = 0.67214864, average_loss = 0.3877216, global_step = 1000, label/mean = 0.23622628, loss = 6312.495, precision = 0.7362797, prediction/mean = 0.21208474, recall = 0.39417577
{'accuracy': 0.82353663,
 'accuracy_baseline': 0.76377374,
 'auc': 0.84898686,
 'auc_precision_recall': 0.67214864,
 'average_loss': 0.3877216,
 'global_step': 1000,
 'label/mean': 0.23622628,
 'loss': 6312.495,
 'precision': 0.7362797,
 'prediction/mean': 0.21208474,
 'recall': 0.39417577}
Osiągnąłeś dokładność 82%. W następnej sekcji spróbujesz pokonać klasyfikator logistyczny za pomocą klasyfikatora jądra.
Krok 6) Skonstruuj klasyfikator jądra
Estymator jądra nie różni się aż tak bardzo od tradycyjnego klasyfikatora liniowego, przynajmniej pod względem konstrukcji. Jego ideą jest połączenie mocy jawnej mapy jądra.ping z klasyfikatorem liniowym.
Aby wytrenować klasyfikator jądra, potrzebujesz dwóch predefiniowanych estymatorów dostępnych w TensorFlow:
- RandomFourierFeatureMapper
- Klasyfikator liniowy jądra
W pierwszej sekcji dowiedziałeś się, że musisz przekształcić wymiar niski w wymiar wysoki za pomocą funkcji jądra. Dokładniej, użyjesz losowych funkcji Fouriera, które aproksymują funkcję Gaussa. TensorFlow 1.x dostarcza tę mapę.ping jako RandomFourierFeatureMapper, a model można trenować przy użyciu estymatora KernelLinearClassifier.
Aby zbudować model, wykonaj następujące kroki:
- Ustaw funkcję jądra o dużym wymiarze
- Ustaw hiperparametr L2
- Zbuduj model
- Trenuj model
- Oceń model
Krok A) Ustaw funkcję jądra o wysokim wymiarze
Obecny zbiór danych zawiera 14 cech, które zostaną przekształcone w nowy, 5,000-wymiarowy wektor. Do przeprowadzenia transformacji wykorzystasz losowe cechy Fouriera. Jeśli przypomnisz sobie wzór jądra Gaussa, zauważysz, że istnieje parametr odchylenia standardowego, który należy zdefiniować. Parametr ten kontroluje miarę podobieństwa używaną podczas klasyfikacji: małe odchylenie standardowe sprawia, że jądro traktuje tylko bardzo bliskie punkty jako podobne, podczas gdy duże wygładza granicę decyzyjną.
Możesz dostroić wszystkie parametry w RandomFourierFeatureMapper za pomocą:
- wymiar_wejściowy = 14
- wymiary_wyjściowe = 5000
- odchylenie standardowe = 4
### Prep Kernel
kernel_mapper = tf.contrib.kernel_methods.RandomFourierFeatureMapper(input_dim=14, output_dim=5000, stddev=4, name='rffm')
Musisz skonstruować narzędzie mapujące jądro, korzystając z utworzonych wcześniej kolumn funkcji: feat_column
### Map Kernel
kernel_mappers = {feat_column: [kernel_mapper]}
Krok B) Ustaw hiperparametr L2
Aby zapobiec nadmiernemu dopasowaniu, nakładasz karę na funkcję straty za pomocą regularyzatora L2. Ustawiasz hiperparametr L2 na 0.1, a współczynnik uczenia na 5.
optimizer = tf.train.FtrlOptimizer(learning_rate=5, l2_regularization_strength=0.1)
Krok C) Zbuduj model
Następny krok jest podobny do klasyfikacji liniowej. Używasz wbudowanego estymatora KernelLinearClassifier. Pamiętaj, aby dodać wcześniej zdefiniowany maper jądra i zmienić katalog modelu.
### Prep estimator
estimator_kernel = tf.contrib.kernel_methods.KernelLinearClassifier(
    n_classes=2,
    optimizer=optimizer,
    kernel_mappers=kernel_mappers,
    model_dir="kernel_train")
Poniższe ostrzeżenia dotyczące wycofania są spodziewane w TensorFlow 1.x, ponieważ moduł kernel_methods został zbudowany na starszych estymatorach tf.contrib.learn.
WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/kernel_methods/python/kernel_estimators.py:305: multi_class_head (from tensorflow.contrib.learn.python.learn.estimators.head) is deprecated and will be removed in a future version. Instructions for updating: Please switch to tf.contrib.estimator.*_head. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:1179: BaseEstimator.__init__ (from tensorflow.contrib.learn.python.learn.estimators.estimator) is deprecated and will be removed in a future version. Instructions for updating: Please replace uses of any Estimator from tf.contrib.learn with an Estimator from tf.estimator.* WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:427: RunConfig.__init__ (from tensorflow.contrib.learn.python.learn.estimators.run_config) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.RunConfig instead. INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_task_type': None, '_task_id': 0, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a200ae550>, '_master': '', '_num_ps_replicas': 0, '_num_worker_replicas': 0, '_environment': 'local', '_is_chief': True, '_evaluation_master': '', '_train_distribute': None, '_tf_config': gpu_options { per_process_gpu_memory_fraction: 1.0 } , '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_secs': 600, '_log_step_count_steps': 100, '_session_config': None, '_save_checkpoints_steps': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_model_dir': 'kernel_train'}
Krok D) Szkolenie modelu
Teraz, gdy klasyfikator jądra jest już zbudowany, możesz rozpocząć jego trenowanie. Wybierasz iterację modelu 2,000 razy.
### estimate
estimator_kernel.fit(input_fn=train_input_fn, steps=2000)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/head.py:678: ModelFnOps.__new__ (from tensorflow.contrib.learn.python.learn.estimators.model_fn) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.EstimatorSpec. You can use the `estimator_spec` method to create an equivalent one. INFO:tensorflow:Create CheckpointSaverHook. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Saving checkpoints for 1 into kernel_train/model.ckpt. INFO:tensorflow:loss = 0.6931474, step = 1 INFO:tensorflow:global_step/sec: 86.6365 INFO:tensorflow:loss = 0.39374447, step = 101 (1.155 sec) INFO:tensorflow:global_step/sec: 80.1986 INFO:tensorflow:loss = 0.3797774, step = 201 (1.247 sec) INFO:tensorflow:global_step/sec: 79.6376 INFO:tensorflow:loss = 0.3908726, step = 301 (1.256 sec) INFO:tensorflow:global_step/sec: 95.8442 INFO:tensorflow:loss = 0.41890752, step = 401 (1.043 sec) INFO:tensorflow:global_step/sec: 93.7799 INFO:tensorflow:loss = 0.35700393, step = 501 (1.066 sec) INFO:tensorflow:global_step/sec: 94.7071 INFO:tensorflow:loss = 0.35535482, step = 601 (1.056 sec) INFO:tensorflow:global_step/sec: 90.7402 INFO:tensorflow:loss = 0.3692882, step = 701 (1.102 sec) INFO:tensorflow:global_step/sec: 94.4924 INFO:tensorflow:loss = 0.34746957, step = 801 (1.058 sec) INFO:tensorflow:global_step/sec: 95.3472 INFO:tensorflow:loss = 0.33655524, step = 901 (1.049 sec) INFO:tensorflow:global_step/sec: 97.2928 INFO:tensorflow:loss = 0.35966292, step = 1001 (1.028 sec) INFO:tensorflow:global_step/sec: 85.6761 INFO:tensorflow:loss = 0.31254214, step = 1101 (1.167 sec) INFO:tensorflow:global_step/sec: 91.4194 INFO:tensorflow:loss = 0.33247527, step = 1201 (1.094 sec) INFO:tensorflow:global_step/sec: 82.5954 INFO:tensorflow:loss = 0.29305756, step = 1301 (1.211 sec) INFO:tensorflow:global_step/sec: 89.8748 INFO:tensorflow:loss = 0.37943482, step = 1401 (1.113 sec) INFO:tensorflow:global_step/sec: 76.9761 INFO:tensorflow:loss = 0.34204718, step = 1501 (1.300 sec) INFO:tensorflow:global_step/sec: 73.7192 INFO:tensorflow:loss = 0.34614792, step = 1601 (1.356 sec) INFO:tensorflow:global_step/sec: 83.0573 INFO:tensorflow:loss = 0.38911164, step = 1701 (1.204 sec) INFO:tensorflow:global_step/sec: 71.7029 INFO:tensorflow:loss = 0.35255936, step = 1801 (1.394 sec) INFO:tensorflow:global_step/sec: 73.2663 INFO:tensorflow:loss = 0.31130585, step = 1901 (1.365 sec) INFO:tensorflow:Saving checkpoints for 2000 into kernel_train/model.ckpt. INFO:tensorflow:Loss for final step: 0.37795097. KernelLinearClassifier(params={'head': <tensorflow.contrib.learn.python.learn.estimators.head._BinaryLogisticHead object at 0x1a2054cd30>, 'feature_columns': {_RealValuedColumn(column_name='features_MAPPED', dimension=5000, default_value=None, dtype=tf.float32, normalizer=None)}, 'optimizer': <tensorflow.python.training.ftrl.FtrlOptimizer object at 0x1a200aec18>, 'kernel_mappers': {_RealValuedColumn(column_name='features', dimension=14, default_value=None, dtype=tf.float32, normalizer=None): [<tensorflow.contrib.kernel_methods.python.mappers.random_fourier_features.RandomFourierFeatureMapper object at 0x1a200ae400>]}})
Krok E) Oceń model
Na koniec oceniasz wydajność swojego modelu. Powinieneś być w stanie pokonać regresję logistyczną.
# Evaluate and report metrics.
eval_metrics = estimator_kernel.evaluate(input_fn=test_input_fn, steps=1)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:50 INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from kernel_train/model.ckpt-2000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Evaluation [1/1] INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:51 INFO:tensorflow:Saving dict for global step 2000: accuracy = 0.83975184, accuracy/baseline_label_mean = 0.23622628, accuracy/threshold_0.500000_mean = 0.83975184, auc = 0.8904007, auc_precision_recall = 0.72722375, global_step = 2000, labels/actual_label_mean = 0.23622628, labels/prediction_mean = 0.23786618, loss = 0.34277728, precision/positive_threshold_0.500000_mean = 0.73001117, recall/positive_threshold_0.500000_mean = 0.5104004
Ostateczna dokładność wynosi 84%, czyli około 1.6 punktu procentowego powyżej wartości bazowej regresji logistycznej (0.83975184 w porównaniu z 0.82353663). Istnieje kompromis między poprawą dokładności a kosztami obliczeniowymi. Należy zastanowić się, czy ta poprawa jest warta czasu poświęconego na cięższy klasyfikator i czy ma ona istotny wpływ na Twoją firmę.
