
Seq2seq (Sequence to Sequence) model met PyTorch
 Evelien Clarke
⚡ Slimme samenvatting
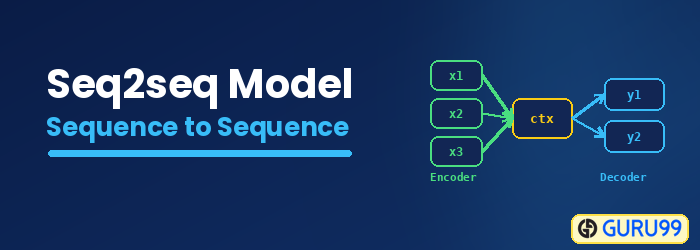
Seq2Seq is een encoder-decoder-architectuur die een invoersequentie omzet in een uitvoersequentie met behulp van twee terugkerende neurale netwerken. Deze architectuur maakt machinale vertaling en andere taken op het gebied van natuurlijke taalverwerking mogelijk waarbij de lengte van de invoer en de uitvoer verschillen.
Wat is NLP?
NLP, oftewel Natural Language Processing, is een van de populaire takken van kunstmatige intelligentie die computers helpt om mensen in hun eigen taal te begrijpen, te manipuleren of op hen te reageren. NLP is de motor achter Google Translate dat ons helpt andere talen te begrijpen.
Wat is Seq2Seq?
Seq2Seq is een methode van op een encoder-decoder gebaseerde machinevertaling en taalverwerking die een invoer van een reeks toewijst aan een uitvoer van een reeks met een tag en attentiewaarde. Het idee is om twee RNN's te gebruiken die samenwerken met een speciaal token en proberen de volgende toestandsreeks uit de vorige reeks te voorspellen.
Hoe u een reeks kunt voorspellen op basis van de vorige reeks
Hieronder volgen de stappen om met Py een reeks te voorspellen op basis van de voorgaande reeks.Torch.
Stap 1) Onze gegevens laden
Voor onze dataset gebruikt u een dataset van Door tabs gescheiden tweetalige zinsparen. Hier zal ik de Engels-Indonesische dataset gebruiken. U kunt alles kiezen wat u maar wilt, maar vergeet niet de bestandsnaam en map in de code te wijzigen.
from __future__ import unicode_literals, print_function, division
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F

import numpy as np
import pandas as pd

import os
import re
import random

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
Stap 2) Gegevensvoorbereiding
Je kunt de dataset niet direct gebruiken. Je moet de zinnen opsplitsen in woorden en deze omzetten naar een One-Hot Vector. Elk woord wordt uniek geïndexeerd in de Lang-klasse om een woordenboek te maken. De Lang-klasse slaat elke zin op en splitst deze woord voor woord met behulp van addSentence. Vervolgens wordt een woordenboek gemaakt door elk onbekend woord te indexeren voor Sequence-to-Sequence-modellen.
SOS_token = 0
EOS_token = 1
MAX_LENGTH = 20

#initialize Lang Class
class Lang:
   def __init__(self):
       #initialize containers to hold the words and corresponding index
       self.word2index = {}
       self.word2count = {}
       self.index2word = {0: "SOS", 1: "EOS"}
       self.n_words = 2  # Count SOS and EOS

#split a sentence into words and add it to the container
   def addSentence(self, sentence):
       for word in sentence.split(' '):
           self.addWord(word)

#If the word is not in the container, the word will be added to it, else, update the word counter
   def addWord(self, word):
       if word not in self.word2index:
           self.word2index[word] = self.n_words
           self.word2count[word] = 1
           self.index2word[self.n_words] = word
           self.n_words += 1
       else:
           self.word2count[word] += 1
De klasse Lang helpt ons bij het maken van een woordenboek. Voor elke taal wordt elke zin opgesplitst in woorden en vervolgens toegevoegd aan de container. Elke container slaat de woorden op in de juiste index, telt het woord en telt de index van het woord erbij op, zodat we die index kunnen gebruiken om de index van een woord te vinden of een woord te vinden aan de hand van de index.
Omdat onze gegevens gescheiden zijn door TAB, moet u gebruik maken van panda's Pandas gebruikt dit als data loader. Pandas leest onze data als een DataFrame en splitst deze in een bronzin en een doelzin. Elke zin wordt vervolgens genormaliseerd naar kleine letters, alle niet-tekens worden verwijderd, de tekst wordt van Unicode naar ASCII geconverteerd en de zinnen worden gesplitst zodat elk woord afzonderlijk wordt weergegeven.
#Normalize every sentence
def normalize_sentence(df, lang):
   sentence = df[lang].str.lower()
   sentence = sentence.str.replace('[^A-Za-z\s]+', '')
   sentence = sentence.str.normalize('NFD')
   sentence = sentence.str.encode('ascii', errors='ignore').str.decode('utf-8')
   return sentence

def read_sentence(df, lang1, lang2):
   sentence1 = normalize_sentence(df, lang1)
   sentence2 = normalize_sentence(df, lang2)
   return sentence1, sentence2

def read_file(loc, lang1, lang2):
   df = pd.read_csv(loc, delimiter='\t', header=None, names=[lang1, lang2])
   return df

def process_data(lang1,lang2):
   df = read_file('text/%s-%s.txt' % (lang1, lang2), lang1, lang2)
   print("Read %s sentence pairs" % len(df))
   sentence1, sentence2 = read_sentence(df, lang1, lang2)

   source = Lang()
   target = Lang()
   pairs = []
   for i in range(len(df)):
       if len(sentence1[i].split(' ')) < MAX_LENGTH and len(sentence2[i].split(' ')) < MAX_LENGTH:
           full = [sentence1[i], sentence2[i]]
           source.addSentence(sentence1[i])
           target.addSentence(sentence2[i])
           pairs.append(full)

   return source, target, pairs
Een andere nuttige functie die je zult gebruiken, is het omzetten van paren naar tensors. Dit is erg belangrijk omdat ons netwerk alleen data van het tensortype leest. Het is ook belangrijk omdat hier, aan het einde van elke zin, een token wordt toegevoegd om het netwerk te laten weten dat de invoer is voltooid. Voor elk woord in de zin wordt de index van het juiste woord in het woordenboek opgehaald en wordt een token aan het einde van de zin toegevoegd.
def indexesFromSentence(lang, sentence):
   return [lang.word2index[word] for word in sentence.split(' ')]

def tensorFromSentence(lang, sentence):
   indexes = indexesFromSentence(lang, sentence)
   indexes.append(EOS_token)
   return torch.tensor(indexes, dtype=torch.long, device=device).view(-1, 1)

def tensorsFromPair(input_lang, output_lang, pair):
   input_tensor = tensorFromSentence(input_lang, pair[0])
   target_tensor = tensorFromSentence(output_lang, pair[1])
   return (input_tensor, target_tensor)
Seq2Seq-model

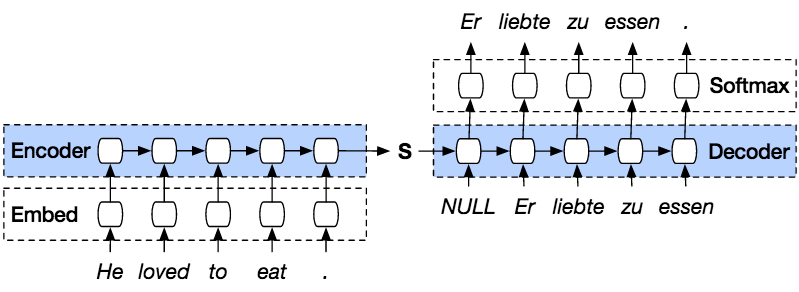
PyTorHet Seq2seq-model is een type model dat gebruikmaakt van Py.TorBovenop het model bevindt zich een encoder-decoder. De encoder codeert de zin woord voor woord in een index van woordenschat of bekende woorden met een index, en de decoder voorspelt de uitvoer van de gecodeerde invoer door de invoer sequentieel te decoderen en probeert, indien mogelijk, de laatst ingevoerde invoer als volgende invoer te gebruiken. Met deze methode is het ook mogelijk om de volgende invoer te voorspellen om een zin te creëren. Aan elke zin wordt een token toegekend om het einde van de sequentie aan te geven. Aan het einde van de voorspelling is er ook een token om het einde van de uitvoer aan te geven. De encoder geeft dus een toestand door aan de decoder om de uitvoer te voorspellen.

De encoder codeert onze invoerzin woord voor woord in volgorde, en aan het einde zal er een token zijn om het einde van een zin aan te geven. De encoder bestaat uit een embeddinglaag en een GRU-laag. De embeddinglaag is een opzoektabel die de embedding van onze invoer opslaat in een woordenboek met een vaste grootte. Deze wordt doorgegeven aan een GRU-laag. De GRU-laag is een gated recurrent unit die bestaat uit een meerlaagse structuur. RNN waarmee de opeenvolgende invoer wordt berekend. Deze laag berekent de verborgen status van de vorige en werkt de reset-, update- en nieuwe poorten bij.

De decoder decodeert de invoer van de encoderuitvoer. Hij probeert de volgende uitvoer te voorspellen en deze, indien mogelijk, als volgende invoer te gebruiken. De decoder bestaat uit een embeddinglaag, een GRU-laag en een lineaire laag. De embeddinglaag maakt een opzoektabel voor de uitvoer en geeft deze door aan een GRU-laag om de voorspelde uitvoertoestand te berekenen. Vervolgens helpt een lineaire laag bij het berekenen van de activeringsfunctie om de werkelijke waarde van de voorspelde uitvoer te bepalen.
class Encoder(nn.Module):
   def __init__(self, input_dim, hidden_dim, embbed_dim, num_layers):
       super(Encoder, self).__init__()

       #set the encoder input dimesion , embbed dimesion, hidden dimesion, and number of layers
       self.input_dim = input_dim
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.num_layers = num_layers

       #initialize the embedding layer with input and embbed dimention
       self.embedding = nn.Embedding(input_dim, self.embbed_dim)
       #intialize the GRU to take the input dimetion of embbed, and output dimention of hidden and
       #set the number of gru layers
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)

   def forward(self, src):
       embedded = self.embedding(src).view(1,1,-1)
       outputs, hidden = self.gru(embedded)
       return outputs, hidden

class Decoder(nn.Module):
   def __init__(self, output_dim, hidden_dim, embbed_dim, num_layers):
       super(Decoder, self).__init__()

#set the encoder output dimension, embed dimension, hidden dimension, and number of layers
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.output_dim = output_dim
       self.num_layers = num_layers

# initialize every layer with the appropriate dimension. For the decoder layer, it will consist of an embedding, GRU, a Linear layer and a Log softmax activation function.
       self.embedding = nn.Embedding(output_dim, self.embbed_dim)
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)
       self.out = nn.Linear(self.hidden_dim, output_dim)
       self.softmax = nn.LogSoftmax(dim=1)

   def forward(self, input, hidden):
# reshape the input to (1, batch_size)
       input = input.view(1, -1)
       embedded = F.relu(self.embedding(input))
       output, hidden = self.gru(embedded, hidden)
       prediction = self.softmax(self.out(output[0]))
       return prediction, hidden

class Seq2Seq(nn.Module):
   def __init__(self, encoder, decoder, device, MAX_LENGTH=MAX_LENGTH):
       super().__init__()

#initialize the encoder and decoder
       self.encoder = encoder
       self.decoder = decoder
       self.device = device

   def forward(self, source, target, teacher_forcing_ratio=0.5):
       input_length = source.size(0) #get the input length (number of words in sentence)
       batch_size = target.shape[1]
       target_length = target.shape[0]
       vocab_size = self.decoder.output_dim

#initialize a variable to hold the predicted outputs
       outputs = torch.zeros(target_length, batch_size, vocab_size).to(self.device)

#encode every word in a sentence
       for i in range(input_length):
           encoder_output, encoder_hidden = self.encoder(source[i])

#use the encoder's hidden layer as the decoder hidden
       decoder_hidden = encoder_hidden.to(device)

#add a token before the first predicted word
       decoder_input = torch.tensor([SOS_token], device=device)  # SOS

#topk is used to get the top K value over a list
#predict the output word from the current target word. If we enable the teaching force, then the next decoder input is the next word, else, use the decoder output highest value.
       for t in range(target_length):
           decoder_output, decoder_hidden = self.decoder(decoder_input, decoder_hidden)
           outputs[t] = decoder_output
           teacher_force = random.random() < teacher_forcing_ratio
           topv, topi = decoder_output.topk(1)
           input = (target[t] if teacher_force else topi)
           if(teacher_force == False and input.item() == EOS_token):
               break

       return outputs
Stap 3) Het model trainen
Het trainingsproces in Seq2seq-modellen begint met het omzetten van elk paar zinnen naar Tensors op basis van hun Lang-index. Ons sequence-to-sequence-model gebruikt SGD als optimizer en de NLLLoss-functie om de verliezen te berekenen. Het trainingsproces begint met het invoeren van een paar zinnen in het model om de juiste uitvoer te voorspellen. Bij elke stap wordt de uitvoer van het model vergeleken met de juiste woorden om de verliezen te bepalen en de parameters bij te werken. Omdat er 75000 iteraties worden gebruikt, genereert ons sequence-to-sequence-model 75000 willekeurige paren uit onze dataset.
teacher_forcing_ratio = 0.5

def clacModel(model, input_tensor, target_tensor, model_optimizer, criterion):
   model_optimizer.zero_grad()

   input_length = input_tensor.size(0)
   loss = 0
   epoch_loss = 0
   # print(input_tensor.shape)

   output = model(input_tensor, target_tensor)

   num_iter = output.size(0)
   print(num_iter)

#calculate the loss from a predicted sentence with the expected result
   for ot in range(num_iter):
       loss += criterion(output[ot], target_tensor[ot])

   loss.backward()
   model_optimizer.step()
   epoch_loss = loss.item() / num_iter

   return epoch_loss

def trainModel(model, source, target, pairs, num_iteration=20000):
   model.train()

   optimizer = optim.SGD(model.parameters(), lr=0.01)
   criterion = nn.NLLLoss()
   total_loss_iterations = 0

   training_pairs = [tensorsFromPair(source, target, random.choice(pairs))
                     for i in range(num_iteration)]

   for iter in range(1, num_iteration+1):
       training_pair = training_pairs[iter - 1]
       input_tensor = training_pair[0]
       target_tensor = training_pair[1]

       loss = clacModel(model, input_tensor, target_tensor, optimizer, criterion)

       total_loss_iterations += loss

       if iter % 5000 == 0:
           avarage_loss= total_loss_iterations / 5000
           total_loss_iterations = 0
           print('%d %.4f' % (iter, avarage_loss))

   torch.save(model.state_dict(), 'mytraining.pt')
   return model
Stap 4) Test het model
Het evaluatieproces van Seq2seq PyTorDe taak is om de modeluitvoer te controleren. Elk paar Sequence-to-Sequence-modellen wordt aan het model aangeboden en genereert de voorspelde woorden. Daarna bekijk je de hoogste waarde in elke uitvoer om de juiste index te vinden. Ten slotte vergelijk je deze om de voorspelling van ons model te vergelijken met de werkelijke zin.
def evaluate(model, input_lang, output_lang, sentences, max_length=MAX_LENGTH): with torch.no_grad(): input_tensor = tensorFromSentence(input_lang, sentences[0]) output_tensor = tensorFromSentence(output_lang, sentences[1]) decoded_words = [] output = model(input_tensor, output_tensor) # print(output_tensor) for ot in range(output.size(0)): topv, topi = output[ot].topk(1) # print(topi) if topi[0].item() == EOS_token: decoded_words.append('' ) break else: decoded_words.append(output_lang.index2word[topi[0].item()]) return decoded_words def evaluateRandomly(model, source, target, pairs, n=10): for i in range(n): pair = random.choice(pairs) print('source {}'.format(pair[0])) print('target {}'.format(pair[1])) output_words = evaluate(model, source, target, pair) output_sentence = ' '.join(output_words) print('predicted {}'.format(output_sentence))
Laten we nu beginnen met de training met Seq to Seq, met 75000 iteraties, 1 RNN-laag en een verborgen grootte van 512.
lang1 = 'eng'
lang2 = 'ind'
source, target, pairs = process_data(lang1, lang2)

randomize = random.choice(pairs)
print('random sentence {}'.format(randomize))

#print number of words
input_size = source.n_words
output_size = target.n_words
print('Input : {} Output : {}'.format(input_size, output_size))

embed_size = 256
hidden_size = 512
num_layers = 1
num_iteration = 100000

#create encoder-decoder model
encoder = Encoder(input_size, hidden_size, embed_size, num_layers)
decoder = Decoder(output_size, hidden_size, embed_size, num_layers)

model = Seq2Seq(encoder, decoder, device).to(device)

#print model
print(encoder)
print(decoder)

model = trainModel(model, source, target, pairs, num_iteration)
evaluateRandomly(model, source, target, pairs)
Zoals u kunt zien, komt onze voorspelde zin niet erg goed overeen, dus om een hogere nauwkeurigheid te krijgen, moet u met veel meer gegevens trainen en proberen meer iteraties en een aantal lagen toe te voegen met behulp van Sequence to Sequence Learning.
random sentence ['tom is finishing his work', 'tom sedang menyelesaikan pekerjaannya']
Input : 3551 Output : 4253
Encoder(
  (embedding): Embedding(3551, 256)
  (gru): GRU(256, 512)
)
Decoder(
  (embedding): Embedding(4253, 256)
  (gru): GRU(256, 512)
  (out): Linear(in_features=512, out_features=4253, bias=True)
  (softmax): LogSoftmax()
)
5000 4.0906
10000 3.9129
15000 3.8171
20000 3.8369
25000 3.8199
30000 3.7957
75000 3.7044
