
Hoe ontbrekende waarden (NA) in R te vervangen: na.omit & na.rm
 Redactie
⚡ Slimme samenvatting
Het onderdeel 'Vervangen van ontbrekende waarden in R' behandelt het detecteren van NA-waarden, het verwijderen van onvolledige rijen met `na.omit()` en het invullen ervan met het gemiddelde of de mediaan via `mutate()`. Deze handleiding gebruikt de Titanic-dataset, waarin zowel `age` als `fare` ontbrekende waarden bevatten.
Wat zijn ontbrekende waarden in R?
Ontbrekende waarden verschijnen wanneer een observatie geen geregistreerde waarde in een kolom heeft, of wanneer een niet-numerieke placeholder staat waar een getal zou moeten staan. Deze moeten worden verwijderd of vervangen voordat er berekeningen worden uitgevoerd, omdat de meeste R-functies NA retourneren zodra er een ontbrekende waarde aanwezig is.
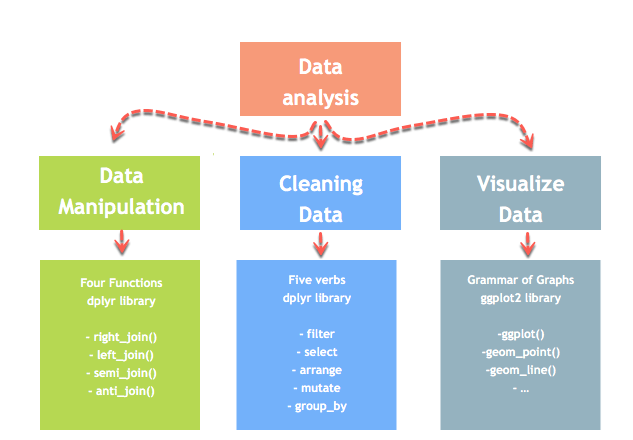
Deze handleiding laat zien hoe je omgaat met ontbrekende waarden met de dplyr-bibliotheek, onderdeel van het tidyverse-ecosysteem voor data-analyse.
De eerste stap is altijd om te achterhalen hoeveel waarden er ontbreken en waar.
Hoe ontbrekende waarden in R te detecteren en te tellen
Voordat je besluit wat je met ontbrekende waarden moet doen, moet je weten hoeveel er zijn en waar ze zich bevinden. R biedt vier controlemogelijkheden, van een simpel ja-of-nee-antwoord tot een volledige telling per kolom.
# 1. Is there any NA at all?
anyNA(df_titanic)

# 2. How many in total?
sum(is.na(df_titanic))

# 3. How many per column, the most useful view
colSums(is.na(df_titanic))

# 4. Percentage missing per column
round(colMeans(is.na(df_titanic)) * 100, 1)
De functie `colSums()` is in de praktijk de aangewezen functie. Deze retourneert een benoemde vector met één telling per kolom, waardoor direct duidelijk wordt of een variabele een aantal waarden mist of grotendeels leeg is.
Het tellen van complete rijen. complete.cases() retourneert TRUE voor rijen zonder ontbrekende waarden, wat je van tevoren vertelt hoeveel gegevens na.omit() zou negeren:
sum(complete.cases(df_titanic))       # rows that would survive
sum(!complete.cases(df_titanic))      # rows that would be dropped
Een waarschuwing over plaatsaanduidingen. R herkent alleen NA. Datasets coderen ontbrekende waarden vaak als een lege tekenreeks, een spatie, "N/A", "-" of een sentinel-getal zoals -99 of 999. Deze worden door alle bovenstaande controles onopgemerkt gelaten. Converteer ze bij het importeren, zodat de rest van de workflow correct werkt:
df <- read.csv(PATH, na.strings = c("", " ", "NA", "N/A", "-", "-99"))
Controleer na het importeren altijd het bereik van elke numerieke kolom. Een leeftijd van -99 of een tarief van 9999 is veel gevaarlijker dan een eerlijke 'NA', omdat geen enkele functie u daarvoor zal waarschuwen.
Soorten ontbrekende gegevens: MCAR, MAR en MNAR
De reden waarom een waarde ontbreekt, bepaalt of het veilig is om deze te imputeren. Statistici onderscheiden drie mechanismen.
- MCAR, volledig willekeurig ontbrekend. De kans dat iets ontbreekt, staat los van alles wat wel of niet is waargenomen, bijvoorbeeld een sensor die op willekeurige momenten uitvalt. Dropping Ofwel introduceert het invullen van deze rijen geen vertekening, maar alleen een verlies aan precisie.
- MAR staat voor Missing at Random (willekeurig ontbrekend). De waarschijnlijkheid hangt af van andere waargenomen variabelen, maar niet van de ontbrekende waarde zelf. Als de leeftijd van oudere passagiers minder vaak geregistreerd zou zijn, is de leeftijd MAR (Missing At Random) gegeven de andere kolommen. Imputatie die gebruikmaakt van die kolommen kan dit goed verwerken.
- MNAR, ontbrekend niet willekeurig. De waarschijnlijkheid hangt af van de niet-waargenomen waarde zelf, bijvoorbeeld dat hoogverdieners hun inkomen niet willen opgeven. Geen enkele imputatiemethode kan dit op basis van de gegevens alleen oplossen, en de ontbrekende waarde zelf bevat informatie die het waard is om in een kolom met markeringen vast te leggen.
Gemiddelde imputatie, zoals gebruikt in deze handleiding, is alleen te verdedigen onder MCAR en eenvoudige MAR. Zelfs dan zijn er bekende kosten aan verbonden: het vullen van elke lege plek met hetzelfde getal verkleint de variantie van de kolom en verzwakt de correlatie met alle andere gegevens. Voor serieuze analyses kunt u beter een modelgebaseerde methode gebruiken, zoals het mice-pakket, en altijd een kolom met vlaggen bijhouden die aangeeft welke waarden zijn geïmputeerd.
muteren()
mutate() is de dplyr Een werkwoord dat een nieuwe variabele aanmaakt of een bestaande overschrijft, waardoor het de ideale tool is om een opgeschoonde kopie van een kolom te maken.
We gaan in twee delen verder. We zullen leren hoe we:
- sluit ontbrekende waarden uit een dataframe uit
- impliceer ontbrekende waarden met het gemiddelde en de mediaan
Het werkwoord mutate() is heel makkelijk te gebruiken. We kunnen een nieuwe variabele maken volgens deze syntaxis:
mutate(df, name_variable_1 = condition, ...)
arguments:
-df: Data frame used to create a new variable
-name_variable_1: Name and the formula to create the new variable
-...: No limit constraint. Possibility to create more than one variable inside mutate()
Ontbrekende waarden (NA) uitsluiten
na.omit() is een standaardfunctie van R, geen dplyr-functie, maar het werkt desondanks prima. Het verwijdert elke rij die minstens één ontbrekende waarde bevat. Dat is de snelste optie, maar zelden de beste, omdat een enkele ontbrekende waarde de hele observatie verwijdert.
Om het probleem van ontbrekende waarnemingen aan te pakken, zullen we de Titanic-dataset gebruiken. In deze dataset hebben we toegang tot de informatie van de passagiers aan boord tijdens de tragedie. Deze dataset heeft veel NA waarvoor gezorgd moet worden.
Download het CSV-bestand van internet en geef vervolgens de kolommen weer die NA bevatten:
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/test.csv"
df_titanic <- read.csv(PATH, sep = ",")
# Return the column names containing missing observations
list_na <- colnames(df_titanic)[ apply(df_titanic, 2, anyNA) ]
list_na
Output:
## [1] "age" "fare"
Hier
colnames(df_titanic)[apply(df_titanic, 2, anyNA)]
Geeft de namen terug van de kolommen die ten minste één ontbrekende waarde bevatten.
In de kolommen leeftijd en tarief ontbreken waarden.
We kunnen ze neerzetten met de na.omit().
library(dplyr)
# Exclude the missing observations
df_titanic_drop <-df_titanic %>%
na.omit()
dim(df_titanic_drop)
Output:
## [1] 1045 13
De nieuwe dataset bevat 1045 rijen vergeleken met 1309 met de originele dataset.
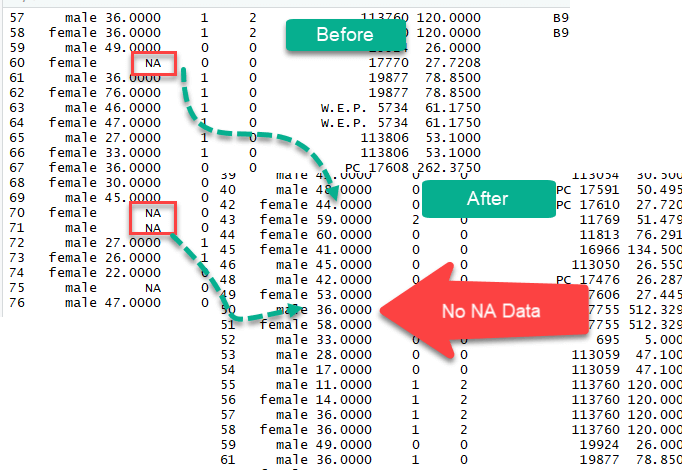
Vul ontbrekende gegevens aan met het gemiddelde en de mediaan.
Je kunt ontbrekende waarden ook invullen met het gemiddelde of de mediaan. Het is aan te raden om twee aparte variabelen aan te maken voor het gemiddelde en de mediaan. Zodra deze variabelen zijn aangemaakt, kun je de ontbrekende waarden vervangen door de nieuwe variabelen.
We zullen de methode Apply gebruiken om het gemiddelde van de kolom met NA te berekenen. Laten we een voorbeeld bekijken
Stap 1) Eerder in de zelfstudie hebben we de kolomnaam met de ontbrekende waarden opgeslagen in de lijst met de naam list_na. Wij zullen deze lijst gebruiken
Stap 2) Bereken het gemiddelde met het argument na.rm = TRUE. Dit argument is verplicht omdat de kolommen ontbrekende gegevens bevatten, en dit vertelt R om deze te negeren.
# Create mean
average_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      mean,
      na.rm =  TRUE)
average_missing
Code Uitleg:
We geven 4 argumenten door in de apply-methode.
- df: df_titanic[,colnames(df_titanic) %in% lijst_na]. Deze code retourneert de kolomnaam van het list_na-object (dwz "leeftijd" en "tarief")
- 2: Bereken de functie op de kolommen
- gemiddelde: Bereken het gemiddelde
- na.rm = TRUE: Negeer de ontbrekende waarden
Output:
##      age     fare
## 29.88113 33.29548
We hebben met succes het gemiddelde van de kolommen met ontbrekende waarnemingen gemaakt. Deze twee waarden zullen worden gebruikt om de ontbrekende waarnemingen te vervangen.
Stap 3) Vervang de NA-waarden
Het werkwoord muteren uit de dplyr-bibliotheek is handig bij het maken van een nieuwe variabele. We willen niet noodzakelijkerwijs de oorspronkelijke kolom wijzigen, zodat we een nieuwe variabele kunnen maken zonder de NA. muteren is gemakkelijk te gebruiken, we kiezen gewoon een variabelenaam en definiëren hoe deze variabele moet worden gemaakt. Hier is de volledige code
# Create a new variable with the mean and median
df_titanic_replace <- df_titanic %>%
   mutate(replace_mean_age  = ifelse(is.na(age), average_missing[1], age),
   replace_mean_fare = ifelse(is.na(fare), average_missing[2], fare))
Code Uitleg:
We maken als volgt twee variabelen, Replace_mean_age en Replace_mean_fare:
- Replace_mean_age = ifelse(is.na(leeftijd), gemiddelde_missing[1], leeftijd)
- vervangen_gemiddelde_tarief = ifelse(is.na(tarief), gemiddelde_missing[2],tarief)
Als er waarden ontbreken in de kolom 'leeftijd', vervang deze dan door het eerste element van 'average_missing' (gemiddelde van de leeftijd); anders behoudt u de oorspronkelijke waarden. Dezelfde logica voor het tarief
sum(is.na(df_titanic_replace$age))
Output:
## [1] 263
Na de vervanging bevat de nieuwe kolom helemaal geen ontbrekende waarden meer:
sum(is.na(df_titanic_replace$replace_mean_age))
Output:
## [1] 0
De oorspronkelijke kolom 'age' bevatte 263 ontbrekende waarden, terwijl de nieuwe kolom 'replace_mean_age' al deze waarden heeft aangevuld met de gemiddelde leeftijd.
Stap 4) We kunnen de ontbrekende waarnemingen ook vervangen door de mediaan.
median_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      median,
      na.rm =  TRUE)
df_titanic_replace <- df_titanic %>%
            mutate(replace_median_age  = ifelse(is.na(age), median_missing[1], age),
            replace_median_fare = ifelse(is.na(fare), median_missing[2], fare))
head(df_titanic_replace)
Output:

Stap 5) Bij een grote dataset wordt de stapsgewijze methode omslachtig. sapply() vat de hele procedure samen in één instructie, met als nadeel dat de ingevulde waarden nooit te zien zijn.
sapply creëert geen dataframe, zodat we de functie sapply() binnen data.frame() kunnen plaatsen om een dataframe-object te maken.
# Quick code to replace missing values with the mean
df_titanic_impute_mean <- data.frame(
    sapply(
        df_titanic,
        function(x) ifelse(is.na(x),
            mean(x, na.rm = TRUE),
            x)))
Moderne imputatie met replace_na() en across()
De bovenstaande methoden met `apply()` en `sapply()` werken nog steeds, maar `tidyr` en `dplyr` drukken dezelfde bewerkingen nu veiliger en leesbaarder uit.
replace_na() voor vaste waarden. tidyr::replace_na() neemt een benoemde lijst met kolommen en hun vervangingen als argumenten:
library(tidyr)

df_titanic %>%
    replace_na(list(age = 29.88, fare = 33.30))
across() voor elke numerieke kolom. Dit is de directe, typeveilige vervanging voor de sapply() one-liner, en in tegenstelling tot sapply() raakt het nooit teken- of factorkolommen aan:
library(dplyr)

# Mean-impute every numeric column
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), mean(.x, na.rm = TRUE), .x)))

# Median-impute instead
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), median(.x, na.rm = TRUE), .x)))
⚠️ Waarom de snelkoppeling sapply() riskant is: Het voorbeeld met één regel sapply() wordt uitgevoerd over elk kolom, inclusief tekenreeksen en factorkolommen. Het aanroepen van mean() op deze kolommen geeft NA met een waarschuwing, en sapply() zet het hele resultaat vervolgens om naar een tekenreeks. De bovenstaande versie met across(where(is.numeric), …) vermijdt dit volledig.
coalesce() voor fallback-kolommen. Als een tweede kolom de ontbrekende waarde kan aanvullen, retourneert coalesce() de eerste niet-ontbrekende waarde uit de argumenten:
df %>% mutate(age_final = coalesce(age, age_estimated, 0))
Houd bij wat je hebt veranderd. Voeg een vlag toe vóór de invoer, zodat elk later model kan leren van het feit dat er een waarde ontbrak:
df_titanic %>%
    mutate(age_was_missing = is.na(age),
           age = ifelse(is.na(age), mean(age, na.rm = TRUE), age))
Omgaan met ontbrekende waarden in R: Methodeoverzicht
In deze handleiding worden drie benaderingen behandeld:
- Sluit alle ontbrekende waarnemingen uit
- Imputeer met het gemiddelde
- Imputeer met de mediaan
Onderstaande tabel geeft een overzicht van de detectie en verwijdering:
| Bibliotheek | Objectief | Code |
|---|---|---|
| baseren | Maak een lijst van ontbrekende waarnemingen |
colnames(df)[apply(df, 2, anyNA)] |
| baseren | Verwijder alle rijen die NA bevatten. |
na.omit(df) |
Imputatie met gemiddelde of mediaan kan op twee manieren gebeuren
- Met behulp van toepassen
- Sapply gebruiken
| Methode | Details | Voordelen | Nadelen |
|---|---|---|---|
| Stap voor stap met toepassen | Controleer kolommen waarin ontbreken, bereken gemiddelde/mediaan, sla de waarde op, vervang door mute() | Je kunt het geschatte gemiddelde of de mediaan zien. | Meer uitvoeringstijd. Kan traag zijn met een grote dataset |
| Snelle manier met saply | Gebruik sapply() en data.frame() om ontbrekende waarden automatisch te zoeken en te vervangen door gemiddelde/mediaan | Korte code en snel | De toegewezen waarden worden nooit weergegeven. |
