
K-betekent ClusterProgrammeren in R met een voorbeeld
 Redactie
⚡ Slimme samenvatting
K-middelen ClusterIn R groepeert het algoritme observaties door de afstand tussen elk punt en het clustercentroid te minimaliseren. Deze stapsgewijze handleiding standaardiseert de dataset met computerprijzen, animeert het algoritme, vindt de optimale k met de elleboogmethode en visualiseert de clusters aan de hand van een heatmap.
Wat is Cluster analyse?
Cluster analyse behoort tot zonder toezicht leren. Een cluster is een groep gegevens die vergelijkbare kenmerken delen. We kunnen zeggen dat clusteranalyse meer over ontdekking dan over een voorspelling gaat. De machine zoekt naar overeenkomsten in de gegevens. U kunt bijvoorbeeld clusteranalyse gebruiken voor de volgende toepassing:
- Klantsegmentatie: zoekt naar overeenkomsten tussen groepen klanten
- Clustering van aandelenmarkten: Groepeer aandelen op basis van prestaties
- Verminder de dimensionaliteit van een dataset door te groeperenping waarnemingen met vergelijkbare waarden
ClusterDeze analyse is niet al te moeilijk te implementeren en is zowel betekenisvol als uitvoerbaar voor het bedrijfsleven.
Het meest opvallende verschil tussen begeleid en niet-gesuperviseerd leren ligt in de resultaten. Ongecontroleerd leren creëert een nieuwe variabele, het label, terwijl begeleid leren een resultaat voorspelt. De machine helpt de arts bij het labelen van de gegevens op basis van nauwe verwantschap. Het is aan de analist om gebruik te maken van de groepen en er een naam aan te geven.
Laten we een voorbeeld nemen om het concept van clustering te begrijpen. Voor de eenvoud werken we in twee dimensies. U hebt gegevens over de totale uitgaven van klanten en hun leeftijden. Om de reclame te verbeteren, wil het marketingteam meer gerichte e-mails naar hun klanten sturen.
In de onderstaande grafiek ziet u de totale bestedingen en de leeftijd van de klanten.
library(ggplot2)
df <- data.frame(age = c(18, 21, 22, 24, 26, 26, 27, 30, 31, 35, 39, 40, 41, 42, 44, 46, 47, 48, 49, 54),
    spend = c(10, 11, 22, 15, 12, 13, 14, 33, 39, 37, 44, 27, 29, 20, 28, 21, 30, 31, 23, 24)
)
ggplot(df, aes(x = age, y = spend)) +
    geom_point()

Op dit punt is een patroon zichtbaar
- Linksonder zie je jongeren met een lagere koopkracht
- Het hogere midden weerspiegelt mensen met een baan die ze zich kunnen veroorloven meer uit te geven
- Tenslotte ouderen met een lager budget.

In de bovenstaande afbeelding clustert u de observaties handmatig en definieert u elk van de drie groepen. Dit voorbeeld is vrij eenvoudig en zeer visueel. Als er nieuwe observaties aan de dataset worden toegevoegd, kunt u deze binnen de cirkels labelen. U definieert de cirkel op basis van ons oordeel. In plaats daarvan kunt u Machine leren om de gegevens objectief te groeperen.
In deze zelfstudie leert u hoe u de k-middelen algoritme.
K-Means-algoritme
K-means is de meest gebruikte clusteringmethode. Het algoritme stamt uit de jaren 1950 en is sindsdien vele malen verfijnd.
Het algoritme probeert groepen te vinden door de afstand tussen de waarnemingen zo klein mogelijk te maken lokaal optimaal oplossingen. De afstanden worden gemeten op basis van de coördinaten van de waarnemingen. In een tweedimensionale ruimte zijn de coördinaten bijvoorbeeld simpelweg x en y.
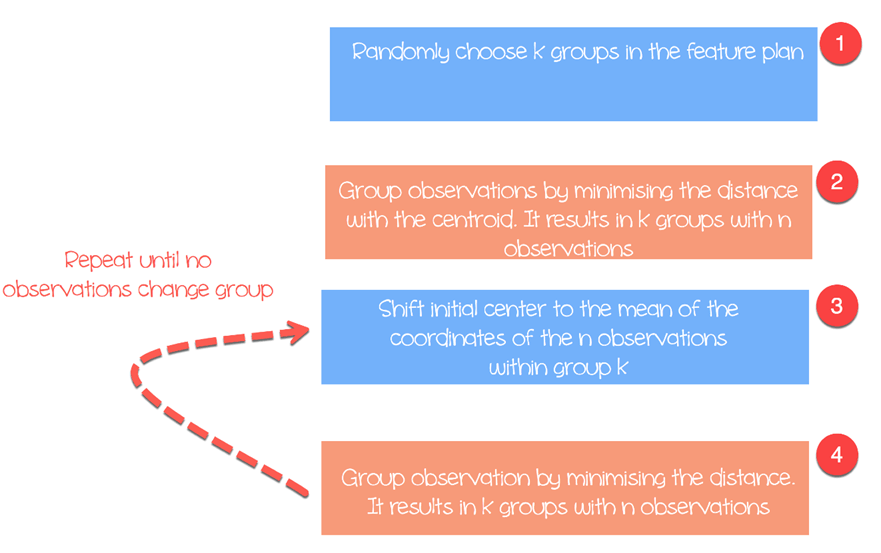
Het algoritme werkt als volgt:
- Stap 1: Kies willekeurig k begincentroïden in de kenmerkenruimte.
- Stap 2: Wijs elke observatie toe aan het dichtstbijzijnde clustercentrum, de zwaartepuntDit levert k groepen op.
- Stap 3: Shift het initiële zwaartepunt tot het gemiddelde van de coördinaten binnen een groep.
- Stap 4: Minimaliseer de afstand volgens de nieuwe zwaartepunten. Er worden nieuwe grenzen gecreëerd. Waarnemingen zullen dus van de ene groep naar de andere gaan
- Herhaal dit totdat geen enkele observatie van groep verandert
K-means meet normaal gesproken de Euclidische afstand tussen twee waarnemingen x en y:

Er zijn ook andere afstandsmaten beschikbaar, zoals de Manhattan- of Minkowski-afstand. Houd er rekening mee dat K-means elke keer dat je het algoritme uitvoert, andere groepen oplevert. Bedenk dat de eerste schattingen willekeurig zijn en dat de afstanden worden berekend totdat het algoritme homogeniteit binnen de groepen bereikt. Dat wil zeggen dat K-means erg gevoelig is voor de eerste keuze, en tenzij het aantal waarnemingen en groepen klein is, is het bijna onmogelijk om dezelfde clustering te krijgen.
Het aantal clusters selecteren
Een ander probleem bij k-means is de keuze van het aantal clusters. Je kunt een hoge waarde voor k kiezen, wat neerkomt op een groot aantal groepen, om de homogeniteit binnen de groepen te verbeteren, maar je loopt daarmee wel het risico op problemen. overfitting De data. Overfitting betekent dat de prestaties sterk afnemen bij nieuwe data, omdat het model de ruis in deze specifieke steekproef heeft onthouden in plaats van het onderliggende patroon.
Het aantal clusters hangt af van de aard van de dataset, de industrie, het bedrijf, enzovoort. Er is echter een vuistregel om het juiste aantal clusters te selecteren:

waarbij n het aantal waarnemingen in de dataset is.
In de praktijk loont het de moeite om tijd te besteden aan het zoeken naar de waarde van k die het beste aansluit bij de behoeften van het bedrijf.
We gebruiken de dataset Prices of Personal Computers om onze clusteranalyse uit te voeren. Deze dataset bevat 6259 observaties en 10 features. De dataset observeert de prijs van 1993 tot 1995 van 486 personal computers in de VS. De variabelen zijn onder andere prijs, snelheid, ram, scherm en cd.
U gaat als volgt te werk:
- Datums importeren
- Train het model
- Evalueer het model
Datums importeren
K-means is niet geschikt voor factorvariabelen, omdat het werkt met afstanden en discrete labels geen betekenisvolle afstand tot elkaar hebben. Verwijder de drie categorische kolommen (cd, multi, premium) samen met de rij-index X. Deze dataset bevat geen ontbrekende waarden.
library(dplyr)
PATH <-"https://raw.githubusercontent.com/guru99-edu/R-Programming/master/computers.csv"
df <- read.csv(PATH) %>%
select(-c(X, cd, multi, premium))
glimpse(df)
uitgang
## Observations: 6,259
## Variables: 7
## $ price <int> 1499, 1795, 1595, 1849, 3295, 3695, 1720, 1995, 2225, 2...
## $ speed <int> 25, 33, 25, 25, 33, 66, 25, 50, 50, 50, 33, 66, 50, 25, ...
## $ hd <int> 80, 85, 170, 170, 340, 340, 170, 85, 210, 210, 170, 210...
## $ ram <int> 4, 2, 4, 8, 16, 16, 4, 2, 8, 4, 8, 8, 4, 8, 8, 4, 2, 4, ...
## $ screen <int> 14, 14, 15, 14, 14, 14, 14, 14, 14, 15, 15, 14, 14, 14, ...
## $ ads <int> 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, ...
## $ trend  <int> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1...
Uit de samenvattende statistieken blijkt dat de gegevens grote waarden bevatten. Een goede gewoonte vóór elke op afstand gebaseerde methode is om de gegevens te standaardiseren, zodat elke variabele een vergelijkbare standaarddeviatie heeft. een gemiddelde van nul en een standaardafwijking van éénZonder die informatie zou de prijs, die in de duizenden loopt, de afstandsberekening domineren en zou de schermgrootte vrijwel geen rol spelen.
summary(df)
Output:
##      price          speed              hd              ram
##  Min.   : 949   Min.   : 25.00   Min.   :  80.0   Min.   : 2.000
##  1st Qu.:1794   1st Qu.: 33.00   1st Qu.: 214.0   1st Qu.: 4.000
##  Median :2144   Median : 50.00   Median : 340.0   Median : 8.000
##  Mean   :2220   Mean   : 52.01   Mean   : 416.6   Mean   : 8.287
##  3rd Qu.:2595   3rd Qu.: 66.00   3rd Qu.: 528.0   3rd Qu.: 8.000
##  Max.   :5399   Max.   :100.00   Max.   :2100.0   Max.   :32.000
##      screen           ads            trend
##  Min.   :14.00   Min.   : 39.0   Min.   : 1.00
##  1st Qu.:14.00   1st Qu.:162.5   1st Qu.:10.00
##  Median :14.00   Median :246.0   Median :16.00
##  Mean   :14.61   Mean   :221.3   Mean   :15.93
##  3rd Qu.:15.00   3rd Qu.:275.0   3rd Qu.:21.50
##  Max.   :17.00   Max.   :339.0   Max.   :35.00
U schaalt de variabelen opnieuw met de scale()-functie van de dplyr-bibliotheek. De transformatie vermindert de impact van uitschieters en maakt het mogelijk om een enkele waarneming te vergelijken met het gemiddelde. Als een gestandaardiseerde waarde (of z-score) hoog is, kunt u erop vertrouwen dat deze waarneming inderdaad boven het gemiddelde ligt (een grote z-score impliceert dat dit punt ver verwijderd is van het gemiddelde in termen van standaarddeviatie. Een z-score van twee geeft aan dat de waarde 2 standaard is afwijkingen van het gemiddelde. Let op: de z-score volgt een Gaussiaanse verdeling en is symmetrisch rond het gemiddelde.
# Note: speed is deliberately left out of the scaled data frame
rescale_df <- df %>%
    mutate(price_scal = scale(price),
    hd_scal = scale(hd),
    ram_scal = scale(ram),
    screen_scal = scale(screen),
    ads_scal = scale(ads),
    trend_scal = scale(trend)) %>%
select(-c(price, speed, hd, ram, screen, ads, trend))
R-basis heeft een functie om het k mean-algoritme uit te voeren. De basisfunctie van k mean is:
kmeans(df, k)
arguments:
-df: dataset used to run the algorithm
-k: Number of clusters
Train het model
In figuur drie heb je gedetailleerd uitgelegd hoe het algoritme werkt. Je kunt elke stap grafisch bekijken met het animatiepakket van Yihui Xie, die ook knitr voor R Markdown heeft gemaakt. Het pakket is niet beschikbaar in de conda-kanalen, dus installeer het via CRAN:
install.packages("animation")
Nadat u de bibliotheek hebt geladen, voegt u .ani toe na kmeans en R zal alle stappen plotten. Ter illustratie, u voert het algoritme alleen uit met de herschaalde variabelen hd en ram met drie clusters.
set.seed(2345)
library(animation)
kmeans.ani(rescale_df[2:3], 3)
Code Uitleg
- kmeans.ani(rescale_df[2:3], 3): Selecteer de kolommen 2 en 3 van de dataset rescale_df en voer het algoritme uit met k sets op 3. Teken de animatie.


Je kunt de animatie als volgt interpreteren:
- Stap 1: R kiest willekeurig drie punten
- Stap 2: Bereken de Euclidische afstand en teken de clusters. Je hebt één cluster in het groen linksonder, één groot cluster in het zwart rechts en een rood cluster ertussen.
- Stap 3: Bereken het zwaartepunt, d.w.z. het gemiddelde van de clusters
- Herhaal dit totdat er geen gegevens meer in het cluster zijn gewijzigd
Het algoritme convergeerde na zeven iteraties. U kunt het k-mean-algoritme in onze dataset uitvoeren met vijf clusters en het pc_cluster noemen.
pc_cluster <-kmeans(rescale_df, 5)
De lijst pc_cluster bevat zeven nuttige elementen:
- pc_cluster$cluster: Het cluster dat aan elke observatie is toegewezen
- pc_cluster$centers: De clustercentra
- pc_cluster$totss: De totale som van de kwadraten
- pc_cluster$withinss: Binnen de som van de kwadraten, één waarde per cluster
- pc_cluster$tot.withinss: De som van withinss
- pc_cluster$betweenss: Totale som van de kwadraten min de som van de kwadraten binnen de clusters
- pc_cluster$size: Aantal observaties binnen elk cluster
U zult de som van de binnenste som van kwadraten (d.w.z. tot.withinss) gebruiken om het optimale aantal clusters k te berekenen. Het vinden van k is inderdaad een substantiële taak.
Hoe vind je de optimale k met de elleboogmethode?
Eén techniek om de beste k te kiezen heet de elleboog methode:. Deze methode gebruikt binnen-groep homogeniteit of binnen-groep heterogeniteit om de variabiliteit te evalueren. Met andere woorden, u bent geïnteresseerd in het percentage van de variantie dat door elke cluster wordt verklaard. U kunt verwachten dat de variabiliteit toeneemt met het aantal clusters, of dat de heterogeniteit afneemt. Onze uitdaging is om de k te vinden die voorbij de afnemende opbrengsten ligt. Het toevoegen van een nieuw cluster verbetert de variabiliteit in de data niet omdat er maar heel weinig informatie overblijft om te verklaren.
In deze tutorial vinden we dit punt met behulp van de heterogeniteitsmaat. De Total within clusters sum of squares is de tot.withinss in de lijst die wordt geretourneerd door kmean().
Je kunt de ellebooggrafiek construeren en de optimale k als volgt vinden:
- Stap 1: Construeer een functie om de som van kwadraten binnen clusters te berekenen
- Stap 2: Voer het algoritme uit over een reeks k-waarden.
- Stap 3: Maak een dataframe met de resultaten van het algoritme
- Stap 4: Maak een grafiek van de resultaten
Stap 1) Maak een functie om de som van kwadraten binnen clusters te berekenen
Je maakt de functie die het k-mean-algoritme uitvoert en slaat het totaal op binnen de clusters som van kwadraten
kmean_withinss <- function(k) {
    cluster <- kmeans(rescale_df, k)
    return (cluster$tot.withinss)
}
Code Uitleg
- function(k): Stel het aantal argumenten in de functie in
- kmeans(rescale_df, k): Voer het algoritme uit voor deze waarde van k
- return(cluster$tot.withinss): Sla het totaal op binnen de clusters som van kwadraten
Test de functie met k gelijk aan 2.
Output:
## Try with 2 cluster
kmean_withinss(2)
Output:
## [1] 27087.07
Stap 2) Voer het algoritme n keer uit
U gebruikt de functie sapply() om het algoritme over een bereik van k uit te voeren. Deze techniek is sneller dan het maken van een lus en het opslaan van de waarde.
# Set maximum cluster
max_k <-20
# Run algorithm over a range of k
wss <- sapply(2:max_k, kmean_withinss)
Code Uitleg
- max_k <- 20: Stel de maximale waarde van k in op 20
- sapply(2:max_k, kmean_withinss): Voer de functie kmean_withinss() uit over een bereik van 2:max_k, dat wil zeggen 2 tot 20.
Stap 3) Maak een dataframe met de resultaten van het algoritme
Nadat de functie is geschreven en getest, voer je deze uit over het bereik van 2 tot 20 en sla je elke tot.within's waarde op.
# Create a data frame to plot the graph
elbow <-data.frame(2:max_k, wss)
Code Uitleg
- data.frame(2:max_k, wss): Maak een dataframe met de uitvoer van het algoritme-archief in wss
Stap 4) Plot de resultaten
Je tekent de grafiek om te visualiseren waar het elleboogpunt ligt
# Plot the graph with gglop
ggplot(elbow, aes(x = X2.max_k, y = wss)) +
    geom_point() +
    geom_line() +
    scale_x_continuous(breaks = seq(1, 20, by = 1))

Uit de grafiek kun je zien dat de optimale k zeven is, waarbij de curve een afnemend rendement begint te krijgen.
Zodra u de optimale k hebt, voert u het algoritme opnieuw uit met k gelijk aan 7 en evalueert u de clusters.
Het onderzoeken van de clusters
pc_cluster_2 <-kmeans(rescale_df, 7)
Zoals eerder vermeld, kunt u toegang krijgen tot de resterende interessante informatie in de lijst die wordt geretourneerd door kmean().
pc_cluster_2$cluster
pc_cluster_2$centers
pc_cluster_2$size
Evaluatie is subjectief en hangt af van het doel van de clusters. Het doel is hier om computers met vergelijkbare specificaties te groeperen. Een domeinexpert zou dit handmatig kunnen doen, maar dat proces zou traag en foutgevoelig zijn. K-means doet de groepering.ping objectief en laat het aan de expert over om het resultaat te interpreteren en te benoemen.
Als voorafgaande evaluatie kunt u de grootte van de clusters bekijken.
pc_cluster_2$size
Output:
## [1] 608 1596 1231 580 1003 699 542
De grootste cluster, nummer 2, bevat 1,596 waarnemingen, terwijl de kleinste, nummer 7, slechts 542 computers bevat. Homogeniteit tussen de clusters is wellicht wenselijk; zo niet, dan is mogelijk een minder grondige voorbereiding van de data nodig.
Met de centrale component krijg je een dieper inzicht in de gegevens. De rijen verwijzen naar de nummering van de clusters en de kolommen naar de variabelen die door het algoritme worden gebruikt. De waarden zijn de gemiddelde score per cluster voor de betreffende kolom. Standaardisatie maakt de interpretatie eenvoudiger. Positieve waarden geven aan dat de z-score voor een bepaalde cluster hoger is dan het algemene gemiddelde. Zo heeft cluster 4 de hoogste gemiddelde prijs (price_scal = 1.09), terwijl cluster 5 de laagste heeft (-0.82).
center <-pc_cluster_2$centers
center
Output:
##   price_scal    hd_scal     ram_scal screen_scal   ads_scal trend_scal
## 1 -0.6372457 -0.7097995 -0.691520682  -0.4401632  0.6780366 -0.3379751
## 2 -0.1323863  0.6299541  0.004786730   2.6419582 -0.8894946  1.2673184
## 3  0.8745816  0.2574164  0.513105797  -0.2003237  0.6734261 -0.3300536
## 4  1.0912296 -0.2401936  0.006526723   2.6419582  0.4704301 -0.4132057
## 5 -0.8155183  0.2814882 -0.307621003  -0.3205176 -0.9052979  1.2177279
## 6  0.8830191  2.1019454  2.168706085   0.4492922 -0.9035248  1.2069855
## 7  0.2215678 -0.7132577 -0.318050275  -0.3878782 -1.3206229 -1.5490909
U kunt met ggplot een heatmap maken om ons te helpen het verschil tussen categorieën te benadrukken.
De standaardkleuren van ggplot moeten worden gewijzigd met de RColorBrewer-bibliotheek. Je kunt de conda gebruiken en de code die in de terminal moet worden gestart:
conda install -c r r-rcolorbrewer
Om een heatmap te maken, gaat u in drie stappen te werk:
- Bouw een data frame met de waarden van het centrum en maak een variabele met het nummer van de cluster
- Geef de gegevens een nieuwe vorm met de functie collect() van de Tidyr-bibliotheek. U wilt gegevens transformeren van breed naar lang.
- Creëer het kleurenpalet met kleurRampPalet() functie
Stap 1) Bouw een dataframe
Laten we de hervormde gegevensset maken
library(tidyr)

# create dataset with the cluster number

cluster <- c(1: 7)
center_df <- data.frame(cluster, center)

# Reshape the data

center_reshape <- gather(center_df, features, values, price_scal: trend_scal)
head(center_reshape)
Output:
##   cluster   features     values
## 1       1 price_scal -0.6372457
## 2       2 price_scal -0.1323863
## 3       3 price_scal  0.8745816
## 4       4 price_scal  1.0912296
## 5       5 price_scal -0.8155183
## 6       6 price_scal  0.8830191
Stap 2) Maak het kleurenpalet aan
De onderstaande code bouwt het kleurenpalet op dat door de heatmap wordt gebruikt.
library(RColorBrewer)
# Create the palette
hm.palette <-colorRampPalette(rev(brewer.pal(10, 'RdYlGn')),space='Lab')
Stap 3) Visualiseer
U kunt de grafiek tekenen en zien hoe de clusters eruit zien.
# Plot the heat map
ggplot(data = center_reshape, aes(x = features, y = cluster, fill = values)) +
    scale_y_continuous(breaks = seq(1, 7, by = 1)) +
    geom_tile() +
    coord_equal() +
    scale_fill_gradientn(colours = hm.palette(90)) +
    theme_classic()

Hoe krijg je reproduceerbare K-Means-resultaten met set.seed() en nstart?
In de handleiding wordt vermeld dat k-means bij elke uitvoering andere groepen oplevert. Dat is geen eigenaardigheid waar je mee moet leren leven, maar een probleem met twee standaardoplossingen, en geen van beide wordt in de bovenstaande voorbeelden gebruikt.
1. Stel het startpunt vast met set.seed(). De initiële centroïden worden willekeurig getrokken, waardoor dezelfde aanroep elke keer andere clusters oplevert. Door een startwaarde (seed) in te stellen, wordt de hele analyse reproduceerbaar:
set.seed(123)
pc_cluster_2 <- kmeans(rescale_df, 7)
2. Voer meerdere starts uit en bewaar de beste met nstart. Een enkele willekeurige startwaarde kan convergeren naar een slecht lokaal optimum. Het argument nstart voert het algoritme zo vaak uit vanuit verschillende willekeurige startwaarden en retourneert de waarde met de laagste totale som van de kwadraten:
set.seed(123)
pc_cluster_2 <- kmeans(rescale_df, centers = 7, nstart = 25)
Vijfentwintig starts is de gebruikelijke aanbeveling en kost weinig bij een dataset van deze omvang. Zonder deze 25 starts wordt de elleboogcurve zelf instabiel, omdat elk punt in de grafiek afkomstig is van één enkele onfortuinlijke of gelukkige start. De eerder gedefinieerde functie kmean_withinss() moet daarom als volgt worden geschreven:
kmean_withinss <- function(k) {
    cluster <- kmeans(rescale_df, centers = k, nstart = 25)
    return (cluster$tot.withinss)
}
3. Roep iter.max aan als het algoritme een waarschuwing geeft. Als R meldt "niet geconvergeerd in 10 iteraties", geef dan iter.max = 50 door om het meer ruimte te geven.
K-Means versus hiërarchisch Clusterin R
K-means is niet de enige beschikbare clusteringmethode, en de keuze hangt meestal af van de omvang van de data en of je al weet hoeveel groepen je wilt hebben.
| criteria | K-middelen | hiërarchische |
|---|---|---|
| Aantal clusters | Moet van tevoren worden gekozen. | Gekozen nadat het dendrogram was doorgesneden. |
| Resultaatstabiliteit | Varieert afhankelijk van de willekeurige startwaarde. | deterministische |
| Schaalbaarheid | Kan zeer grote datasets verwerken. | Strijd die verder reikt dan een paar duizend rijen. |
| Cluster vorm | Gaat uit van ruwweg bolvormige groepen van vergelijkbare grootte. | flexibeler |
| uitgang | Een platte set etiketten | Een dendrogram dat een geneste structuur weergeeft |
| R-functie | kmeans(df, k) | hclust(dist(df)) |
# Hierarchical alternative on the same scaled data
hc <- hclust(dist(rescale_df), method = "ward.D2")
plot(hc)
groups <- cutree(hc, k = 7)
Met 6,259 waarnemingen moet hiërarchische clustering een afstandsmatrix van ongeveer 19.6 miljoen paren opbouwen, waardoor k-means de meest praktische keuze is voor deze dataset. Merk ook op dat k-means uitgaat van clusters van vergelijkbare grootte en een ruwweg bolvormige vorm; wanneer die aanname niet klopt, behandelt DBSCAN onregelmatige vormen en identificeert het uitschieters in plaats van elk punt in een groep te plaatsen.
K-middelen Clustering in R: Functiereferentie
Alle functies die in deze handleiding worden gebruikt, staan hieronder vermeld:
| Pakket | Objectief | Functie | Argument |
|---|---|---|---|
| baseren | Trein k-gemiddeld | kbetekent() | df, k |
| Toegangscluster | kmeans()$cluster | ||
| Cluster centra | kmeans()$centra | ||
| Cluster maten | kmeans()$grootte | ||
| Totaal binnen de som van de kwadraten | kmeans()$tot.withinss | Gebruikt volgens de elleboogmethode | |
| Tussen som van kwadraten | kmeans()$betweenss | ||
| baseren | Reproduceerbare run | set.seed() | zaadwaarde |
| baseren | Stabiliseer het resultaat | kmeans(df, k, nstart = 25) | nstart |
