
Python XML-bestand – Lezen, schrijven en parseren
 Anna Blake
⚡ Slimme samenvatting
Python Met XML-verwerking kunt u XML-documenten lezen, schrijven en parsen met behulp van de ingebouwde modules minidom en ElementTree. De minidom-klasse laadt een bestand in het geheugen als een DOM, terwijl ElementTree een snellere en efficiëntere methode biedt. Pythonic tree API.
De onderstaande paragrafen behandelen het parseren, schrijven en lezen van XML-bestanden in Python.
Wat is XML?
XML staat voor eXtensible Markup Language. Het is ontworpen om kleine tot middelgrote hoeveelheden gegevens op te slaan en te transporteren en wordt veel gebruikt voor het delen van gestructureerde informatie.
Python Hiermee kunt u XML-documenten parsen en wijzigen. Om een XML-document te parsen, moet het volledige XML-document in het geheugen aanwezig zijn. In deze tutorial laten we zien hoe we de XML minidom-klasse kunnen gebruiken. Python om XML-bestanden te laden en te parseren.
XML parseren met minidom
We hebben een voorbeeld-XML-bestand gemaakt dat we gaan parseren.
Stap 1) Maak een voorbeeld-XML-bestand
In het bestand kunnen we de voornaam, achternaam, huis en het expertisegebied zien (SQL, Python(testen en bedrijfsvoering).
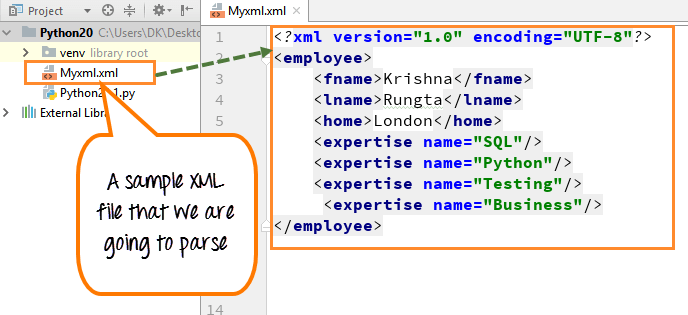
Stap 2) Gebruik de parse-functie om het XML-bestand te laden en te parseren
Nadat we het document hebben geparseerd, printen we de "node name" van de root van het document en de "firstchild tagname" af. Tagname en nodename zijn standaardeigenschappen van een XML-bestand.
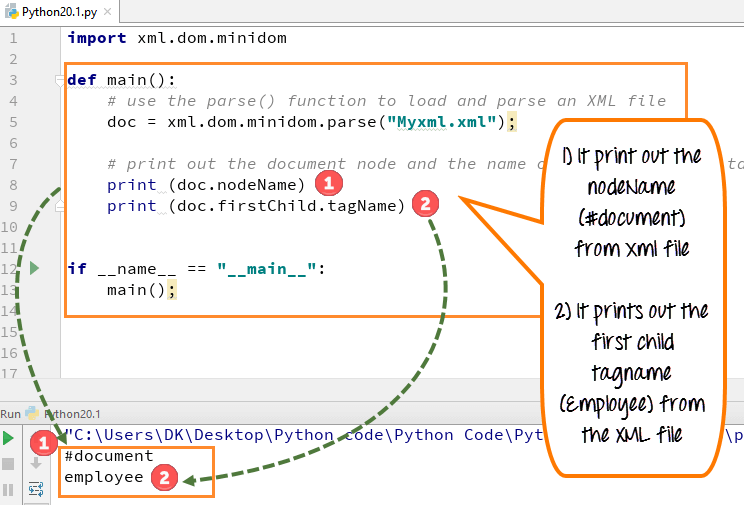
- Importeer de module xml.dom.minidom en geef het bestand op dat geparseerd moet worden (myxml.xml).
- Dit bestand bevat basisinformatie over een werknemer, zoals voornaam, achternaam, huis, expertise, enz.
- We gebruiken de parse-functie op de XML-minidom om het XML-bestand te laden en te parseren
- We hebben een variabele `doc`, en `doc` krijgt het resultaat van de `parse`-functie.
- We willen de knooppuntnaam en de tagnaam van het kindelement uit het bestand afdrukken, dus declareren we deze in de printfunctie.
- Voer de code uit. De knooppuntnaam (#document) wordt afgedrukt uit het XML-bestand en de eerste onderliggende tagnaam (werknemer) uit het XML-bestand
NoteNodename en child tagname zijn de standaardnamen of eigenschappen van een XML-DOM.
Stap 3) Roep de lijst met XML-tags uit het XML-document op en print deze.
Vervolgens kunnen we ook de lijst met XML-tags uit het XML-document opvragen en afdrukken. Hier hebben we de set vaardigheden zoals SQL afgedrukt. Python, Testen en zaken.

- Declareer de variabele expertise, van waaruit we gaan extracalle expertisegebieden van de medewerker
- Gebruik de dom-standaardfunctie genaamd “getElementsByTagName”
- Hiermee worden alle elementen met de naam vaardigheid verkregen
- Declareer een lus over elk van de vaardigheidstags.
- Voer de code uit - deze geeft een lijst met vier vaardigheden.
Hoe XML-knooppunt te schrijven
We kunnen een nieuw attribuut maken door de functie “createElement” te gebruiken en dit nieuwe attribuut of deze tag vervolgens aan de bestaande XML-tags toe te voegen. We hebben een nieuwe tag “BigData” toegevoegd aan ons XML-bestand.
- Je moet code schrijven om het nieuwe attribuut (BigData) toe te voegen aan de bestaande XML-tag.
- Vervolgens moet je de XML-tag afdrukken met het nieuwe attribuut toegevoegd aan de bestaande XML-tag.
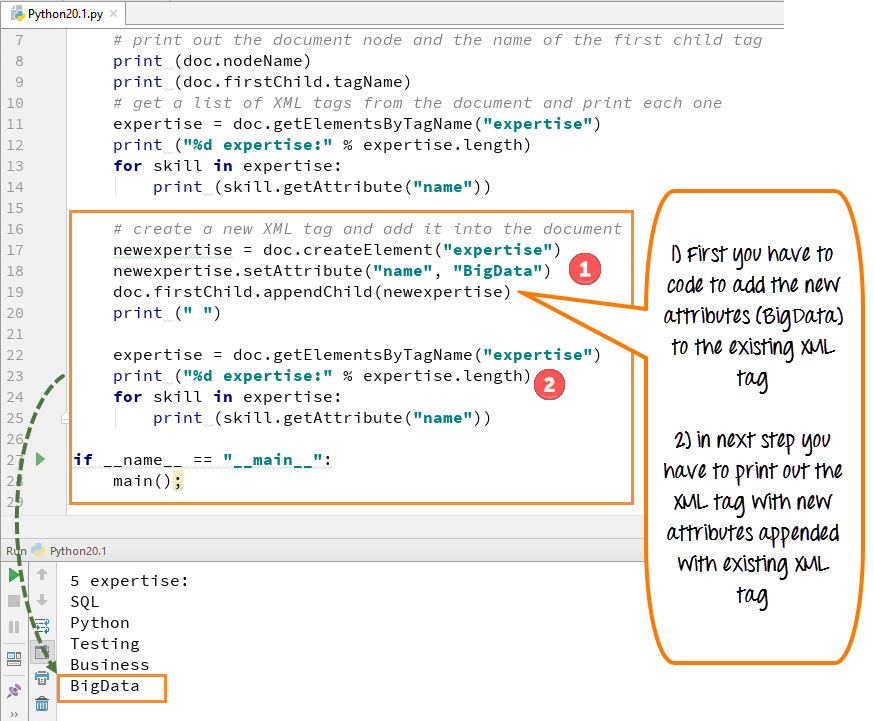
- Om een nieuwe XML-tag toe te voegen aan het document, gebruiken we de code "doc.createElement".
- Deze code maakt een nieuwe vaardigheidstag aan voor ons nieuwe attribuut "BigData".
- Voeg deze vaardigheidstag toe aan het eerste onderliggende element (medewerker) van het document.
- Voer de code uit; de nieuwe tag "BigData" verschijnt dan in de lijst met andere expertisegebieden.
Voorbeeld van XML-parser
Python 2 Voorbeeld
import xml.dom.minidom

def main():
# use the parse() function to load and parse an XML file
   doc = xml.dom.minidom.parse("Myxml.xml");

# print out the document node and the name of the first child tag
   print doc.nodeName
   print doc.firstChild.tagName

# get a list of XML tags from the document and print each one
   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

#Write a new XML tag and add it into the document
   newexpertise = doc.createElement("expertise")
   newexpertise.setAttribute("name", "BigData")
   doc.firstChild.appendChild(newexpertise)
   print " "

   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

if name == "__main__":
  main();
Python 3 Voorbeeld
import xml.dom.minidom

def main():
    # use the parse() function to load and parse an XML file
    doc = xml.dom.minidom.parse("Myxml.xml");

    # print out the document node and the name of the first child tag
    print (doc.nodeName)
    print (doc.firstChild.tagName)
    # get a list of XML tags from the document and print each one
    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

    # Write a new XML tag and add it into the document
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print (" ")

    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

if __name__ == "__main__":
    main();
Hoe XML te parseren met ElementTree
ElementTree is een API voor het manipuleren van XML. ElementTree biedt een eenvoudige manier om XML-bestanden te verwerken.
We gebruiken het volgende XML-document als voorbeeldgegevens:
<data>
   <items>
      <item name="expertise1">SQL</item>
      <item name="expertise2">Python</item>
   </items>
</data>
XML lezen met ElementTree:
We moeten eerst de module xml.etree.ElementTree importeren.
import xml.etree.ElementTree as ET
Laten we nu het hoofdelement ophalen:
root = tree.getroot()
Hieronder volgt de volledige code voor het lezen van de bovenstaande XML-gegevens:
import xml.etree.ElementTree as ET
tree = ET.parse('items.xml')
root = tree.getroot()

# all items data
print('Expertise Data:')

for elem in root:
   for subelem in elem:
      print(subelem.text)
Output:
Expertise Data:
SQL
Python
