
INDEX maken en neerzetten Cassandra
 David Carter
⚡ Slimme samenvatting
Index aanmaken en verwijderen in Cassandra Hiermee kunt u filteren op kolommen die geen deel uitmaken van de primaire sleutel. Deze pagina behandelt de opdrachten CREATE INDEX en DROP INDEX, de naamgevingsregels, de beschikbare indexsoorten en de gevallen waarin een index niet de juiste oplossing is.
Cassandra Index maken
Commando 'Index aanmaken' maakt een index aan op de door de gebruiker opgegeven kolom. Als de gegevens al bestaan voor de kolom die u wilt indexeren, Cassandra creëert indexen op de gegevens tijdens de uitvoering van de 'create index'-instructie.
- Nadat u een index hebt gemaakt, Cassandra indexeert nieuwe gegevens automatisch wanneer gegevens worden ingevoegd.
- De index kan niet op de primaire sleutel worden gemaakt, omdat er al een primaire sleutel is geïndexeerd.
- Indexen op collectiekolommen worden ondersteund, waarbij gebruik wordt gemaakt van de vorm KEYS, VALUES of ENTRIES, afhankelijk van wat er gezocht moet worden.
- Zonder indexering op de kolom, Cassandra Je kunt die kolom niet filteren, tenzij het een primaire sleutel is.
Daarom is het belangrijk om kolommen te filteren in CassandraEr moeten indexen worden aangemaakt.
Syntaxis
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
Voorbeeld
Hier is de momentopname waarin werd geprobeerd de kolom “dept” te filteren zonder de index te maken. Als reactie hierop werd de fout geretourneerd.

Hier is de momentopname waarin de index wordt gemaakt in de afd-kolom.

CREATE INDEX DeptIndex ON University.Student (dept);
Hier is de momentopname waarin de kolom 'dept' met succes wordt gefilterd.

SELECT * FROM University.Student WHERE dept = 'CS';
De indexnaam is optioneel. Als u deze weglaat, kunt u Cassandra Genereer er automatisch een, wat belangrijk is wanneer de index later moet worden verwijderd.
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra Dalingsindex
Commando 'Index verwijderen' verwijdert de opgegeven index. Als de indexnaam niet is opgegeven tijdens het maken van de index, is de indexnaam Tabelnaam_Kolomnaam_idx.
- Als de index niet bestaat, retourneert deze een fout, tenzij IF EXISTS wordt gebruikt, waardoor no-op wordt geretourneerd.
- Je moet de naam van de sleutelruimte samen met de indexnaam opgeven, anders wordt de index in de huidige sleutelruimte gezocht.
Syntaxis
DROP INDEX IF EXISTS KeyspaceName.IndexName;
Voorbeeld
Hier is de momentopname van het uitgevoerde commando 'Drop index' waarmee de index DeptIndex wordt verwijderd.
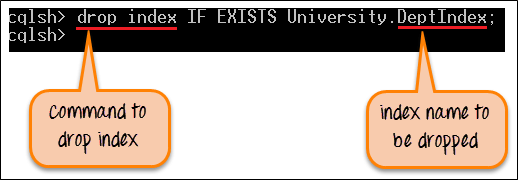
DROP INDEX IF EXISTS University.DeptIndex;
Na succesvolle uitvoering van de opdracht wordt DeptIndex uit de sleutelruimte verwijderd. Gegevens kunnen nu niet worden gefilterd door de kolomafdeling.
Om te bevestigen welke indexen bestaan voordat ze worden verwijderd.ping Ten eerste, beschrijf de tabel en lees de indexdefinities onderaan de uitvoer.
DESCRIBE TABLE University.Student;
Soorten indexen in Cassandra
Het bovenstaande commando creëert een standaard secundaire index, maar er bestaan drie verschillende mechanismen die zich heel verschillend gedragen.
| Type | Hoe werkt onze technologie? | Best voor |
|---|---|---|
| Secundaire index | Elk knooppunt indexeert alleen zijn eigen lokale gegevens, dus een query zonder partitiesleutel moet elk knooppunt benaderen. | Kolommen met een gemiddelde kardinaliteit worden opgevraagd in combinatie met een partitiesleutel. |
| SASI-index | Een bijgevoegde index die overeenkomsten met LIKE-prefixen en -suffixen ondersteunt, evenals numerieke bereiken. | Tekstzoekpatronen. Nog steeds gemarkeerd als experimenteel, dus test het voordat het in productie wordt genomen. |
| Opslaggeassocieerde index (SAI) | Geïntroduceerd in Cassandra 5.0, waarbij één indexstructuur over meerdere kolommen wordt gedeeld met lagere schrijfoverhead. | De moderne vervanging voor beide bovenstaande op Cassandra 5 clusters. |
Bij het indexeren van een kolom in een verzameling wordt een modifier gebruikt die aangeeft welk deel geïndexeerd moet worden.
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
VALUES doorzoekt de elementen van een set of lijst, KEYS doorzoekt sleutels in een map en ENTRIES koppelt een sleutel-waardepaar aan elkaar. Collectie-indexering wordt verder behandeld in de volgende sectie. Cassandra collecties tutorial.
Wanneer je geen index moet gebruiken in Cassandra
Een secundaire index is handig, maar het is geen relationele index, en het gebruik ervan op de verkeerde plaats is een veelvoorkomende oorzaak van trage clusters. Vier situaties vereisen een andere aanpak.
- Zeer hoge cardinaliteit. Het indexeren van iets dat vrijwel uniek is, zoals een e-mailadres, betekent dat bijna elke partitie één overeenkomende rij bevat, waardoor de query zich over het hele cluster verspreidt om één enkel record te retourneren.
- Zeer lage cardinaliteit. Het indexeren van een vlag met twee waarden, zoals actief of inactief, levert enorme indexpartities op, en het lezen van één partitie retourneert de helft van de tabel.
- Kolommen die regelmatig worden bijgewerkt. Elke wijziging schrijft een indexvermelding en een 'tombstone' voor de oude, waardoor de opeenhoping van 'tombstones' de leesprestaties na verloop van tijd verslechtert.
- Query's zonder partitiesleutel. Zonder een dergelijke coördinator moet de coördinator contact opnemen met elk knooppunt en de resultaten samenvoegen, wat niet schaalbaar is naarmate er meer knooppunten worden toegevoegd.
Het duurzame alternatief is een tweede tabel, geïndexeerd met de kolom waarop gezocht moet worden, die tegelijk met de eerste tabel wordt aangemaakt. Dit volgt het query-first principe dat beschreven staat in de Cassandra regels voor het datamodelEn het zorgt ervoor dat elke leesbewerking naar één enkele partitie op één enkele node gaat.
In de regel is een index geschikt voor een kolom met een gemiddelde kardinaliteit die wordt opgevraagd in combinatie met een bekende partitiesleutel. Voor alles wat hier niet aan voldoet, is een speciaal daarvoor ontworpen tabel een betere oplossing.
